Sesión 8 — Ingesta continua con Spark Structured Streaming
Esta sesión cierra el recorrido iniciado en S2. El alumnado ya sabe leer y escribir Parquet con Spark, organizar un data lake en zonas raw/silver/ gold, registrar tablas en un Metastore y gestionar una tabla Iceberg con snapshots, evolución y optimización medida. Todo ese trabajo, hasta ahora, ha sido por lotes: se materializa TPC-DS SF1 una vez y se procesa.
La pregunta central es:
¿Qué cambia cuando los datos no llegan de una vez, sino en tandas sucesivas que hay que ir incorporando sin volver a procesar todo lo anterior?
Esta sesión no introduce Kafka ni ningún otro sistema de mensajería: sería una pieza de infraestructura nueva y compleja para un beneficio docente pequeño en este punto del curso. En su lugar, un proceso simple simula la llegada periódica de pedidos nuevos escribiendo ficheros en la zona raw, y Spark Structured Streaming los recoge desde ahí con su propia fuente de ficheros: exactamente el mismo mecanismo de vigilancia de directorio que ya se ha usado en HDFS durante todo el curso, aplicado ahora de forma continua en vez de una sola vez.
Paquetes de Python de esta sesión. Esta sesión necesita
pyspark,trino,pandas,fsspec,pyarrow,requests. Respecto a S7 añadefsspec,pyarrow,requests. Se instalan en el kernel denamenodeen la sección «Instalar las dependencias de este notebook»: una celda%%writefile requirements.txtcrea el fichero dentro del contenedor —elrequirements.txtde tu copia des8/está en tu equipo ynamenodeno lo ve— y otra ejecuta%pip install -r requirements.txt. La imagen denamenodeya trae estos paquetes en su entorno Python del curso,/opt/tcdm/venv, que es el intérprete del kernel y donde instala%pip; lo normal es que%pipsólo confirme que están; ejecuta esas celdas de todos modos: dejan explícito qué necesita la sesión y reparan el entorno si falta algo.
Diapositivas de la sesión
Las diapositivas se generan con el paquete jupyter-notebook-slide.
El alias %%diapositiva permite mantener en español los tipos usados en la sesión y produce la misma salida HTML en Jupyter, Colab y la referencia HTML publicada.
En cada sesión encontrarás varios tipos de diapositivas que te ayudarán a seguir el hilo:
- Sección (
titulo): abre la sesión y resume qué vamos a ver y qué haremos. - A continuación (
avance): anuncia el contenido de la parte siguiente, para saber en qué punto del programa estamos. - Recapitulación (
resumen): condensa la parte anterior en puntos clave para recordarlos y revisarlos después. - Pregunta guía (
pregunta): plantea cuestiones que orientan lo que viene a continuación; conviene intentar responderlas antes de seguir. - Evaluación de la sesión (
evaluacion): recuerda cómo se evalúa el trabajo de esta sesión.
%pip install -q "jupyter-notebook-slide @ git+https://github.com/dsevilla/jupyter-notebook-slide.git"
%load_ext notebook_slide

import notebook_slide as jnbs

# Colores de 26-27/teoria/tcdm.css, adaptados al tema de las sesiones.
jnbs.configure(
    background="#eaf2f8",
    foreground="#1f2933",
    border="#c9d6e1",
    heading="#0c304d",
    subheading="#0c304d",
    link="#174f7a",
    code_background="#eaf2f8",
    code_foreground="#0c304d",
    quote_background="#ffffff",
    font_family="Atkinson Hyperlegible, Inter, Aptos, Segoe UI, Helvetica, Arial, sans-serif",
    font_url="https://fonts.googleapis.com/css2?family=Atkinson+Hyperlegible:ital,wght@0,400;0,700;1,400;1,700&display=swap",
)
jnbs.register_slide_type("avance", "A continuación", "#174f7a")
jnbs.register_slide_type("resumen", "Recapitulación", "#a54467")
jnbs.register_slide_type("pregunta", "Pregunta guía", "#0c304d")
jnbs.register_slide_type("evaluacion", "Evaluación de la sesión", "#b3701a")
jnbs.register_slide_type(
    "titulo",
    "Sección",
    "#174f7a",
    layout="title",
    background="linear-gradient(135deg, #0c304d, #174f7a 62%, #a54467)",
    foreground="#ffffff",
    border="transparent",
    heading="#ffffff",
    subheading="#dceaf4",
)
jnbs.register_alias("diapositiva")
Recorrido del curso
S2: Parquet como ficheros
  → S3: los mismos Parquet en un almacenamiento de objetos
  → S4: Spark procesa por lotes
  → S5: zonas raw/silver/gold y particionado físico
  → S6: catálogo Hive y Trino
  → S7: tabla Iceberg, evolución y optimización medida
  → S8: la misma tabla Iceberg, alimentada de forma continua
S8 no sustituye el recorrido por lotes: lo completa. La tabla Iceberg de S7 sigue siendo la tabla de referencia; esta sesión añade una segunda vía de escritura, incremental, que debe producir resultados de negocio coherentes con la vía por lotes.
Qué significa "streaming" aquí, y qué no
Conviene fijar el vocabulario antes de escribir código:
| Concepto | Significado en esta sesión | Lo que no es |
|---|---|---|
| Generador simulado | Proceso simple que escribe nuevos ficheros Parquet en una ruta raw de aterrizaje | Un sistema de colas o mensajería |
| Fuente de streaming | spark.readStream vigilando esa ruta y detectando ficheros nuevos |
Una conexión a un broker |
| Micro-lote (micro-batch) | Conjunto de filas nuevas que Structured Streaming procesa en una ejecución del disparador | Un evento individual procesado uno a uno |
| Disparador (trigger) | Cada cuánto tiempo, o con qué condición, se procesa un micro-lote | Un cron del sistema operativo |
Sink con foreachBatch |
Función que recibe el DataFrame de cada micro-lote y decide qué hacer con él | Una escritura directa fila a fila |
| Merge (Iceberg) | Operación MERGE INTO que inserta, actualiza o ignora filas según coincidan con la tabla destino |
Sobrescribir toda la tabla |
Spark Structured Streaming procesa datos no acotados como una sucesión de lotes pequeños, no evento a evento. Eso es exactamente lo que se necesita para ilustrar cómo pasar de raw a silver y de silver a gold sin volver a leer todo lo anterior en cada ejecución.
Objetivos de la sesión
Al terminar esta sesión deberías poder:
- explicar la diferencia entre procesamiento por lotes y por micro-lotes;
- crear un
readStreamsobre una ruta HDFS con la fuente de ficheros; - distinguir el esquema declarado explícitamente (obligatorio en streaming) de la inferencia de esquema usada en las sesiones por lotes;
- usar
foreachBatchpara aplicar una operación arbitraria —en este caso, dosMERGE INTO— a cada micro-lote, sin volver a leer todo el histórico cada vez; - explicar qué configuración necesita el catálogo Iceberg de Spark (tipo
hive, el mismo Hive Metastore que usa Trino) para queforeachBatchpueda escribir directamente eniceberg.tcdm.*; - escribir un
MERGE INTOSQL con Spark sobre una tabla Iceberg que inserte pedidos nuevos y actualice pedidos existentes en la misma operación; - distinguir los modos de escritura de Iceberg copy-on-write y merge-on-read, y observar su efecto físico (ficheros reescritos frente a ficheros de borrado);
- encadenar una actualización de silver con una actualización incremental de un agregado gold, sin recalcular todo el histórico;
- consultar el progreso de una consulta de streaming (
lastProgress, número de filas por micro-lote, tiempo de procesamiento); - detener una consulta de streaming de forma ordenada y explicar qué garantiza (y qué no) el checkpoint;
- comprobar que el resultado de negocio tras varias tandas incrementales coincide con el que daría un recálculo completo por lotes.
Antes de empezar
Dónde se ejecuta este notebook. Igual que en las sesiones anteriores, Jupyter se ejecuta directamente dentro del contenedor
namenode, comoluser, con acceso de red directo a HDFS, YARN y el Hive Metastore: todos comparten la misma red Dockerhadoop-cluster. Las celdas ejecutables hablan directamente con esos servicios. Las órdenes que necesitan el Docker del host — arrancar o detener contenedores,make— se muestran como texto para ejecutarlas en una terminal de tu equipo, nunca como celdas de este notebook.
Esta sesión asume que:
- el clúster de S1 ya está en marcha y el warehouse (PostgreSQL, Hive Metastore y Trino) de S6 también, porque el catálogo Iceberg de esta sesión usa el mismo Hive Metastore y las celdas de sólo lectura usan Trino;
- S2 generó los Parquet de TPC-DS SF1 en
/datalake/raw/tpcds, incluidasweb_sales,customer,customer_address,itemydate_dim; - S7 ya creó y pobló las dos tablas Iceberg que esta sesión alimenta de
forma continua:
iceberg.tcdm.web_sales(la silver a nivel de línea) yiceberg.tcdm.web_sales_by_year(el agregado gold). Esta sesión no las crea: las comprueba más abajo y falla pronto y con un mensaje claro si no existen o si su esquema no es el esperado.
Si el clúster o el warehouse no están levantados todavía, desde una terminal de tu equipo situada en la raíz de la distribución de sesiones:
cd ~/tcdm-public
git pull
make -C entorno warehouse-up
Este notebook se ejecuta en el Jupyter de namenode, que no arranca solo.
Como en S2, arráncalo desde otra terminal de tu equipo y déjala abierta
mientras trabajes:
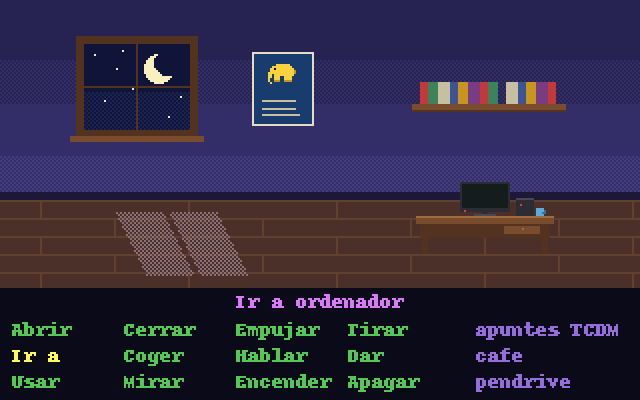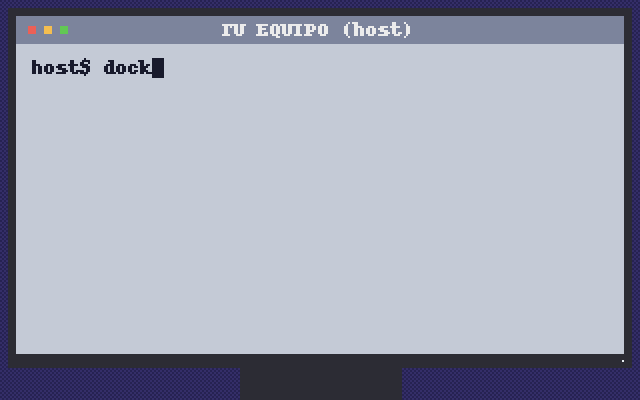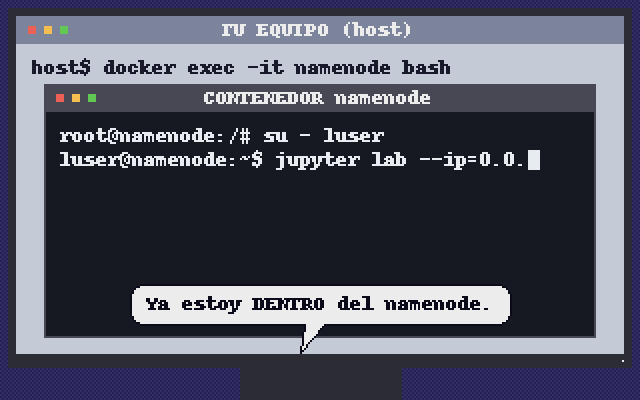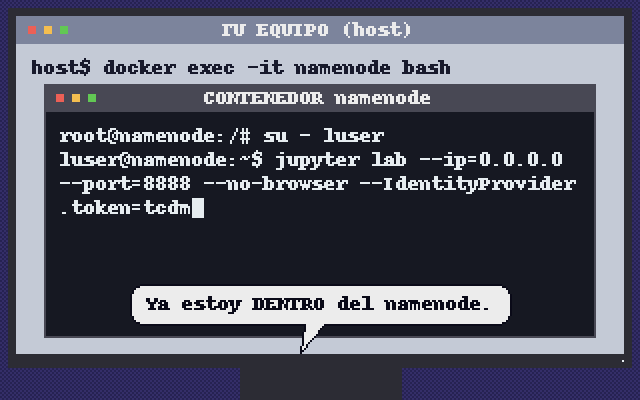
# en tu equipo: entra en namenode
docker exec -it namenode bash
# ya dentro de namenode, como luser: Jupyter con el token fijo «tcdm»
su - luser
jupyter lab --ip=0.0.0.0 --port=8888 --no-browser --IdentityProvider.token=tcdm
La primera orden es la única que se ejecuta en tu equipo; las otras dos, ya
dentro del contenedor, arrancan Jupyter con el Python del curso
(make -C entorno jupyter hace lo mismo en una sola orden). En Visual
Studio Code, conecta este notebook con Select Kernel → Select Another
Kernel → Existing Jupyter Server, usando la dirección
http://127.0.0.1:8888/lab?token=tcdm y eligiendo el kernel Python 3
(ipykernel). El token es siempre tcdm.
Si algo no funciona —el notebook no conecta, una celda !hdfs no
encuentra la orden, un servicio no responde—, consulta «Solución de
problemas» en entorno/README.md.
!hdfs dfs -ls -d \
    /datalake/raw/tpcds/web_sales \
    /datalake/raw/tpcds/customer \
    /datalake/raw/tpcds/customer_address \
    /datalake/raw/tpcds/item \
    /datalake/raw/tpcds/date_dim \
    /warehouse
Si alguna de esas rutas no aparece, revisa S2 antes de continuar: esta sesión no regenera TPC-DS. La comprobación de que S7 ya creó las tablas Iceberg llega un poco más abajo, en «Verificar que S7 ya creó las tablas Iceberg».
Instalar las dependencias de este notebook
El kernel de este notebook instala PySpark sobre sí mismo, igual que en las
sesiones anteriores, más el cliente trino de PyPI —el mismo de S6 y
S7—, que usaremos en varias celdas de sólo lectura como confirmación
independiente de lo que Spark escribe directamente en iceberg.tcdm.* (se
explica en la siguiente sección). El generador simulado que escribiremos y
ejecutaremos más abajo (generate_web_sales_batch.py) es un programa
aparte que habla con HDFS sólo por WebHDFS, con fsspec y PyArrow — el
mismo mecanismo que ya usaron los lectores de S2 —, así que sus
dependencias también viven en requirements.txt. La celda siguiente lo
recrea con %%writefile para que este notebook no dependa de ningún otro
fichero de la distribución, tanto si lo abres dentro de namenode como si
usas «Existing Jupyter Server» desde tu equipo.
%%writefile requirements.txt
# Dependencias del kernel interactivo de la sesión 8 (Spark local con un
# catálogo Iceberg de tipo hive, el mismo Hive Metastore que usa Trino). La
# serie de PySpark aceptada por el curso es >4,<4.2, igual que en S4, S5, S6
# y S7.
pyspark>4,<4.2
# Cliente DB-API 2.0 de Trino: se usa en las celdas de sólo lectura como
# comprobación independiente de lo que Spark escribe directamente en
# iceberg.tcdm.* dentro de foreachBatch (ver "Cómo configuramos el catálogo
# Iceberg de Spark" en el notebook). Se fija la serie mayor para que el
# tipado de columnas y la representación de valores no cambien entre
# ejecuciones.
trino>=0.330,<1
pandas
# generate_web_sales_batch.py habla con WebHDFS por fsspec y lee/escribe
# Parquet con PyArrow, igual que los lectores de la sesión 2; requests es
# la dependencia HTTP que usa fsspec para WebHDFS.
fsspec>=2026.2.0
pyarrow
requests
%pip install -q -r requirements.txt
import sys

import pandas
import pyspark
import trino

print(f"PySpark {pyspark.__version__} con Python {sys.version.split()[0]}.")
print(f"Cliente trino: {trino.__version__}")
print(f"Pandas: {pandas.__version__}")
Cómo configuramos el catálogo Iceberg de Spark
Esta sesión declara un catálogo Iceberg de Spark respaldado por Hive
Metastore, exactamente el mismo patrón que ya usan S6 (catálogo Hive
nativo) y S7 (catálogo Iceberg): spark.sql.catalog.iceberg de tipo
hive, apuntando al mismo thrift://hive-metastore:9083 que usa Trino. A
partir de esa configuración, Spark lee y escribe iceberg.tcdm.*
directamente con spark.sql(...): el MERGE INTO que cada micro-lote de
streaming ejecuta más abajo, en foreachBatch, lo hace Spark, sin ningún
motor ni tabla intermedios.
Spark habla con este catálogo con su cliente por defecto porque la versión
fijada del curso es Hive Metastore 3.1.3; la justificación completa está
en entorno/README.md, sección "Versiones fijadas y compatibilidad". El
resto de esta sesión usa spark.sql(...) para las dos operaciones que de
verdad importan aquí —el MERGE INTO hacia silver y hacia gold dentro
de foreachBatch— y sigue usando run_trino(...) en las celdas que sólo
leen, como comprobación independiente de que ambos motores ven exactamente
lo mismo.
Construir la SparkSession
from pyspark import SparkContext
from pyspark.sql import SparkSession

ICEBERG_VERSION: str = "1.11.0"
ICEBERG_RUNTIME_PACKAGE: str = (
    f"org.apache.iceberg:iceberg-spark-runtime-4.1_2.13:{ICEBERG_VERSION}"
)
HIVE_METASTORE_URIS: str = "thrift://hive-metastore:9083"
WAREHOUSE_DIR: str = "hdfs://namenode:9000/warehouse"

spark: SparkSession = (
    SparkSession.builder.appName("TCDM_S8_Streaming")
    .master("local[2]")
    .config("spark.driver.memory", "1g")
    .config("spark.sql.shuffle.partitions", "8")
    .config("spark.jars.packages", ICEBERG_RUNTIME_PACKAGE)
    .config(
        "spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
    )
    .config("spark.sql.catalog.iceberg", "org.apache.iceberg.spark.SparkCatalog")
    .config("spark.sql.catalog.iceberg.type", "hive")
    .config("spark.sql.catalog.iceberg.uri", HIVE_METASTORE_URIS)
    .config("spark.sql.catalog.iceberg.warehouse", WAREHOUSE_DIR)
    .getOrCreate()
)
sc: SparkContext = spark.sparkContext

print(f"Spark version: {spark.version} | Master: {sc.master}")
print(f"Paquete Iceberg: {ICEBERG_RUNTIME_PACKAGE}")
print(f"Catálogo Iceberg: iceberg (Hive Metastore {HIVE_METASTORE_URIS})")
Abrir la conexión con Trino
Reutilizamos exactamente el patrón de S6 y S7: el paquete trino de PyPI
habla el protocolo HTTP de Trino directamente contra el servicio
trino-hdfs de la red hadoop-cluster, sin CLI y sin docker exec. Esta
sesión no necesita a Trino para escribir —Spark ya lo hace directamente
contra iceberg.tcdm.*, con el catálogo que acabamos de configurar—, pero
sí lo usamos más abajo en varias celdas de sólo lectura: cuando
run_trino(...) devuelve una fila que Spark acaba de escribir, es la
confirmación de que un motor completamente independiente ve exactamente el
mismo dato.
import subprocess

import pandas as pd
import trino
from trino.dbapi import Connection, Cursor

trino_conn: Connection = trino.dbapi.connect(
    host="trino-hdfs",
    port=8080,
    user="luser",
    catalog="hive",
    schema="tcdm",
)


def run_trino(sql: str) -> pd.DataFrame:
    '''Ejecuta una sentencia en Trino y devuelve el resultado como DataFrame.'''
    cursor: Cursor = trino_conn.cursor()
    cursor.execute(sql)
    rows: list[tuple[object, ...]] = cursor.fetchall()
    columns: list[str] = [description[0] for description in cursor.description or []]
    return pd.DataFrame(rows, columns=columns)


print(f"Cliente trino: {trino.__version__}")
run_trino("SELECT 1 AS ping")
Verificar que S7 ya creó las tablas Iceberg
Antes de escribir una sola línea de streaming, comprobamos con Spark
—el motor que va a ejecutar los MERGE INTO reales en foreachBatch—
que las dos tablas del contrato de esta sesión existen en el catálogo
iceberg y tienen las columnas esperadas. Si esta comprobación falla, el
mensaje debe bastar para saber que hay que ejecutar S7 antes de continuar,
en vez de fallar más adelante con un error críptico de MERGE INTO.
def described_columns(table_name: str) -> dict[str, str]:
    '''Convertir el esquema de Spark de una tabla en un diccionario columna -> tipo.'''
    assert spark.catalog.tableExists(
        table_name
    ), f"No existe {table_name}. ¿Se ha ejecutado S7 antes que esta sesión?"
    return {field.name: field.dataType.simpleString() for field in spark.table(table_name).schema}


web_sales_columns: dict[str, str] = described_columns("iceberg.tcdm.web_sales")
for name, data_type in web_sales_columns.items():
    print(f"{name}: {data_type}")
expected_web_sales_columns: set[str] = {
    "ws_order_number",
    "ws_item_sk",
    "ws_bill_customer_sk",
    "ws_bill_addr_sk",
    "ws_sold_date_sk",
    "ws_sold_date",
    "ws_quantity",
    "ws_list_price",
    "ws_ext_discount_amt",
    "ws_ext_sales_price",
    "ws_net_paid",
    "ws_net_profit",
    "sold_year",
    "sold_month",
}
missing_web_sales_columns: set[str] = expected_web_sales_columns - set(web_sales_columns)
assert not missing_web_sales_columns, (
    "Faltan columnas en iceberg.tcdm.web_sales: "
    f"{missing_web_sales_columns}. ¿Se ha ejecutado S7 antes que esta sesión?"
)
print("iceberg.tcdm.web_sales tiene todas las columnas del contrato de S8.")
web_sales_by_year_columns: dict[str, str] = described_columns("iceberg.tcdm.web_sales_by_year")
print(web_sales_by_year_columns)

expected_gold_columns: set[str] = {"d_year", "pedidos", "lineas_de_venta", "beneficio_neto"}
missing_gold_columns: set[str] = expected_gold_columns - set(web_sales_by_year_columns)
assert not missing_gold_columns, (
    "Faltan columnas en iceberg.tcdm.web_sales_by_year: "
    f"{missing_gold_columns}. ¿Se ha ejecutado S7 antes que esta sesión?"
)
print("iceberg.tcdm.web_sales_by_year tiene todas las columnas del contrato de S8.")
Por último, inspeccionamos el CREATE TABLE real de iceberg.tcdm.web_sales
—esta vez con spark.sql(...), el mismo catálogo que va a escribir en
ella— para ver, sin adivinarlo, cómo particionó S7 la tabla. Debe aparecer
una transformación oculta de Iceberg sobre ws_sold_date (por ejemplo,
month(ws_sold_date)) en vez de columnas de partición visibles como las de
la tabla Hive de S6.
create_table_web_sales: str = spark.sql("SHOW CREATE TABLE iceberg.tcdm.web_sales").collect()[0][0]
print(create_table_web_sales)
Arquitectura de la sesión
Generador simulado (Python, se ejecuta varias veces)
        │  escribe ficheros Parquet nuevos
        ▼
/datalake/raw/streaming/web_sales_incremental/batch-<id>.parquet
        │  spark.readStream.format("parquet")
        ▼
Micro-lote de Structured Streaming (Spark)
        │  foreachBatch: vista temporal + MERGE INTO (Spark, catálogo iceberg)
        ▼
iceberg.tcdm.web_sales           (ya creada en S7)
        │  mismo foreachBatch: segundo MERGE INTO (Spark)
        ▼
iceberg.tcdm.web_sales_by_year   (ya creada en S7)
Spark orquesta el streaming y escribe directamente en iceberg.tcdm.*: no
hay ningún motor ni tabla intermedios. El generador y la consulta de
streaming siguen siendo procesos independientes que se coordinan
únicamente a través de la ruta de aterrizaje en HDFS, igual que antes.
El generador simulado
generate_web_sales_batch.py construye, cada vez que se ejecuta, un lote de
líneas de venta web sintéticas y lo escribe como un fichero Parquet nuevo
bajo la ruta de aterrizaje, con un nombre (marca de tiempo + UUID corto) que
no se repite entre ejecuciones. No usa Spark: habla con HDFS sólo por
WebHDFS con fsspec y PyArrow, igual que los lectores de S2.
web_sales es una tabla a nivel de línea, no de pedido: su clave real
es el par (ws_order_number, ws_item_sk), no ws_order_number en
solitario, porque un mismo pedido puede tener varias líneas con productos
distintos. El generador calcula, antes de fabricar ninguna fila, los rangos
reales de c_customer_sk, ca_address_sk e i_item_sk (con PyArrow, sobre
los Parquet reales de customer, customer_address e item) y lee de
date_dim las fechas del periodo real de ventas de web_sales, que empieza
en 1998 — así las claves generadas siguen siendo coherentes con las tablas
de dimensión, sin inventar rangos, y las líneas nuevas caen en los mismos
años que las ventas que ya existen.
Cada lote mezcla dos tipos de líneas:
- correcciones, que reutilizan un par
(ws_order_number, ws_item_sk)muestreado delweb_salesreal de S2 (ya presente en la tabla Iceberg desde que S7 la materializó) con importes nuevos: es la parte "update" delMERGE; - altas, con un par
(ws_order_number, ws_item_sk)nuevo que no puede colisionar con ningún pedido real (los números de pedido de alta parten de una base muy por encima del rango real de TPC-DS SF1): es la parte "insert".
La fracción de correcciones se controla con --update-fraction (0.3 por
defecto). Ejecutamos el generador una primera vez para inspeccionar lo que
produce, antes de construir la consulta de streaming.
El generador es un fichero de la sesión (s8/generate_web_sales_batch.py),
pero este notebook se ejecuta dentro de namenode, que no ve tu copia de la
distribución. La celda siguiente lo descarga del repositorio público
dsevilla/tcdm-public (rama 26-27) al directorio de trabajo del kernel,
igual que la sesión 3 descarga sus programas. Si el fichero ya está ahí
—por ejemplo, porque lo has copiado tú—, se conserva.
from pathlib import Path
from urllib.request import Request, urlopen

GENERATOR: Path = Path("generate_web_sales_batch.py")
generator_url: str = (
    "https://raw.githubusercontent.com/dsevilla/tcdm-public/26-27/s8/generate_web_sales_batch.py"
)

if GENERATOR.exists():
    print(f"{GENERATOR} ya está en {Path.cwd()}; se conserva.")
else:
    request: Request = Request(generator_url, headers={"User-Agent": "Mozilla/5.0"})
    with urlopen(request, timeout=30) as response:
        GENERATOR.write_bytes(response.read())
    print(f"Descargado {GENERATOR} en {Path.cwd()}")
import json

first_run: subprocess.CompletedProcess[str] = subprocess.run(
    ["python", "generate_web_sales_batch.py", "--rows", "150"],
    capture_output=True,
    text=True,
    check=True,
)
print(first_run.stdout)

first_report: dict[str, object] = json.loads(
    first_run.stdout.strip().splitlines()[-1].split("\t", 1)[1]
)
batch_reports: list[dict[str, object]] = [first_report]
print(first_report)
LANDING_PATH: str = "/datalake/raw/streaming/web_sales_incremental"
print(f"Ruta de aterrizaje: {LANDING_PATH}")
!hdfs dfs -ls {LANDING_PATH}
El fichero que aparece en el listado es el que acabamos de escribir: su
nombre incluye la marca de tiempo y un fragmento de UUID, así que volver a
ejecutar el generador no lo sobrescribe. first_report trae, entre otras
cosas, la ruta exacta del fichero (batch_path) y las claves
(ws_order_number, ws_item_sk) que ha usado para las correcciones y para
una muestra de las altas — las usaremos más abajo para enseñar una fila
insertada y una fila corregida por el mismo MERGE, en vez de adivinarlas.
La consulta de streaming
A diferencia de la lectura por lotes de S4/S5 (spark.read.parquet(...)),
aquí declaramos el esquema del readStream a mano: Spark podría inferirlo
leyendo una muestra, pero esa inferencia no es fiable en un flujo continuo
—depende de qué ficheros haya presentes en cada arranque y puede cambiar
entre ejecuciones—, así que se declara explícitamente en vez de encarecer
y fragilizar el arranque. Declaramos el mismo esquema que ya construye el
generador, columna a columna.
from pyspark.sql.types import (
    DateType,
    DecimalType,
    IntegerType,
    LongType,
    StructField,
    StructType,
)

web_sales_incremental_schema: StructType = StructType(
    [
        StructField("ws_order_number", LongType(), nullable=False),
        StructField("ws_item_sk", LongType(), nullable=False),
        StructField("ws_bill_customer_sk", LongType(), nullable=True),
        StructField("ws_bill_addr_sk", LongType(), nullable=True),
        StructField("ws_sold_date_sk", LongType(), nullable=True),
        StructField("ws_sold_date", DateType(), nullable=True),
        StructField("ws_quantity", IntegerType(), nullable=True),
        StructField("ws_list_price", DecimalType(7, 2), nullable=True),
        StructField("ws_ext_discount_amt", DecimalType(7, 2), nullable=True),
        StructField("ws_ext_sales_price", DecimalType(7, 2), nullable=True),
        StructField("ws_net_paid", DecimalType(7, 2), nullable=True),
        StructField("ws_net_profit", DecimalType(7, 2), nullable=True),
        StructField("sold_year", IntegerType(), nullable=True),
        StructField("sold_month", IntegerType(), nullable=True),
    ]
)
from pyspark.sql import DataFrame

raw_stream: DataFrame = (
    spark.readStream.format("parquet").schema(web_sales_incremental_schema).load(LANDING_PATH)
)

print("readStream configurado sobre:", LANDING_PATH)
raw_stream no ha leído ninguna fila todavía: como en las transformaciones
por lotes de S4, es perezoso. Lo que sí ha hecho es fijar el esquema y la
ruta que vigilará la fuente de ficheros una vez arranque la consulta.
foreachBatch: vista temporal + dos MERGE INTO
La función hace, en este orden:
- Registra el micro-lote como vista temporal (
micro_batch_src) concreateOrReplaceTempView: es lo único que hace falta para quespark.sql(...)pueda referenciarlo como origen de unMERGE INTO. - Antes de fusionar nada, pregunta —con
spark.sql(...), contra el mismo catálogoiceberg— qué año (sold_year) tenía ya cada clave que el micro-lote va a tocar, cruzando la vista temporal coniceberg.tcdm.web_salestal y como está antes delMERGE. Es necesario porque el generador simulado reasigna una fecha nueva y aleatoria, dentro del periodo real de ventas, a cada fila que fabrica, tanto si es una corrección como si es un alta (lo comprobarás si leesgenerate_web_sales_batch.py): una corrección puede mover una línea de venta real de, por ejemplo, 2001 a 1999. Sitouched_yearssólo contuviera el año nuevo de esa fila, elMERGEde gold recalcularía 1999 (correcto) pero nunca volvería a tocar 2001 —el año que la fila acaba de abandonar—, y el agregado de 2001 se quedaría con una fila fantasma para siempre. - Fusiona
micro_batch_srccontraiceberg.tcdm.web_sales, con la clave compuesta real de la tabla (ws_order_numberyws_item_sk): un mismo micro-lote puede traer altas y correcciones a la vez, sin que el programa tenga que distinguirlas de antemano. Como la vista temporal tiene exactamente las mismas columnas que la tabla, elMERGEpuede usar la abreviatura de la extensión de Iceberg en Spark SQL,UPDATE SET */INSERT *, en vez de listar las catorce columnas a mano. - Fusiona
iceberg.tcdm.web_sales_by_year, recalculando sólo la unión de los años que el micro-lote toca ahora y los años que las filas corregidas tenían antes —no toda la tabla—, a partir de la propiaiceberg.tcdm.web_salesya actualizada por el paso anterior. Esta vez la fuente delMERGEno es una vista sobre el micro-lote: es una subconsulta con una tabla de valores literal (VALUES ...) y una agregación directa sobreiceberg.tcdm.web_sales.
Un año tocado puede quedarse sin ninguna fila (si la única línea que tenía
se corrigió hacia otro año): la subconsulta de origen incluye explícitamente
todos los años tocados, con COALESCE(..., 0) para los que ya no tienen
filas, y el MERGE borra la fila de gold correspondiente
(WHEN MATCHED AND source.lineas_de_venta = 0 THEN DELETE) en lugar de
dejarla obsoleta. Sin este DELETE, el MERGE no tocaría esa fila porque
no la evaluaría en absoluto: sólo compara filas que sí aparecen en la
subconsulta de origen, y una consulta sin COALESCE que agrupe únicamente
lo que queda en web_sales no produciría ninguna fila para un año vacío.
def merge_into_silver_and_gold(micro_batch_df: DataFrame, batch_id: int) -> None:
    '''Aplicar un micro-lote de streaming a la silver y a la gold Iceberg.

    Spark ejecuta aquí los dos MERGE INTO directamente contra el catálogo
    iceberg (Hive Metastore), el mismo que ya verificamos más arriba: no hay
    ningún motor ni tabla intermedios.
    '''

    if micro_batch_df.isEmpty():
        print(f"[foreachBatch] Micro-lote {batch_id}: 0 filas, nada que fusionar.")
        return

    # foreachBatch entrega micro_batch_df con su propia SparkSession "clonada":
    # aunque comparte el mismo catálogo que la sesión global `spark`, es un
    # objeto Python distinto, y una vista temporal es visible sólo dentro de
    # la sesión que la registró. Por eso todo este cuerpo usa
    # `batch_spark`, obtenida del propio DataFrame, en vez de la variable
    # global `spark` capturada por el closure.
    batch_spark: SparkSession = micro_batch_df.sparkSession

    row_count: int = micro_batch_df.count()
    print(f"[foreachBatch] Micro-lote {batch_id}: {row_count} filas recibidas.")

    micro_batch_df.createOrReplaceTempView("micro_batch_src")

    # Años que las claves de este micro-lote tenían ANTES del MERGE: hace
    # falta capturarlos ahora, antes de fusionar, porque una corrección
    # puede cambiar el año de una fila (ver la celda anterior).
    previous_years_df: DataFrame = batch_spark.sql('''
        SELECT DISTINCT target.sold_year AS sold_year
        FROM iceberg.tcdm.web_sales AS target
        JOIN micro_batch_src AS source
          ON target.ws_order_number = source.ws_order_number
             AND target.ws_item_sk = source.ws_item_sk
        ''')
    previous_years: set[int] = {row["sold_year"] for row in previous_years_df.collect()}

    batch_spark.sql('''
        MERGE INTO iceberg.tcdm.web_sales AS target
        USING micro_batch_src AS source
        ON target.ws_order_number = source.ws_order_number
           AND target.ws_item_sk = source.ws_item_sk
        WHEN MATCHED THEN UPDATE SET *
        WHEN NOT MATCHED THEN INSERT *
        ''')

    new_years: set[int] = {
        row["sold_year"] for row in micro_batch_df.select("sold_year").distinct().collect()
    }
    touched_years: list[int] = sorted(previous_years | new_years)
    years_list_sql: str = ", ".join(str(year) for year in touched_years)
    years_values_sql: str = ", ".join(f"({year})" for year in touched_years)
    print(f"[foreachBatch] Micro-lote {batch_id}: años tocados = {touched_years}")

    batch_spark.sql(f'''
        MERGE INTO iceberg.tcdm.web_sales_by_year AS target
        USING (
            SELECT year_list.sold_year AS d_year,
                   COALESCE(agg.pedidos, 0) AS pedidos,
                   COALESCE(agg.lineas_de_venta, 0) AS lineas_de_venta,
                   COALESCE(agg.beneficio_neto, 0) AS beneficio_neto
            FROM (VALUES {years_values_sql}) AS year_list (sold_year)
            LEFT JOIN (
                SELECT sold_year,
                       count(DISTINCT ws_order_number) AS pedidos,
                       count(*) AS lineas_de_venta,
                       sum(ws_net_profit) AS beneficio_neto
                FROM iceberg.tcdm.web_sales
                WHERE sold_year IN ({years_list_sql})
                GROUP BY sold_year
            ) AS agg ON year_list.sold_year = agg.sold_year
        ) AS source
        ON target.d_year = source.d_year
        WHEN MATCHED AND source.lineas_de_venta = 0 THEN DELETE
        WHEN MATCHED THEN UPDATE SET
            pedidos = source.pedidos,
            lineas_de_venta = source.lineas_de_venta,
            beneficio_neto = source.beneficio_neto
        WHEN NOT MATCHED AND source.lineas_de_venta > 0 THEN INSERT (d_year, pedidos, lineas_de_venta, beneficio_neto)
            VALUES (source.d_year, source.pedidos, source.lineas_de_venta, source.beneficio_neto)
        ''')
El segundo MERGE es la diferencia práctica entre mantener un agregado de
forma incremental y recalcularlo por completo en cada micro-lote: el coste
de la actualización depende de cuántos años ha tocado el micro-lote, no del
tamaño total de silver. Con este generador, que reparte las fechas por
todo el periodo de ventas, cada micro-lote toca casi todos los años; en una
ingesta real, donde los pedidos nuevos son recientes, serían uno o dos.
Arrancar la consulta
El checkpoint guarda qué ficheros de la fuente ya se han procesado, para que reiniciar la consulta más adelante no vuelva a aplicar el mismo micro-lote dos veces.
from pyspark.sql.streaming import StreamingQuery

CHECKPOINT_PATH: str = "/user/luser/s8/checkpoints/web_sales_incremental"

query: StreamingQuery = (
    raw_stream.writeStream.foreachBatch(merge_into_silver_and_gold)
    .trigger(processingTime="5 seconds")
    .option("checkpointLocation", CHECKPOINT_PATH)
    .start()
)

print("Consulta de streaming arrancada. ID:", query.id)
La consulta arranca con el fichero del primer lote ya esperando en la ruta
de aterrizaje. processAllAvailable() bloquea hasta que se procesa todo lo
que había disponible en el momento de llamarlo — no espera al siguiente
disparador ni se queda esperando datos que nunca llegan —, así que es la
forma correcta de sincronizar este notebook con la consulta sin dejar
ninguna celda bloqueada indefinidamente.
query.processAllAvailable()
print(query.lastProgress)
Primeros micro-lotes
Simulamos la periodicidad ejecutando el generador varias veces seguidas
desde este mismo notebook, con una pausa corta entre ejecuciones. En un
entorno real este mismo programa se lanzaría desde cron, un systemd timer o un job programado; aquí basta con dejar clara esa equivalencia
sin construirla.
El bucle tiene un número de iteraciones fijo (LOOP_ITERATIONS = 3, más
el lote inicial de la sección anterior, cuatro en total) y cada vuelta
llama a processAllAvailable() en vez de a awaitTermination() sin
límite: esta celda termina siempre en un tiempo acotado, no se queda
sirviendo la consulta para siempre.
import time

LOOP_ITERATIONS: int = 3

for iteration in range(1, LOOP_ITERATIONS + 1):
    run: subprocess.CompletedProcess[str] = subprocess.run(
        ["python", "generate_web_sales_batch.py", "--rows", "150", "--update-fraction", "0.4"],
        capture_output=True,
        text=True,
        check=True,
    )
    report: dict[str, object] = json.loads(run.stdout.strip().splitlines()[-1].split("\t", 1)[1])
    batch_reports.append(report)
    print(f"--- Generador, vuelta {iteration}: {report['batch_path']} ({report['rows']} filas) ---")

    query.processAllAvailable()
    print(f"[lastProgress tras la vuelta {iteration}]")
    print(query.lastProgress)

    time.sleep(2)

print(f"Lotes procesados en total: {len(batch_reports)}")
lastProgress es un diccionario con, entre otras claves, numInputRows
(filas del micro-lote), durationMs (desglose de tiempos por fase:
addBatch, getBatch, queryPlanning...) y sink. Es la respuesta
concreta a "¿cuánto tarda en incorporarse un lote nuevo, desde que el
generador lo escribe hasta que aparece en el agregado gold?": la suma de
triggerExecution de cada micro-lote.
Mientras la consulta está activa, la interfaz web de Spark
(http://localhost:4040, presentada en S4) añade la pestaña Structured
Streaming, con una fila por consulta y, dentro de ella, las gráficas de
filas de entrada y de duración de cada micro-lote. Los MERGE que lanza
foreachBatch aparecen además como consultas en SQL / DataFrame.
progress_summary: list[dict[str, object]] = [
    {
        "batchId": progress["batchId"],
        "numInputRows": progress["numInputRows"],
        "durationMs_total": progress["durationMs"].get("triggerExecution"),
    }
    for progress in query.recentProgress
]
for entry in progress_summary:
    print(entry)
MERGE INTO hacia silver, explicado
Con los cuatro lotes ya fusionados, buscamos en iceberg.tcdm.web_sales una
fila que sabemos que es una corrección (una clave que ya existía en el
web_sales real de S2, con un importe nuevo) y una fila que sabemos que es
un alta (una clave que no existía antes de esta sesión). Las dos
claves salen de batch_reports, no se adivinan.
update_reports_with_keys: list[dict[str, object]] = [
    report for report in batch_reports if report["updated_keys"]
]
assert update_reports_with_keys, "Ningún lote generó correcciones; revisa --update-fraction"

example_update_report: dict[str, object] = update_reports_with_keys[-1]
example_update_order_number, example_update_item_sk = example_update_report["updated_keys"][0]

print(
    f"Clave corregida en el último lote con correcciones: ({example_update_order_number}, {example_update_item_sk})"
)

run_trino(f'''
    SELECT *
    FROM iceberg.tcdm.web_sales
    WHERE ws_order_number = {example_update_order_number}
      AND ws_item_sk = {example_update_item_sk}
    ''')
example_insert_order_number, example_insert_item_sk = first_report["inserted_keys_sample"][0]
print(f"Clave nueva del primer lote: ({example_insert_order_number}, {example_insert_item_sk})")

run_trino(f'''
    SELECT *
    FROM iceberg.tcdm.web_sales
    WHERE ws_order_number = {example_insert_order_number}
      AND ws_item_sk = {example_insert_item_sk}
    ''')
La primera consulta devuelve una fila cuya clave ya existía en el
web_sales real de S2 (el mismo (ws_order_number, ws_item_sk)), pero con
los importes que generó el micro-lote correspondiente: es la rama WHEN MATCHED THEN UPDATE SET * del MERGE. La segunda devuelve una fila cuya
clave no puede existir en TPC-DS SF1 (los números de pedido de alta parten
de una base muy por encima del rango real): es la rama WHEN NOT MATCHED THEN INSERT *. El mismo MERGE INTO, ejecutado una sola vez por
micro-lote, ha resuelto las dos situaciones sin que foreachBatch tuviera
que distinguirlas de antemano.
De silver a gold, de forma incremental
iceberg.tcdm.web_sales_by_year se ha ido actualizando en el mismo
foreachBatch que la silver, un MERGE por micro-lote que sólo toca los
años presentes en ese micro-lote. La comprobamos ahora completa.
run_trino("SELECT * FROM iceberg.tcdm.web_sales_by_year ORDER BY d_year")
Ningún paso de este notebook ha recalculado iceberg.tcdm.web_sales_by_year
desde toda la silver: cada micro-lote sólo ha vuelto a agregar los años
que él mismo tocaba (touched_years, impreso más arriba por cada vuelta del
bucle). Con TPC-DS SF1 —unos pocos años de web_sales— la diferencia de
coste entre las dos estrategias no se nota en el tiempo de pared de esta
sesión, pero sí se notaría con un histórico de muchos años: recalcular
todo el agregado en cada micro-lote crecería con el tamaño de silver,
mientras que este MERGE filtrado crece sólo con el número de años
tocados por el propio micro-lote.
Copy-on-write frente a merge-on-read
Iceberg permite configurar, por tabla, cómo se materializan las filas
afectadas por un MERGE:
- copy-on-write (
write.merge.mode = 'copy-on-write'): Iceberg reescribe por completo los ficheros de datos afectados. - merge-on-read (
write.merge.mode = 'merge-on-read'): Iceberg escribe únicamente los cambios — ficheros de borrado y, cuando aplica, ficheros de datos nuevos — y delega en el lector la tarea de aplicarlos al leer.
Qué motor permite elegir. El conector Iceberg de Trino sólo
implementa merge-on-read para UPDATE/DELETE/MERGE: siempre escribe
ficheros de borrado, nunca reescribe ficheros de datos completos. Por eso
no deja declarar write.merge.mode, write.update.mode ni
write.delete.mode; si se intentan pasar a través de extra_properties,
responde:
TrinoUserError: Illegal keys in extra_properties: [write.merge.mode]
Es una característica del conector
(trinodb/trino#17272), no
de este clúster. El escritor de Iceberg de Spark sí respeta
write.merge.mode, y el catálogo iceberg de Spark configurado más arriba
habla con el mismo Hive Metastore que Trino: creamos las dos tablas de
laboratorio con spark.sql("CREATE TABLE iceberg.tcdm... TBLPROPERTIES(...)"),
en el mismo catálogo que usa el resto de la sesión. Como estas tablas sólo sirven para esta
comparación, se llaman iceberg.tcdm.web_sales_lab_cow y
iceberg.tcdm.web_sales_lab_mor, y se borran en la sección "Detener y
limpiar" al final del notebook.
Cada tabla parte de un único año de iceberg.tcdm.web_sales (el que tenga
más líneas), leído directamente con Spark —el mismo catálogo ya sabe leer
esta tabla, así que no hace falta pasar por Trino ni por pandas— y cargado
con INSERT. No de la tabla completa: el mecanismo que se observa no
depende del volumen de datos.
Ambas tablas se crean con 'format-version' = '2': los ficheros de borrado
a nivel de fila que necesita merge-on-read sólo existen en el formato de
tabla Iceberg v2.
from pyspark.sql import Row

lab_year_counts: list[Row] = (
    spark.table("iceberg.tcdm.web_sales")
    .groupBy("sold_year")
    .count()
    .withColumnRenamed("count", "lineas")
    .orderBy("lineas", ascending=False)
    .collect()
)
LAB_YEAR: int = int(lab_year_counts[0]["sold_year"])
print(
    f"Año elegido para las tablas de laboratorio: {LAB_YEAR} ({lab_year_counts[0]['lineas']} líneas)"
)
LAB_TABLE_DDL_COLUMNS: str = '''
    ws_order_number BIGINT,
    ws_item_sk BIGINT,
    ws_bill_customer_sk BIGINT,
    ws_bill_addr_sk BIGINT,
    ws_sold_date_sk BIGINT,
    ws_sold_date DATE,
    ws_quantity INT,
    ws_list_price DECIMAL(7, 2),
    ws_ext_discount_amt DECIMAL(7, 2),
    ws_ext_sales_price DECIMAL(7, 2),
    ws_net_paid DECIMAL(7, 2),
    ws_net_profit DECIMAL(7, 2),
    sold_year INT,
    sold_month INT
'''

spark.sql("DROP TABLE IF EXISTS iceberg.tcdm.web_sales_lab_cow")
spark.sql(f'''
    CREATE TABLE iceberg.tcdm.web_sales_lab_cow ({LAB_TABLE_DDL_COLUMNS})
    USING iceberg
    PARTITIONED BY (months(ws_sold_date))
    TBLPROPERTIES (
        'format-version' = '2',
        'write.merge.mode' = 'copy-on-write',
        'write.update.mode' = 'copy-on-write',
        'write.delete.mode' = 'copy-on-write'
    )
''')

spark.sql("DROP TABLE IF EXISTS iceberg.tcdm.web_sales_lab_mor")
spark.sql(f'''
    CREATE TABLE iceberg.tcdm.web_sales_lab_mor ({LAB_TABLE_DDL_COLUMNS})
    USING iceberg
    PARTITIONED BY (months(ws_sold_date))
    TBLPROPERTIES (
        'format-version' = '2',
        'write.merge.mode' = 'merge-on-read',
        'write.update.mode' = 'merge-on-read',
        'write.delete.mode' = 'merge-on-read'
    )
''')
print(
    "Tablas de laboratorio creadas: web_sales_lab_cow (copy-on-write), web_sales_lab_mor (merge-on-read)."
)
Cargamos cada tabla de laboratorio con las filas de LAB_YEAR directamente
desde iceberg.tcdm.web_sales, con el mismo catálogo Spark: no hace falta
pasar por Trino ni por pandas, así que no hay que lidiar con la conversión
de tipos ni con valores nulos representados como NaN.
from pyspark.sql.functions import col as spark_col

lab_source_df: DataFrame = (
    spark.table("iceberg.tcdm.web_sales")
    .filter(spark_col("sold_year") == LAB_YEAR)
    .select([field.name for field in web_sales_incremental_schema.fields])
)

lab_source_df.write.mode("append").saveAsTable("iceberg.tcdm.web_sales_lab_cow")
lab_source_df.write.mode("append").saveAsTable("iceberg.tcdm.web_sales_lab_mor")

lab_source_rows: int = lab_source_df.count()
cow_rows: int = spark.table("iceberg.tcdm.web_sales_lab_cow").count()
mor_rows: int = spark.table("iceberg.tcdm.web_sales_lab_mor").count()
print(f"Filas cargadas: cow={cow_rows}, mor={mor_rows}")
assert cow_rows == mor_rows == lab_source_rows
Para aplicar la misma secuencia de cambios a las dos tablas construimos, con
Spark, un pequeño lote sintético que reutiliza tres claves que ya están en
las tablas de laboratorio (corrección, rama "update") y añade dos claves
nuevas (alta, rama "insert") — el mismo tipo de mezcla que ya generaba
generate_web_sales_batch.py, pero fabricado aquí directamente para
garantizar que las claves de corrección existen en este año concreto.
Estas filas de laboratorio no reutilizan la clave de fecha ni los importes
reales: ws_sold_date_sk y los importes quedan a None, porque sólo
sirven para comparar el efecto físico del mismo MERGE entre las tablas
copy-on-write y merge-on-read — no para representar ventas reales.
import random
from datetime import date

from pyspark.sql import Row

lab_sample_keys: list[Row] = (
    spark.table("iceberg.tcdm.web_sales_lab_cow")
    .select("ws_order_number", "ws_item_sk")
    .limit(3)
    .collect()
)

lab_rng: random.Random = random.Random(2027)
lab_rows: list[dict[str, object]] = []

for key_row in lab_sample_keys:
    lab_rows.append(
        {
            "ws_order_number": key_row["ws_order_number"],
            "ws_item_sk": key_row["ws_item_sk"],
            "ws_bill_customer_sk": lab_rng.randint(1, 100_000),
            "ws_bill_addr_sk": lab_rng.randint(1, 50_000),
            "ws_sold_date_sk": None,
            "ws_sold_date": date(LAB_YEAR, 6, 15),
            "ws_quantity": lab_rng.randint(1, 20),
            "ws_list_price": None,
            "ws_ext_discount_amt": None,
            "ws_ext_sales_price": None,
            "ws_net_paid": None,
            "ws_net_profit": None,
            "sold_year": LAB_YEAR,
            "sold_month": 6,
        }
    )

for offset in range(2):
    lab_rows.append(
        {
            "ws_order_number": 950_000_000 + offset,
            "ws_item_sk": lab_rng.randint(1, 18_000),
            "ws_bill_customer_sk": lab_rng.randint(1, 100_000),
            "ws_bill_addr_sk": lab_rng.randint(1, 50_000),
            "ws_sold_date_sk": None,
            "ws_sold_date": date(LAB_YEAR, 6, 15),
            "ws_quantity": lab_rng.randint(1, 20),
            "ws_list_price": None,
            "ws_ext_discount_amt": None,
            "ws_ext_sales_price": None,
            "ws_net_paid": None,
            "ws_net_profit": None,
            "sold_year": LAB_YEAR,
            "sold_month": 6,
        }
    )

lab_merge_batch: DataFrame = spark.createDataFrame(lab_rows, schema=web_sales_incremental_schema)
lab_merge_batch.createOrReplaceTempView("lab_merge_batch_view")
lab_merge_batch.show(truncate=False)
Antes de fusionar, listamos el contenido físico de cada tabla de
laboratorio: son la línea base con la que compararemos después del MERGE.
from pyspark.sql import Row


def table_location(table_name: str) -> str:
    '''Ubicación física real de una tabla del catálogo iceberg (Hive Metastore).

    A diferencia de un catálogo hadoop, donde la ruta se puede calcular sin
    preguntarle a nadie, aquí el Hive Metastore puede añadir un sufijo único
    a la ubicación de cada tabla (como ya viste en S7 con
    "SHOW CREATE TABLE"): hay que preguntárselo al catálogo con
    "DESCRIBE TABLE EXTENDED", la versión Spark del mismo tipo de consulta.
    '''
    extended_rows: list[Row] = spark.sql(f"DESCRIBE TABLE EXTENDED {table_name}").collect()
    location_row: Row = next(row for row in extended_rows if row["col_name"] == "Location")
    return location_row["data_type"]


cow_location: str = table_location("iceberg.tcdm.web_sales_lab_cow")
mor_location: str = table_location("iceberg.tcdm.web_sales_lab_mor")
print(f"cow: {cow_location}")
print(f"mor: {mor_location}")
!hdfs dfs -ls -R {cow_location}/data
!hdfs dfs -ls -R {mor_location}/data
Ahora aplicamos el mismo MERGE INTO —misma clave, mismo lote— a las dos
tablas.
spark.sql('''
    MERGE INTO iceberg.tcdm.web_sales_lab_cow AS target
    USING lab_merge_batch_view AS source
    ON target.ws_order_number = source.ws_order_number
       AND target.ws_item_sk = source.ws_item_sk
    WHEN MATCHED THEN UPDATE SET *
    WHEN NOT MATCHED THEN INSERT *
''')

spark.sql('''
    MERGE INTO iceberg.tcdm.web_sales_lab_mor AS target
    USING lab_merge_batch_view AS source
    ON target.ws_order_number = source.ws_order_number
       AND target.ws_item_sk = source.ws_item_sk
    WHEN MATCHED THEN UPDATE SET *
    WHEN NOT MATCHED THEN INSERT *
''')
print("MERGE aplicado a las dos tablas de laboratorio.")
!hdfs dfs -ls -R {cow_location}/data
!hdfs dfs -ls -R {mor_location}/data
Compara los dos listados posteriores al MERGE con los que tomamos antes:
en web_sales_lab_cow deben aparecer ficheros de datos nuevos que
sustituyen a los que contenían las tres filas corregidas (el resto de
ficheros, los que no tenían ninguna fila afectada, se conservan igual). En
web_sales_lab_mor los ficheros de datos originales deben seguir intactos y
aparecer, además, uno o varios ficheros nuevos de un tipo distinto —
ficheros de borrado (delete files), cuyo nombre termina en
-deletes.parquet—, más los ficheros de datos con las filas nuevas.
Esa es la diferencia física que promete la teoría: copy-on-write paga el
coste en la escritura, reescribiendo; merge-on-read lo aplaza a la
lectura, acumulando ficheros de borrado que en algún momento habría que
compactar — exactamente el mismo problema de pequeños ficheros y
compactación que ya se vio en S7.
Observar el progreso y detener la consulta
Antes de detener la consulta original (la que alimenta las tablas compartidas del contrato), repasamos las tres formas de consultar su estado.
print("query.status:", query.status)
print("query.lastProgress:", query.lastProgress)
print(f"Micro-lotes acumulados en recentProgress: {len(query.recentProgress)}")
query.status distingue si la consulta está esperando datos nuevos o
procesando; lastProgress describe el último micro-lote; recentProgress
guarda el historial de esta ejecución (con un límite interno de entradas).
Detenemos la consulta de forma ordenada:
query.stop()
print(f"Consulta detenida. isActive = {query.isActive}")
Reiniciar desde el mismo checkpoint
Detener la consulta no borra el checkpoint: si se reinicia la misma consulta con la misma ruta de checkpoint y no hay ficheros nuevos que procesar, Structured Streaming no debería reprocesar nada. Lo comprobamos arrancando una segunda consulta idéntica, sin generar ningún lote nuevo antes.
query_restarted: StreamingQuery = (
    raw_stream.writeStream.foreachBatch(merge_into_silver_and_gold)
    .trigger(processingTime="5 seconds")
    .option("checkpointLocation", CHECKPOINT_PATH)
    .start()
)

query_restarted.processAllAvailable()
restarted_progress: dict[str, object] | None = query_restarted.lastProgress
print(restarted_progress)

query_restarted.stop()
print(f"Segunda consulta detenida. isActive = {query_restarted.isActive}")
Si restarted_progress es None o su numInputRows es 0, es la señal de
que el checkpoint ha hecho su trabajo: la consulta reiniciada sabe qué
ficheros ya se procesaron en la ejecución anterior y no ha vuelto a
fusionarlos. Borrar el checkpoint (hdfs dfs -rm -r /user/luser/s8/checkpoints/web_sales_incremental) obligaría a reprocesar
desde el principio — útil para repetir el ejercicio desde cero, pero debe
hacerse de forma explícita, nunca como efecto colateral de otra limpieza; se
deja documentado, no como celda, en la sección "Detener y limpiar" de más
abajo.
Comprobar la coherencia con el recorrido por lotes
La comprobación más importante de esta sesión: el agregado gold mantenido de forma incremental por streaming debe coincidir, año a año, con el que se obtendría recalculándolo por lotes desde silver, con la misma consulta que ya usaron S5 y S7 (pedidos distintos, líneas de venta y beneficio neto).
batch_recomputed_gold: pd.DataFrame = run_trino('''
    SELECT sold_year AS d_year,
           count(DISTINCT ws_order_number) AS pedidos,
           count(*) AS lineas_de_venta,
           sum(ws_net_profit) AS beneficio_neto
    FROM iceberg.tcdm.web_sales
    GROUP BY sold_year
    ORDER BY d_year
    ''')

incremental_gold: pd.DataFrame = run_trino(
    "SELECT * FROM iceberg.tcdm.web_sales_by_year ORDER BY d_year"
)

comparison: pd.DataFrame = batch_recomputed_gold.merge(
    incremental_gold, on="d_year", suffixes=("_batch", "_incremental")
)
comparison["beneficio_neto_batch"] = comparison["beneficio_neto_batch"].astype(float)
comparison["beneficio_neto_incremental"] = comparison["beneficio_neto_incremental"].astype(float)
comparison["diferencia_beneficio"] = (
    comparison["beneficio_neto_batch"] - comparison["beneficio_neto_incremental"]
).abs()

assert (
    len(comparison) == len(batch_recomputed_gold) == len(incremental_gold)
), "Faltan años en una de las dos versiones"
assert (comparison["pedidos_batch"] == comparison["pedidos_incremental"]).all()
assert (comparison["lineas_de_venta_batch"] == comparison["lineas_de_venta_incremental"]).all()
assert (comparison["diferencia_beneficio"] < 0.01).all()

print("El agregado incremental coincide, año a año, con el recálculo completo por lotes.")
comparison
S7 demostró que (ws_order_number, ws_item_sk) es la clave única de
iceberg.tcdm.web_sales. Esta sesión reescribe esa misma tabla con MERGE
en cada micro-lote, así que cerramos el contrato comprobándolo de nuevo, y
de paso miramos los snapshots que ha ido dejando el streaming — uno por
micro-lote, igual que en S7.
key_uniqueness: pd.DataFrame = run_trino('''
    WITH totals AS (
        SELECT count(*) AS filas FROM iceberg.tcdm.web_sales
    ),
    distinct_keys AS (
        SELECT count(*) AS claves FROM (
            SELECT DISTINCT ws_order_number, ws_item_sk FROM iceberg.tcdm.web_sales
        )
    )
    SELECT filas, claves FROM totals, distinct_keys
''')
assert int(key_uniqueness.loc[0, "filas"]) == int(key_uniqueness.loc[0, "claves"]), (
    "La clave compuesta (ws_order_number, ws_item_sk) debe seguir siendo única "
    "en iceberg.tcdm.web_sales tras los MERGE de esta sesión"
)
key_uniqueness
snapshots_web_sales_tras_streaming: pd.DataFrame = run_trino('''
    SELECT snapshot_id, committed_at, operation
    FROM iceberg.tcdm."web_sales$snapshots"
    ORDER BY committed_at
''')
snapshots_web_sales_tras_streaming
Esta comprobación es la evidencia de que el streaming no ha introducido un
motor de cálculo distinto: sigue siendo SQL sobre la misma tabla —ejecutado
por Trino, no por Spark, como comprobación independiente de lo que Spark
escribió—, con más frecuencia y sobre menos datos por ejecución. Si alguno
de los assert anteriores fallara, el error estaría en la lógica del
foreachBatch (por ejemplo, en el cálculo de touched_years), no en los
datos de origen.
Qué no se ha visto todavía
Esta sesión no ha introducido:
- Kafka ni ningún otro sistema de mensajería: el generador simulado escribe
ficheros directamente en HDFS, y
readStreamlos recoge con la misma fuente de ficheros que ya se conocía de las sesiones por lotes; - procesamiento evento a evento ni garantías de latencia de segundos: Spark Structured Streaming, incluso en su modo de disparador más frecuente, sigue procesando micro-lotes, no eventos individuales;
- watermarking ni agregaciones con ventanas de tiempo sobre datos desordenados: quedan como ampliación si el tiempo del curso lo permite;
- un panel de control que visualice los resultados: eso se aborda en una fase posterior explícita, construida sobre esta misma tabla gold, con Metabase como añadido al Compose del clúster y un mecanismo para declarar paneles "como código" mediante su API REST.
Detener y limpiar
Estas operaciones se muestran como texto, no como celdas de código, para que
un «ejecutar todo» de este notebook no las dispare por accidente. Las dos
consultas de streaming de este notebook ya se han detenido con query.stop()
más arriba; lo que queda pendiente es limpieza de recursos de laboratorio.
Las tablas de laboratorio y los ficheros de aterrizaje forman parte de las
evidencias: consérvalos hasta la reunión y límpialos después. Las órdenes
spark.sql(...) van en una celda de este notebook, igual que las de
hdfs dfs ... precedidas de !; docker compose, en una terminal de tu
equipo desde la raíz de la distribución.
| Situación | Orden | Consecuencia |
|---|---|---|
| Eliminar las tablas de laboratorio copy-on-write/merge-on-read | spark.sql("DROP TABLE iceberg.tcdm.web_sales_lab_cow") y lo mismo para web_sales_lab_mor |
Borra las dos tablas del catálogo iceberg (metadatos en el Hive Metastore y ficheros bajo /warehouse). No afecta a iceberg.tcdm.web_sales ni a iceberg.tcdm.web_sales_by_year: son tablas distintas. |
| Vaciar la ruta de aterrizaje del streaming | hdfs dfs -rm -r /datalake/raw/streaming/web_sales_incremental |
Borra todos los lotes Parquet generados por generate_web_sales_batch.py en esta sesión. No afecta a /datalake/raw/tpcds. |
| Forzar que la consulta reprocese todo desde el principio | hdfs dfs -rm -r /user/luser/s8/checkpoints/web_sales_incremental |
Borra el checkpoint: la próxima vez que se arranque la consulta sobre la misma ruta de aterrizaje, volverá a fusionar todos los ficheros que sigan ahí. Útil para repetir el ejercicio desde cero, nunca como efecto colateral de otra limpieza. |
| Volver al estado en que S7 dejó las tablas | Con la consulta detenida: spark.sql("DROP TABLE iceberg.tcdm.web_sales") y spark.sql("DROP TABLE iceberg.tcdm.web_sales_by_year"); borrar la ruta de aterrizaje y el checkpoint (las dos filas anteriores); y volver a ejecutar en S7 las celdas de «Crear la tabla Iceberg» |
Deshace todo lo que esta sesión ha fusionado: S7 recrea las dos tablas desde las tablas Hive de S6, que no han cambiado. Si no se borran el aterrizaje y el checkpoint, la siguiente ejecución de esta sesión volvería a aplicar los lotes antiguos. |
| Parar temporalmente el warehouse | docker compose -f entorno/compose-warehouse-hdfs.yml stop |
Conserva PostgreSQL, Hive Metastore y Trino (y su contenido); se reanuda con start. No afecta al clúster Hadoop ni a iceberg.tcdm.web_sales. |
No confundas ninguna de estas operaciones con docker compose ... down -v
sobre el warehouse: ese comando sí es destructivo sobre volúmenes
completos, como se documenta en el propio Compose del warehouse; el
equivalente en S1 (clúster Hadoop) es el borrado de volúmenes con
docker volume rm/make clean-hdfs, no un down -v.
Preguntas para interpretar la experiencia
- ¿Por qué
readStreamexige un esquema explícito cuandospark.read.parquetde las sesiones anteriores podía inferirlo? - ¿Qué recibe exactamente la función que se pasa a
foreachBatch? ¿En qué se parece a un DataFrame de las sesiones por lotes y en qué no? - ¿Por qué el
MERGE INTOhaciaiceberg.tcdm.web_salespuede usar la abreviaturaUPDATE SET */INSERT *, y qué tendría que dejar de ser cierto sobre la vista temporal del micro-lote para que esa abreviatura fallara? - ¿Por qué el
MERGE INTOde esta sesión comparaws_order_numberyws_item_sk, y qué pasaría si sólo compararaws_order_number? - ¿Qué garantiza el checkpoint de una consulta de streaming, y qué no garantiza? ¿Qué evidencia de este notebook lo demuestra?
- ¿Por qué el segundo
MERGEdeforeachBatchfiltra por los años tocados por el micro-lote en vez de recalcular todoiceberg.tcdm.web_sales_by_yearcada vez? - ¿Por qué Trino sólo implementa merge-on-read para escribir en Iceberg, y
qué consecuencia tiene eso para una tabla que recibe muchos
MERGE? - ¿Qué diferencia física observaste en HDFS entre
web_sales_lab_cowyweb_sales_lab_mordespués del mismoMERGE? ¿Cuál de las dos tablas necesitaría antes una compactación, y por qué? - ¿Por qué la comprobación de coherencia con el recálculo por lotes es la evidencia más importante de esta sesión, más que el número de micro-lotes procesados?
- ¿Qué parte de esta sesión cambiaría si, en vez de un generador
simulado, los datos llegaran realmente por Kafka? ¿Qué parte del
foreachBatchseguiría siendo exactamente igual?
Evidencias de la sesión
Esta es la última sesión del itinerario, así que no hay una sesión siguiente: la reunión individual breve con el profesor para revisar este trabajo se fija aparte. Como en las anteriores, combina una demostración en vivo sobre tu propio ordenador y una memoria escrita breve.
Qué mostrar en el ordenador durante la reunión
Ten preparadas estas evidencias:
- Varias ejecuciones del generador, con los ficheros nuevos visibles en
/datalake/raw/streaming/web_sales_incremental(hdfs dfs -ls). - La consulta de streaming en marcha, con al menos tres micro-lotes
procesados y sus métricas (
lastProgress/recentProgress). - Una fila insertada y una fila corregida en
iceberg.tcdm.web_salespor el mismoMERGE, distinguibles con sus claves. iceberg.tcdm.web_sales_by_yearactualizado de forma incremental, coincidente con el recálculo por lotes de control (la tablacomparisonde este notebook).- El listado HDFS de
web_sales_lab_cowyweb_sales_lab_morantes y después del mismoMERGE, mostrando la diferencia entre ficheros de datos reescritos y ficheros de borrado. - Una consulta de streaming detenida de forma ordenada (
query.stop()) y reiniciada desde su checkpoint sin reprocesar micro-lotes ya aplicados.
Memoria escrita (una o dos páginas)
Trae también un documento breve —una o dos páginas, no hace falta más— que
no se limite a pegar capturas de las salidas anteriores: debe explicar con
tus propias palabras qué cambia entre procesar por lotes y por micro-lotes;
qué hace foreachBatch con cada micro-lote y por qué necesita dos MERGE;
por qué la clave del MERGE es el par (ws_order_number, ws_item_sk); qué
garantiza el checkpoint y qué no; qué diferencia física hay entre
copy-on-write y merge-on-read; y por qué el agregado mantenido de forma
incremental coincide con el recálculo completo.
Qué es importante de cara al examen final
El examen no pide recordar la sintaxis exacta de una sentencia. Debes poder explicar:
- qué es un micro-lote, qué es un disparador y por qué una fuente de ficheros en streaming exige declarar el esquema;
- qué recibe
foreachBatchy por qué permite reutilizar en streaming las operaciones de las sesiones por lotes; - cómo resuelve un único
MERGE INTOlas altas, las correcciones y los borrados, y qué papel tiene la clave de comparación; - cómo se mantiene un agregado de forma incremental, tocando sólo lo que cambia, y por qué hay que tener en cuenta el valor anterior de las filas corregidas;
- qué recuerda un checkpoint y qué ocurre al reiniciar una consulta con y sin él;
- la diferencia entre copy-on-write y merge-on-read, y su relación con la compactación vista en S7;
- por qué el resultado de negocio, y no el número de micro-lotes, es la evidencia de que la ingesta continua es correcta.
Siguiente paso
El itinerario docente completo (S1-S8) enseña a levantar el clúster, conocer los datos como ficheros, moverlos a un almacenamiento de objetos, procesarlos con Spark, organizarlos en zonas, catalogarlos, gestionarlos como una tabla lakehouse y, finalmente, alimentarlos de forma continua. La fase siguiente, ya fuera de esta numeración, añade un panel de control (Metabase) como servicio adicional del Compose, con una conexión a Trino y un mecanismo para declarar nuevos paneles mediante ficheros de configuración y la API REST de Metabase, consultando la misma tabla gold que esta sesión mantiene al día.