Sesión 7 — Iceberg: del data lake al lakehouse, evolución y optimización
Esta sesión reúne, de forma deliberada, dos bloques: la creación y evolución de una tabla Iceberg, y la medición y optimización de esa misma tabla. Van juntos porque comparten la tabla de trabajo, el dataset TPC-DS SF1 que ya conoces de S2-S6 y buena parte del vocabulario: no tiene sentido medir manifests y snapshots sobre una tabla que todavía no has visto crear ni evolucionar.
Llegas a este punto habiendo trabajado con Parquet, con Spark como motor de transformación, con particiones físicas y con tablas Hive registradas en un Metastore compartido por Trino y Spark (S6). Ya sabes que un catálogo facilita encontrar los datos y compartir su definición entre motores, pero también has visto sus límites: una colección de directorios y entradas de metastore no resuelve por sí sola la evolución de esquema, la consistencia entre escrituras concurrentes ni la limpieza de versiones antiguas.
La pregunta central de esta sesión es doble, y las dos mitades se responden con la misma tabla:
¿Qué añade un formato de tabla como Iceberg para que un data lake pueda comportarse como un lakehouse? Y una vez que existe esa tabla, ¿cómo medimos y mantenemos sus optimizaciones para que sean útiles y no sólo una colección de propiedades activadas a ciegas?
El salto de Hive a Iceberg no consiste en poner otra etiqueta al mismo directorio. Iceberg introduce un modelo de tabla con metadatos versionados, manifests, snapshots y reglas explícitas de evolución. El catálogo —aquí, otra vez el Hive Metastore que ya conoces de S6— sigue siendo necesario para localizar la tabla, pero ya no es él quien define qué es la tabla: eso lo hace el formato Iceberg. Y una vez creada esa tabla, es donde mediremos qué compensa de verdad: particionado, estadísticas, compactación, ordenación física y, sólo como ampliación si resulta reproducible, Z-order.
Paquetes de Python de esta sesión. Esta sesión necesita
pyspark,trino,pandas. No añade ningún paquete respecto a S6. Se instalan en el kernel denamenodeen la sección «Instalar las dependencias de este notebook»: una celda%%writefile requirements.txtcrea el fichero dentro del contenedor —elrequirements.txtde tu copia des7/está en tu equipo ynamenodeno lo ve— y otra ejecuta%pip install -r requirements.txt. La imagen denamenodeya trae estos paquetes en su entorno Python del curso,/opt/tcdm/venv, que es el intérprete del kernel y donde instala%pip; lo normal es que%pipsólo confirme que están; ejecuta esas celdas de todos modos: dejan explícito qué necesita la sesión y reparan el entorno si falta algo.
Diapositivas de la sesión
Las diapositivas se generan con el paquete jupyter-notebook-slide.
El alias %%diapositiva permite mantener en español los tipos usados en la sesión y produce la misma salida HTML en Jupyter, Colab y la referencia HTML publicada.
En cada sesión encontrarás varios tipos de diapositivas que te ayudarán a seguir el hilo:
- Sección (
titulo): abre la sesión y resume qué vamos a ver y qué haremos. - A continuación (
avance): anuncia el contenido de la parte siguiente, para saber en qué punto del programa estamos. - Recapitulación (
resumen): condensa la parte anterior en puntos clave para recordarlos y revisarlos después. - Pregunta guía (
pregunta): plantea cuestiones que orientan lo que viene a continuación; conviene intentar responderlas antes de seguir. - Evaluación de la sesión (
evaluacion): recuerda cómo se evalúa el trabajo de esta sesión.
%pip install -q "jupyter-notebook-slide @ git+https://github.com/dsevilla/jupyter-notebook-slide.git"
%load_ext notebook_slide

import notebook_slide as jnbs

# Colores de 26-27/teoria/tcdm.css, adaptados al tema de las sesiones.
jnbs.configure(
    background="#eaf2f8",
    foreground="#1f2933",
    border="#c9d6e1",
    heading="#0c304d",
    subheading="#0c304d",
    link="#174f7a",
    code_background="#eaf2f8",
    code_foreground="#0c304d",
    quote_background="#ffffff",
    font_family="Atkinson Hyperlegible, Inter, Aptos, Segoe UI, Helvetica, Arial, sans-serif",
    font_url="https://fonts.googleapis.com/css2?family=Atkinson+Hyperlegible:ital,wght@0,400;0,700;1,400;1,700&display=swap",
)
jnbs.register_slide_type("avance", "A continuación", "#174f7a")
jnbs.register_slide_type("resumen", "Recapitulación", "#a54467")
jnbs.register_slide_type("pregunta", "Pregunta guía", "#0c304d")
jnbs.register_slide_type("evaluacion", "Evaluación de la sesión", "#b3701a")
jnbs.register_slide_type(
    "titulo",
    "Sección",
    "#174f7a",
    layout="title",
    background="linear-gradient(135deg, #0c304d, #174f7a 62%, #a54467)",
    foreground="#ffffff",
    border="transparent",
    heading="#ffffff",
    subheading="#dceaf4",
)
jnbs.register_alias("diapositiva")
Recorrido del curso
S2: Parquet como ficheros
  → S3: Parquet en HDFS y S3-compatible
  → S4: Spark transforma los datos
  → S5: data lake organizado y particionado (medallion raw/silver/gold)
  → S6: tablas Hive con Metastore y Trino
  → S7: tabla Iceberg catalogada, evolución, snapshots y optimización medida
  → S8: ingesta continua con Spark Structured Streaming
La ruta principal de esta sesión es la de HDFS con Hive Metastore e
Iceberg, la misma infraestructura de entorno/compose-warehouse-hdfs.yml
que ya arrancaste en S6. La configuración S3 con RustFS, Polaris y el
contenedor spark-iceberg que también existe en este entorno es una
demostración de portabilidad para otro momento del curso, no el primer
contacto con Iceberg.
Data lake, data lake catalogado y lakehouse
Antes de tocar una sola celda conviene fijar tres situaciones que a menudo se confunden porque comparten Parquet como formato de fichero:
| Situación | Qué existe | Qué problemas quedan |
|---|---|---|
| Data lake de ficheros | Parquet en HDFS o S3 | Rutas, esquemas y cambios se gestionan manualmente |
| Data lake catalogado | Parquet + Hive Metastore | Hay nombres y particiones, pero las operaciones tienen límites |
| Lakehouse | Formato de tabla + catálogo + almacenamiento | Metadatos, snapshots y cambios se coordinan como una tabla |
S2 te dejó en la primera fila: ficheros Parquet localizables por ruta. S6 te llevó a la segunda: los mismos ficheros, con nombre y particiones conocidas por Trino y Spark a través del metastore. Esta sesión te lleva a la tercera fila, y es importante no simplificar el paso: un data lakehouse no exige que desaparezcan Parquet o el propio Hive Metastore. Iceberg sigue escribiendo ficheros Parquet como datos, y sigue apoyándose en el mismo metastore para que Trino localice la tabla por su nombre lógico. Lo que añade es una capa de metadatos de tabla —manifests y snapshots— que decide qué ficheros pertenecen a cada versión de la tabla y cómo se interpretan, algo que ni el sistema de ficheros ni el metastore por sí solos pueden ofrecer.
Objetivos de la sesión
Al terminar esta sesión deberías poder:
- explicar la diferencia entre un fichero Parquet, una tabla Hive externa y una tabla Iceberg;
- explicar el papel del catálogo y distinguir el Hive Metastore (quién localiza la tabla) del formato de tabla Iceberg (qué es la tabla);
- crear una tabla Iceberg desde Trino, con una transformación de partición oculta sobre una columna de fecha;
- leer la misma tabla desde Trino y desde Spark y obtener el mismo resultado de negocio;
- observar la ubicación física de los datos y los metadatos bajo
/warehouse, sin deducirla del nombre lógico; - identificar snapshots y relacionarlos con las operaciones de escritura que los producen;
- realizar una evolución de esquema segura y observable, y comprobar que las filas y snapshots anteriores siguen siendo legibles;
- comparar el particionado visible de Hive con las transformaciones de partición ocultas de Iceberg sobre la misma columna de negocio;
- explicar por qué la selección de columnas y el predicate pushdown siguen siendo la primera optimización a comprobar, antes de técnicas más complejas;
- detectar el problema de los ficheros pequeños y aplicar compactación con
EXECUTE optimize; - utilizar estadísticas (
ANALYZE) para entender la planificación, sin asumir que siempre cambian la decisión del motor; - distinguir la ordenación de un resultado SQL (
ORDER BY) de un sort order de tabla que describe cómo se organizan físicamente los datos escritos; - valorar Z-order como técnica avanzada dependiente del motor y la versión, y saber cuándo documentarla en lugar de fingir una demostración;
- mantener snapshots con una política explícita de retención y practicar su expiración únicamente sobre tablas de laboratorio;
- describir qué características convierten al conjunto en un lakehouse y reconocer cuándo una optimización concreta no aporta beneficio real.
Antes de empezar
Dónde se ejecuta este notebook. Igual que en S2-S6, Jupyter se ejecuta directamente dentro del contenedor
namenode, comoluser, con acceso de red directo a HDFS, YARN, Trino, PostgreSQL y el Hive Metastore: todos comparten la red Dockerhadoop-cluster. Las celdas ejecutables hablan directamente con esos servicios. Las órdenes que necesitan el Docker del host —arrancar o detener contenedores,make— se muestran como texto para ejecutarlas en una terminal de tu equipo, nunca como celdas de este notebook.
Esta sesión asume que:
- el clúster de S1 y el warehouse de S6 (PostgreSQL, Hive Metastore, Trino) ya están en marcha;
- S2 generó los Parquet de TPC-DS SF1 en
/datalake/raw/tpcds; - S5 dejó
/datalake/silver/tpcds/web_sales(particionado porsold_yearysold_month) y/datalake/gold/tpcds/web_sales_by_yearescritos en HDFS; - S6 registró esos mismos datos como tablas Hive externas:
hive.tcdm.date_dim,hive.tcdm.web_sales_silver(con sus particiones ya sincronizadas) yhive.tcdm.web_sales_by_year_gold.
Si el clúster de infraestructura no está levantado todavía, desde una terminal de tu equipo situada en la raíz de la distribución de sesiones:
cd ~/tcdm-public
git pull
make -C entorno warehouse-up
Este notebook se ejecuta en el Jupyter de namenode, que no arranca solo.
Como en S2, arráncalo desde otra terminal de tu equipo y déjala abierta
mientras trabajes:
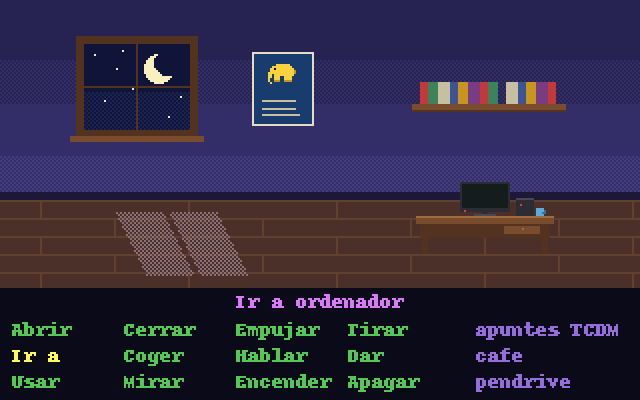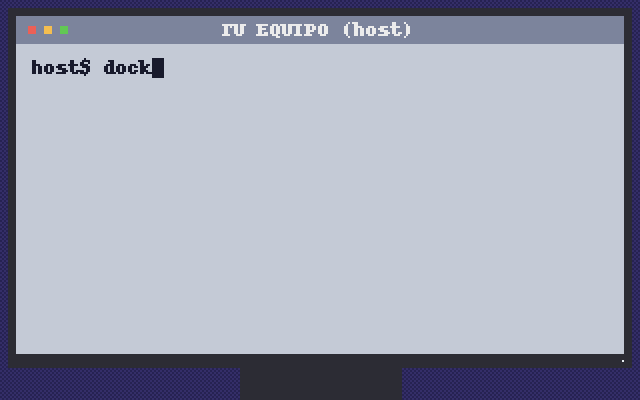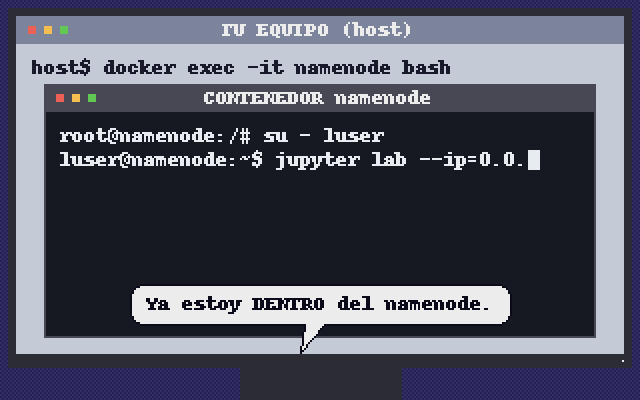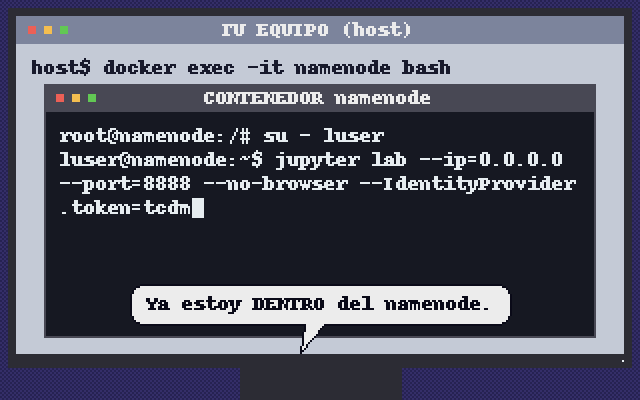
# en tu equipo: entra en namenode
docker exec -it namenode bash
# ya dentro de namenode, como luser: Jupyter con el token fijo «tcdm»
su - luser
jupyter lab --ip=0.0.0.0 --port=8888 --no-browser --IdentityProvider.token=tcdm
La primera orden es la única que se ejecuta en tu equipo; las otras dos, ya
dentro del contenedor, arrancan Jupyter con el Python del curso
(make -C entorno jupyter hace lo mismo en una sola orden). En Visual
Studio Code, conecta este notebook con Select Kernel → Select Another
Kernel → Existing Jupyter Server, usando la dirección
http://127.0.0.1:8888/lab?token=tcdm y eligiendo el kernel Python 3
(ipykernel). El token es siempre tcdm.
Si algo no funciona —el notebook no conecta, una celda !hdfs no
encuentra la orden, un servicio no responde—, consulta «Solución de
problemas» en entorno/README.md.
Esta sesión no vuelve a ejecutar S5 ni S6. Si alguna de las tablas Hive anteriores no existe todavía, ejecuta antes esos dos notebooks.
!hdfs dfs -ls -d /datalake/raw/tpcds/date_dim \
    /datalake/silver/tpcds/web_sales \
    /datalake/gold/tpcds/web_sales_by_year \
    /warehouse
Si alguna de esas rutas no aparece, revisa S2, S5 o S6 antes de
continuar. A continuación instalamos las dependencias de este notebook —las
mismas que en S6, PySpark y el cliente trino— y comprobamos, ya desde
Python, que las tablas Hive que S6 dejó registradas siguen ahí: son la
fuente de comparación de toda esta sesión.
Instalar las dependencias de este notebook
Como en S4, S5 y S6, el propio kernel instala PySpark sobre sí mismo. La
celda siguiente recrea requirements.txt con %%writefile para que este
notebook no dependa de ningún otro fichero de la distribución, tanto si lo
abres dentro de namenode como si usas «Existing Jupyter Server» desde tu
equipo.
%%writefile requirements.txt
# Dependencias del kernel interactivo de la sesión 7 (Spark local + cliente
# Trino, ambos hablando con el catálogo Iceberg sobre el mismo Hive
# Metastore). La serie de PySpark aceptada por el curso es >4,<4.2, igual que
# en S4, S5 y S6.
pyspark>4,<4.2
# Cliente DB-API 2.0 de Trino: es como este notebook consulta Trino sin usar
# el binario `trino` ni `docker exec` (el kernel corre dentro de namenode, no
# tiene acceso al Docker del host). Se fija la serie mayor para que el tipado
# de columnas y la representación de valores no cambien entre ejecuciones.
trino>=0.330,<1
pandas
%pip install -q -r requirements.txt
import re
import subprocess
import sys

import pandas
import pyspark
import trino

print(f"PySpark {pyspark.__version__} con Python {sys.version.split()[0]}.")
print(f"Cliente trino: {trino.__version__}")
print(f"Pandas: {pandas.__version__}")
Abrir la conexión con Trino
Reutilizamos exactamente el patrón de S6: el paquete trino de PyPI habla
el protocolo HTTP de Trino directamente contra el servicio trino-hdfs de
la red hadoop-cluster, sin CLI y sin docker exec. El catálogo por
defecto es hive —el mismo de S6—, aunque en el resto del notebook
escribiremos siempre los nombres completos (hive.tcdm.<tabla> o
iceberg.tcdm.<tabla>) para que cada sentencia se entienda sin depender del
contexto por defecto de la conexión.
import pandas as pd
from trino.dbapi import Connection, Cursor

trino_conn: Connection = trino.dbapi.connect(
    host="trino-hdfs",
    port=8080,
    user="luser",
    catalog="hive",
    schema="tcdm",
)


def run_trino(sql: str) -> pd.DataFrame:
    '''Ejecuta una sentencia en Trino y devuelve el resultado como DataFrame.'''
    cursor: Cursor = trino_conn.cursor()
    cursor.execute(sql)
    rows: list[tuple[object, ...]] = cursor.fetchall()
    columns: list[str] = [description[0] for description in cursor.description or []]
    return pd.DataFrame(rows, columns=columns)


run_trino("SELECT 1 AS ping")
run_trino("SHOW CATALOGS")
hive e iceberg deben aparecer los dos: son dos catálogos Trino
distintos que comparten el mismo Hive Metastore
(thrift://hive-metastore:9083) como se ve en
entorno/trino-hdfs/etc/catalog/hive.properties y en
entorno/trino-hdfs/etc/catalog/iceberg.properties
(connector.name=iceberg, iceberg.catalog.type=hive_metastore). El
catálogo hive interpreta las tablas como Parquet/ORC/CSV clásicos; el
catálogo iceberg interpreta esas mismas entradas de metastore como tablas
Iceberg cuando su propiedad table_type lo indica. Son dos lentes sobre el
mismo almacén de metadatos, no dos almacenes distintos.
tablas_s6: pd.DataFrame = run_trino("SHOW TABLES FROM hive.tcdm")
print(tablas_s6)

nombres_s6: set[str] = set(tablas_s6["Table"])
for tabla_esperada in ("date_dim", "web_sales_silver", "web_sales_by_year_gold"):
    assert (
        tabla_esperada in nombres_s6
    ), f"falta hive.tcdm.{tabla_esperada}: ejecuta S6 antes de continuar"
print("Las tres tablas Hive de S6 están registradas.")
filas_silver: pd.DataFrame = run_trino("SELECT count(*) AS filas FROM hive.tcdm.web_sales_silver")
filas_gold: pd.DataFrame = run_trino(
    "SELECT count(*) AS filas FROM hive.tcdm.web_sales_by_year_gold"
)
print("hive.tcdm.web_sales_silver:", filas_silver.loc[0, "filas"], "filas")
print("hive.tcdm.web_sales_by_year_gold:", filas_gold.loc[0, "filas"], "filas")

assert (
    int(filas_silver.loc[0, "filas"]) > 0
), "web_sales_silver está vacía: repite la sincronización de particiones de S6"
assert int(filas_gold.loc[0, "filas"]) > 0, "web_sales_by_year_gold está vacía: repite S5/S6"
Por qué no basta el modelo Hive
En S6, la tabla hive.tcdm.web_sales_silver se apoya en directorios
(sold_year=2000/sold_month=1/...) y en entradas de partición que el
metastore conoce sólo después de un paso explícito de sincronización
(sync_partition_metadata). Ese modelo resuelve "encontrar los datos", pero
dejaba abiertas varias preguntas que no llegamos a plantear en S6: ¿qué pasa
si una escritura deja varios ficheros a medio escribir? ¿Cómo sabe un lector
qué versión de la tabla está viendo si dos escrituras se solapan? ¿Cómo se
añade una columna sin reescribir todo el histórico? ¿Cómo se limpia una
versión antigua sin arriesgarse a borrar datos que otro lector todavía
necesita?
Iceberg no cambia el almacenamiento (sigue siendo Parquet en HDFS) ni elimina el catálogo (Trino y Spark lo siguen localizando por su nombre en el Hive Metastore). Lo que añade, por encima de ambos, es:
- metadatos de tabla versionados: cada estado de la tabla tiene un fichero
metadata.jsonpropio; - cada operación de escritura produce un nuevo snapshot, con su propio conjunto de ficheros de datos;
- los lectores ven siempre una versión coherente de la tabla, nunca un estado a medio escribir;
- el esquema puede evolucionar con reglas explícitas (añadir columnas, renombrarlas, ampliar tipos) sin reescribir los datos antiguos;
- el esquema de particionado puede cambiar sin tener que reorganizar de inmediato todos los ficheros ya escritos;
- los manifests permiten planificar una lectura a partir de metadatos, sin
tener que listar a ciegas todo el almacenamiento como haría un
MSCK REPAIR TABLE.
Iceberg frente a Delta Lake y Hudi
Iceberg no es el único formato de tabla abierto. Delta Lake y Apache Hudi resuelven el mismo problema —decidir qué ficheros Parquet forman cada versión de una tabla— y los tres ofrecen escrituras atómicas, consulta de versiones anteriores y evolución de esquema. Se diferencian en cómo guardan ese estado y en el uso para el que se diseñaron:
| Apache Iceberg | Delta Lake | Apache Hudi | |
|---|---|---|---|
| Origen | Netflix | Databricks | Uber |
| Dónde guarda el estado de la tabla | Árbol de metadatos: metadata.json, lista de manifests y manifests |
Registro de transacciones _delta_log/: un fichero JSON por escritura y checkpoints Parquet periódicos |
Línea de tiempo .hoodie/: una entrada por cada acción sobre la tabla |
| Particionado | Oculto, mediante transformaciones como month(ws_sold_date) |
Columnas de partición declaradas, como en Hive | Columnas de partición declaradas, como en Hive |
| Actualizaciones y borrados | Copy-on-write o merge-on-read, configurable en cada tabla | Copy-on-write, o merge-on-read mediante vectores de borrado | Copy-on-write o merge-on-read, según el tipo de tabla elegido al crearla, con un índice por clave de registro |
| Conector de Trino | Lectura y escritura | Lectura y escritura | Sólo lectura |
| Uso habitual | Tablas analíticas compartidas entre varios motores | Plataformas centradas en Spark y Databricks | Ingesta incremental con muchas actualizaciones por clave |
Esta sesión y la siguiente trabajan con Iceberg porque la misma tabla se crea desde Trino y se modifica desde Spark, y los dos motores escriben en ese formato. Los modos copy-on-write y merge-on-read de la tabla vuelven en S8, donde se compara su efecto físico sobre una tabla Iceberg.
Crear la tabla Iceberg
Empezamos por Trino: es el cliente SQL más sencillo para crear y examinar una tabla Iceberg, sin la
sobrecarga de arrancar antes una SparkSession. Más adelante leeremos la
misma tabla desde Spark y compararemos.
Vamos a crear dos tablas Iceberg mediante CREATE TABLE ... AS SELECT
(CTAS) a partir de las tablas Hive externas que ya registró S6. Un CTAS deja
intacta la tabla fuente —hive.tcdm.web_sales_silver sigue apuntando a
/datalake/silver/tpcds/web_sales— y crea una tabla nueva y gestionada
bajo /warehouse, con sus propios ficheros de datos y sus propios
metadatos. Es exactamente el mismo patrón "fuente externa → tabla
administrada" que ya viste en S6 con web_sales_by_year_managed_demo, sólo
que ahora la tabla administrada no es una tabla Hive más: es una tabla
Iceberg.
Estas dos tablas son las que usará también S8 para practicar ingesta continua con Spark Structured Streaming, así que sus nombres y columnas se mantienen exactamente como las dejamos aquí durante el resto del curso.
Por eso los dos CTAS llevan IF NOT EXISTS: si repites esta sesión —por
ejemplo, tras reiniciar el kernel— las tablas se conservan tal como estén,
incluidos los cambios que S8 haya hecho en ellas, en lugar de fallar o de
recrearse. Las comprobaciones que comparan cada tabla con su fuente Hive
sólo se aplican cuando la tabla se acaba de crear.
iceberg.tcdm.web_sales
Mantenemos las mismas columnas de negocio de web_sales_silver, incluida
ws_sold_date (tipo DATE): la necesitamos intacta porque es sobre ella
donde aplicaremos la transformación de partición oculta de Iceberg,
month(ws_sold_date). La clave compuesta de esta tabla sigue siendo
(ws_order_number, ws_item_sk) —es una tabla a nivel de línea de venta, un
mismo pedido puede tener varias líneas— y el CTAS que sigue no agrupa ni
deduplica filas, así que esa clave permanece única después de crear la
tabla.
run_trino("CREATE SCHEMA IF NOT EXISTS iceberg.tcdm")

tablas_iceberg_previas: set[str] = set(run_trino("SHOW TABLES FROM iceberg.tcdm")["Table"])
web_sales_recien_creada: bool = "web_sales" not in tablas_iceberg_previas
web_sales_by_year_recien_creada: bool = "web_sales_by_year" not in tablas_iceberg_previas

ctas_web_sales_sql: str = '''
CREATE TABLE IF NOT EXISTS iceberg.tcdm.web_sales
WITH (partitioning = ARRAY['month(ws_sold_date)']) AS
SELECT
    ws_order_number,
    ws_item_sk,
    ws_bill_customer_sk,
    ws_bill_addr_sk,
    ws_sold_date_sk,
    ws_sold_date,
    ws_quantity,
    ws_list_price,
    ws_ext_discount_amt,
    ws_ext_sales_price,
    ws_net_paid,
    ws_net_profit,
    sold_year,
    sold_month
FROM hive.tcdm.web_sales_silver
'''
run_trino(ctas_web_sales_sql)
if web_sales_recien_creada:
    print("iceberg.tcdm.web_sales creada.")
else:
    print("iceberg.tcdm.web_sales ya existía: se conserva tal como estaba.")
WITH (partitioning = ARRAY['month(ws_sold_date)']) es la sintaxis
real que expone el conector Iceberg de Trino para declarar una
transformación de partición: month deriva un valor de partición a partir
de ws_sold_date en el momento de escribir, sin que tengamos que crear ni
mantener nosotros mismos columnas auxiliares como sold_year/sold_month.
Particionado de Iceberg
recoge el resto de transformaciones disponibles (year, day, hour,
bucket, truncate...).
Comprobamos que el recuento de filas y la clave compuesta se conservan exactamente igual que en la tabla Hive de origen.
filas_hive: pd.DataFrame = run_trino("SELECT count(*) AS filas FROM hive.tcdm.web_sales_silver")
filas_iceberg: pd.DataFrame = run_trino("SELECT count(*) AS filas FROM iceberg.tcdm.web_sales")
print("hive.tcdm.web_sales_silver:", filas_hive.loc[0, "filas"], "filas")
print("iceberg.tcdm.web_sales:    ", filas_iceberg.loc[0, "filas"], "filas")
if web_sales_recien_creada:
    assert int(filas_hive.loc[0, "filas"]) == int(filas_iceberg.loc[0, "filas"])
else:
    print("La tabla ya existía: puede incluir cambios posteriores a su creación (S8).")

clave_compuesta: pd.DataFrame = run_trino('''
    SELECT
        (SELECT count(*) FROM iceberg.tcdm.web_sales) AS filas,
        (SELECT count(*) FROM (
            SELECT DISTINCT ws_order_number, ws_item_sk FROM iceberg.tcdm.web_sales
        )) AS claves_distintas
''')
print(clave_compuesta)
assert int(clave_compuesta.loc[0, "filas"]) == int(
    clave_compuesta.loc[0, "claves_distintas"]
), "la clave (ws_order_number, ws_item_sk) ha dejado de ser única: revisa el CTAS"
print("La clave (ws_order_number, ws_item_sk) sigue siendo única en iceberg.tcdm.web_sales.")
iceberg.tcdm.web_sales_by_year
El agregado de negocio no necesita ninguna transformación de partición: es
una tabla pequeña, pensada para leerse entera, exactamente igual que su
fuente hive.tcdm.web_sales_by_year_gold.
ctas_web_sales_by_year_sql: str = '''
CREATE TABLE IF NOT EXISTS iceberg.tcdm.web_sales_by_year AS
SELECT d_year, pedidos, lineas_de_venta, beneficio_neto
FROM hive.tcdm.web_sales_by_year_gold
'''
run_trino(ctas_web_sales_by_year_sql)
if web_sales_by_year_recien_creada:
    print("iceberg.tcdm.web_sales_by_year creada.")
else:
    print("iceberg.tcdm.web_sales_by_year ya existía: se conserva tal como estaba.")
comparacion_gold: pd.DataFrame = run_trino('''
    SELECT count(*) AS filas, sum(beneficio_neto) AS beneficio_total
    FROM iceberg.tcdm.web_sales_by_year
''')
comparacion_gold_hive: pd.DataFrame = run_trino('''
    SELECT count(*) AS filas, sum(beneficio_neto) AS beneficio_total
    FROM hive.tcdm.web_sales_by_year_gold
''')
print("iceberg.tcdm.web_sales_by_year:    ", comparacion_gold.to_dict("records")[0])
print("hive.tcdm.web_sales_by_year_gold:  ", comparacion_gold_hive.to_dict("records")[0])
if web_sales_by_year_recien_creada:
    assert comparacion_gold.loc[0, "filas"] == comparacion_gold_hive.loc[0, "filas"]
else:
    print("La tabla ya existía: puede incluir cambios posteriores a su creación (S8).")
Un metastore también puede guardar un comentario de tabla para una tabla
Iceberg. Lo añadimos con COMMENT ON TABLE y lo comprobamos en el propio
SHOW CREATE TABLE — es la contrapartida ejecutable de la buena práctica
«documentar el propietario, el esquema y la ubicación» que veremos al final
de la sesión, la misma que ya demostramos en S6 con las tablas Hive.
run_trino('''
    COMMENT ON TABLE iceberg.tcdm.web_sales IS
    'Ventas web de TPC-DS SF1 a nivel de línea, creada por CTAS desde hive.tcdm.web_sales_silver (ver S7).'
''')
run_trino("SHOW CREATE TABLE iceberg.tcdm.web_sales")
A partir de aquí, iceberg.tcdm.web_sales e iceberg.tcdm.web_sales_by_year
son las dos tablas de referencia de esta sesión —y las que reutilizará
S8—. El resto de tablas Iceberg que crearemos más adelante para provocar
ficheros pequeños, experimentar con ordenación física o repetir la
evolución de esquema con más libertad se llamarán siempre
iceberg.tcdm.web_sales_lab_*, precisamente para que quede claro de un
vistazo cuáles son desechables y cuáles no.
Observar la definición y la ubicación
No debemos suponer dónde ha quedado físicamente la tabla: el catálogo puede
elegir un directorio con un sufijo único, como ya viste en S6 con
web_sales_by_year_managed_demo. Lo confirmamos con SHOW CREATE TABLE y
extraemos la ubicación real con una expresión regular, igual que
comprobamos en Python en toda esta sesión.
ddl_web_sales: pd.DataFrame = run_trino("SHOW CREATE TABLE iceberg.tcdm.web_sales")
ddl_web_sales_texto: str = ddl_web_sales.iloc[0, 0]
print(ddl_web_sales_texto)
def ubicacion_de_tabla_iceberg(ddl_texto: str) -> str:
    '''Extrae la ruta HDFS declarada en la propiedad location de un SHOW CREATE TABLE.'''
    coincidencia: re.Match[str] | None = re.search(r"location = '([^']+)'", ddl_texto)
    assert coincidencia is not None, "SHOW CREATE TABLE no contiene una propiedad location"
    return coincidencia.group(1)


ubicacion_web_sales: str = ubicacion_de_tabla_iceberg(ddl_web_sales_texto)
print("Ubicación real de iceberg.tcdm.web_sales:", ubicacion_web_sales)
assert ubicacion_web_sales.startswith(
    "hdfs://namenode:9000/warehouse/tcdm.db/web_sales-"
), "la ubicación no sería la esperada bajo /warehouse/tcdm.db/"
El patrón es /warehouse/tcdm.db/web_sales-<identificador>, no
simplemente /warehouse/tcdm.db/web_sales: Trino añade un sufijo único para
evitar colisiones si en algún momento se crea y se borra una tabla con el
mismo nombre. Miramos ahora dentro de esa ruta en HDFS, distinguiendo el
directorio data (los ficheros Parquet) del directorio metadata
(manifests, snapshots y ficheros *.metadata.json).
Como en S4, la celda !orden siguiente interpola una variable de Python
escribiendo {variable} dentro de la orden de shell: así evitamos
reconstruir la ruta a mano y nos aseguramos de listar exactamente la
ubicación que acaba de confirmar Trino.
!hdfs dfs -ls -R -h {ubicacion_web_sales}
Deberías distinguir tres cosas en ese listado:
data/ws_sold_date_month=2000-01/...parquety directorios equivalentes para cada mes: son los ficheros de datos. El nombre del directorio contiene el valor de la transformación de partición (month), pero no es una columna que aparezca en el esquema de la tabla ni que el usuario tenga que mantener: es Iceberg quien decide, escribe y luego lee ese directorio a partir dews_sold_date. Por eso se llama partición oculta.metadata/*.metadata.json: un fichero por cada versión del esquema y la configuración de la tabla.metadata/*.avroymetadata/snap-*.avro: los manifests y la lista de manifests de cada snapshot.
Compáralo mentalmente con lo que ya conoces de
hive.tcdm.web_sales_silver en S6: allí los directorios
sold_year=2000/sold_month=1/ son columnas de partición reales, declaradas
en el CREATE TABLE y sincronizadas explícitamente con
sync_partition_metadata. Aquí no hemos declarado ninguna columna de
partición adicional ni hemos tenido que sincronizar nada: Iceberg ya sabe
qué ficheros pertenecen a cada mes porque lo registra en sus propios
manifests, no en el listado de particiones del Hive Metastore.
Leer desde Trino y Spark
iceberg.tcdm.web_sales ya existe y ya hemos comprobado su contenido con
Trino. Toca ahora construir una SparkSession capaz de leer la misma tabla,
igual que en S6 hicimos con hive.tcdm.web_sales_silver.
Configurar Spark para Iceberg
Partimos de la misma base de S6 —spark.hadoop.hive.metastore.uris,
spark.sql.warehouse.dir, spark.sql.catalogImplementation=hive y
enableHiveSupport()— y añadimos lo necesario para que Spark entienda el
formato de tabla Iceberg y lo resuelva por catálogo, exactamente igual que
ya hace con las tablas Hive:
spark.jars.packagescon la coordenada Mavenorg.apache.iceberg:iceberg-spark-runtime-4.1_2.13:1.11.0. El sufijo4.1_2.13no es arbitrario: identifica la versión de Spark (4.1) y de Scala (2.13) para las que se compiló ese conector, y son exactamente las que fijaentorno/spark/Dockerfile(apache/spark:4.1.3-scala2.13-java21-python3-ubuntu,ARG ICEBERG_VERSION=1.11.0) para el contenedorspark-icebergde la ruta S3 de este mismo entorno. La versión de PySpark que instalarequirements.txt(>4,<4.2) resuelve hoy a la4.1.3, así que usamos la misma coordenada Iceberg aquí.spark.sql.extensionsconorg.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions, el mismo valor que ya declaraentorno/spark/spark-defaults.confpara el contenedorspark-iceberg: sin esta extensión, Spark no reconoce sentencias específicas de Iceberg comoCALLa procedimientos del sistema o ciertas cláusulas deMERGE INTOque usará S8.un catálogo con nombre
iceberg, de tipohive, apuntando exactamente al mismo Hive Metastore que ya usa Trino para su propio catálogoiceberg:spark.sql.catalog.iceberg = org.apache.iceberg.spark.SparkCatalogspark.sql.catalog.iceberg.type = hivespark.sql.catalog.iceberg.uri = thrift://hive-metastore:9083spark.sql.catalog.iceberg.warehouse = hdfs://namenode:9000/warehouse
Con esto, Spark resuelve iceberg.tcdm.web_sales por su nombre de catálogo
exactamente igual que ya resuelve tcdm.web_sales_silver por el catálogo
Hive nativo: no hace falta ninguna ruta física ni ningún paso adicional.
El catálogo Iceberg de Spark y el Hive Metastore
El catálogo spark.sql.catalog.iceberg de Spark habla con el mismo Hive
Metastore que usa Trino porque este entorno fija la versión 3.1.3; la
justificación completa —incluyendo por qué no se elige sin más una versión
más reciente de la rama 4.x— está en entorno/README.md, sección
"Versiones fijadas y compatibilidad".
from pyspark import SparkContext
from pyspark.sql import DataFrame, SparkSession

HIVE_METASTORE_URIS: str = "thrift://hive-metastore:9083"
WAREHOUSE_DIR: str = "hdfs://namenode:9000/warehouse"
ICEBERG_VERSION: str = "1.11.0"
ICEBERG_SPARK_PACKAGE: str = f"org.apache.iceberg:iceberg-spark-runtime-4.1_2.13:{ICEBERG_VERSION}"

spark: SparkSession = (
    SparkSession.builder.appName("TCDM_S7_Local")
    .master("local[2]")
    .config("spark.driver.memory", "1g")
    .config("spark.sql.shuffle.partitions", "8")
    .config("spark.hadoop.hive.metastore.uris", HIVE_METASTORE_URIS)
    .config("spark.sql.warehouse.dir", WAREHOUSE_DIR)
    .config("spark.sql.catalogImplementation", "hive")
    .config("spark.jars.packages", ICEBERG_SPARK_PACKAGE)
    .config(
        "spark.sql.extensions", "org.apache.iceberg.spark.extensions.IcebergSparkSessionExtensions"
    )
    .config("spark.sql.catalog.iceberg", "org.apache.iceberg.spark.SparkCatalog")
    .config("spark.sql.catalog.iceberg.type", "hive")
    .config("spark.sql.catalog.iceberg.uri", HIVE_METASTORE_URIS)
    .config("spark.sql.catalog.iceberg.warehouse", WAREHOUSE_DIR)
    .enableHiveSupport()
    .getOrCreate()
)
sc: SparkContext = spark.sparkContext

print(f"Spark version: {spark.version} | Master: {sc.master}")
print(f"Metastore URIs: {HIVE_METASTORE_URIS}")
print(f"Warehouse dir: {WAREHOUSE_DIR}")
print(f"Paquete Iceberg: {ICEBERG_SPARK_PACKAGE}")
print("Catálogo 'iceberg' configurado como tipo hive contra el mismo metastore.")
La primera ejecución de esta celda tarda más de lo habitual: Spark
tiene que descargar el jar de iceberg-spark-runtime desde Maven Central a
través de Ivy. Las siguientes ejecuciones reutilizan la caché local.
Comprobamos primero que el catálogo Hive nativo de Spark sigue viendo las tablas de S6, igual que en esa sesión.
spark.sql("SHOW TABLES IN tcdm").show()

web_sales_silver_spark: DataFrame = spark.table("tcdm.web_sales_silver")
web_sales_silver_spark.printSchema()
print("Filas en tcdm.web_sales_silver (Spark):", web_sales_silver_spark.count())
Leer la tabla Iceberg por su nombre de catálogo
Con el catálogo spark.sql.catalog.iceberg ya configurado, Spark resuelve
iceberg.tcdm.web_sales exactamente igual que resuelve
tcdm.web_sales_silver por el catálogo Hive nativo: sin construir ninguna
ruta a mano ni depender de dónde ha decidido colocar Trino los ficheros
físicamente.
web_sales_spark: DataFrame = spark.table("iceberg.tcdm.web_sales")
web_sales_spark.printSchema()
Repetimos, con Spark, la misma comparación de negocio que ya
distinguía S2: líneas de venta (count(*)) frente a pedidos distintos
(count(DISTINCT ws_order_number)), y comprobamos que Trino y Spark
devuelven exactamente el mismo resultado sobre la misma tabla Iceberg.
resultado_trino: pd.DataFrame = run_trino('''
    SELECT count(*) AS lineas_de_venta, count(DISTINCT ws_order_number) AS pedidos
    FROM iceberg.tcdm.web_sales
''')
resultado_spark: pd.DataFrame = web_sales_spark.selectExpr(
    "count(*) AS lineas_de_venta", "count(DISTINCT ws_order_number) AS pedidos"
).toPandas()

print("Trino:", resultado_trino.to_dict("records")[0])
print("Spark:", resultado_spark.to_dict("records")[0])

assert resultado_trino.loc[0, "lineas_de_venta"] == resultado_spark.loc[0, "lineas_de_venta"]
assert resultado_trino.loc[0, "pedidos"] == resultado_spark.loc[0, "pedidos"]
print("Trino y Spark coinciden sobre iceberg.tcdm.web_sales.")
Particionado Hive frente a particionado Iceberg
En S6, hive.tcdm.web_sales_silver tiene columnas de partición visibles:
sold_year y sold_month aparecen en el DESCRIBE, en cada fila devuelta
por SELECT *, y sus valores están codificados en los nombres de los
directorios (sold_year=2000/sold_month=1/). El metastore sólo conoce esas
particiones después de un paso explícito de descubrimiento
(sync_partition_metadata), y si alguien cambiara el esquema de
particionado tendría que reescribir esa organización de directorios y
repetir el descubrimiento.
En iceberg.tcdm.web_sales, la partición es una transformación
(month(ws_sold_date)) sobre una columna que ya existía: no hemos añadido
ninguna columna nueva al esquema lógico de la tabla, y no hace falta ningún
paso de sincronización porque Iceberg registra en sus propios manifests, en
el momento de cada escritura, qué fichero pertenece a qué valor de
partición. Quien filtra por ws_sold_date no necesita saber que esa
columna está particionada por mes: el motor decide solo qué ficheros puede
descartar.
Comparamos el plan de una misma consulta —filtrar por el primer mes de 2000— en las dos tablas.
explain_hive_particionada: pd.DataFrame = run_trino('''
    EXPLAIN SELECT count(*) FROM hive.tcdm.web_sales_silver
    WHERE sold_year = 2000 AND sold_month = 1
''')
print("\n".join(explain_hive_particionada.iloc[:, 0].tolist()))
explain_iceberg_transformada: pd.DataFrame = run_trino('''
    EXPLAIN SELECT count(*) FROM iceberg.tcdm.web_sales
    WHERE ws_sold_date >= DATE '2000-01-01' AND ws_sold_date < DATE '2000-02-01'
''')
print("\n".join(explain_iceberg_transformada.iloc[:, 0].tolist()))
En el primer plan, la poda ocurre sobre las columnas de partición
declaradas (sold_year, sold_month), que el usuario tuvo que escribir en
el WHERE sabiendo que existían como columnas de partición. En el segundo,
filtramos únicamente por ws_sold_date —la columna de negocio, la misma
que ya usábamos en S2 y S4— y el planificador de Trino traduce ese rango de
fechas al valor de partición month que corresponde, sin que hayamos
tenido que mencionar ninguna columna de partición en la consulta. Busca en
ambos planes la parte del TableScan/IcebergScan para confirmar que el
filtrado ocurre antes de leer los ficheros de datos y no como un Filter
posterior.
Repetimos la comparación con Spark, ahora que ya tenemos las dos tablas disponibles en la sesión.
spark.sql('''
    SELECT count(*) FROM tcdm.web_sales_silver
    WHERE sold_year = 2000 AND sold_month = 1
''').explain("formatted")
web_sales_spark.filter(
    "ws_sold_date >= DATE'2000-01-01' AND ws_sold_date < DATE'2000-02-01'"
).selectExpr("count(*)").explain("formatted")
No se debe concluir de aquí que Iceberg "hace innecesario" pensar en
particiones: una transformación mal elegida —por ejemplo, particionar por
ws_order_number o por bucket con un número de cubos excesivo— puede
seguir produciendo demasiados ficheros pequeños, exactamente el problema que
mediremos más adelante en esta misma sesión. Lo que cambia es quién
mantiene la relación entre el valor lógico y el directorio físico: en Hive,
el usuario; en Iceberg, el propio formato de tabla.
Snapshots y evolución
iceberg.tcdm.web_sales ya tiene un primer snapshot: el que produjo el
propio CTAS. Lo consultamos con la tabla de metadatos $snapshots, la misma
convención <tabla>$metadato que ya usaste en S6 para $partitions.
snapshots_web_sales: pd.DataFrame = run_trino('''
    SELECT snapshot_id, committed_at, operation
    FROM iceberg.tcdm."web_sales$snapshots"
    ORDER BY committed_at
''')
snapshots_web_sales
Un único snapshot, con operation = 'append' (así etiqueta Iceberg un
CTAS: es, en el fondo, una escritura que añade el primer conjunto de
ficheros). Si repites esta sesión después de S8, verás además los snapshots
que dejó el streaming. Antes de seguir experimentando con inserciones, cambios de
esquema y viajes en el tiempo, vamos a decidir dónde hacerlo.
Por qué no seguimos experimentando sobre iceberg.tcdm.web_sales a partir
de aquí. El ejemplo más simple de una nueva tanda de datos sería
reinsertar un subconjunto ya existente de la propia tabla. Pero
iceberg.tcdm.web_sales
tiene un contrato con S8: su clave compuesta (ws_order_number, ws_item_sk) debe seguir siendo única, porque S8 hará un MERGE INTO sobre
exactamente esa pareja de columnas. Reinsertar filas que ya existen
—aunque sea sólo para ver aparecer un segundo snapshot— rompería esa unicidad
para el resto del curso. Por eso, para la parte de la sesión que
experimenta con nuevas versiones, columnas nuevas y viajes en el tiempo,
trabajamos sobre una copia de laboratorio,
iceberg.tcdm.web_sales_lab_evolution, creada con el mismo CTAS y que
podemos manipular con total libertad sin afectar a la tabla que reutilizará
S8. iceberg.tcdm.web_sales queda así con un único snapshot, exactamente el
que dejó su creación, y su clave compuesta intacta.
run_trino("DROP TABLE IF EXISTS iceberg.tcdm.web_sales_lab_evolution")
run_trino(
    "CREATE TABLE iceberg.tcdm.web_sales_lab_evolution AS SELECT * FROM iceberg.tcdm.web_sales"
)
print("iceberg.tcdm.web_sales_lab_evolution creada como copia de laboratorio.")

snapshots_lab_inicial: pd.DataFrame = run_trino('''
    SELECT snapshot_id, operation FROM iceberg.tcdm."web_sales_lab_evolution$snapshots"
''')
snapshots_lab_inicial
Insertar una nueva tanda de datos
Insertamos un pedido nuevo, con una pareja (ws_order_number, ws_item_sk)
que no existía todavía, para que el snapshot que se genera represente una
escritura real de datos nuevos y no una duplicación de la clave. En lugar de
inventar un número de pedido a mano —que podría coincidir por casualidad con
uno real de TPC-DS—, calculamos uno que no puede colisionar:
max(ws_order_number) + 1 sobre la propia tabla.
Esta fila de laboratorio copia ws_sold_date_sk de una fila real sin
recalcularla para la fecha 2000-06-15 que fijamos a mano: la clave
surrogate y la fecha derivada no se corresponden. No afecta a esta tabla de
laboratorio —sólo sirve para observar el efecto del INSERT en los
snapshots—, pero no la tomes como ejemplo del contrato
ws_sold_date/ws_sold_date_sk que sí se respeta en
iceberg.tcdm.web_sales.
nuevo_order_number = run_trino(
    "SELECT max(ws_order_number) + 1 AS siguiente FROM iceberg.tcdm.web_sales_lab_evolution"
).loc[0, "siguiente"]
print("Nuevo ws_order_number, garantizado libre:", nuevo_order_number)

run_trino(f'''
    INSERT INTO iceberg.tcdm.web_sales_lab_evolution
    SELECT
        {nuevo_order_number} AS ws_order_number,
        ws_item_sk, ws_bill_customer_sk, ws_bill_addr_sk, ws_sold_date_sk,
        DATE '2000-06-15' AS ws_sold_date,
        ws_quantity, ws_list_price, ws_ext_discount_amt, ws_ext_sales_price,
        ws_net_paid, ws_net_profit,
        2000 AS sold_year, 6 AS sold_month
    FROM iceberg.tcdm.web_sales_lab_evolution
    LIMIT 1
''')

snapshots_tras_insert: pd.DataFrame = run_trino('''
    SELECT snapshot_id, committed_at, operation
    FROM iceberg.tcdm."web_sales_lab_evolution$snapshots"
    ORDER BY committed_at
''')
snapshots_tras_insert
assert (
    len(snapshots_tras_insert) == len(snapshots_lab_inicial) + 1
), "debería haber un snapshot más tras el INSERT"
snapshot_inicial_id: int = int(snapshots_tras_insert.loc[0, "snapshot_id"])
snapshot_tras_insert_id: int = int(
    snapshots_tras_insert.loc[len(snapshots_tras_insert) - 1, "snapshot_id"]
)
print("Snapshot inicial:      ", snapshot_inicial_id)
print("Snapshot tras INSERT:  ", snapshot_tras_insert_id)
Evolución de esquema
Añadimos una columna nueva y compatible —canal_venta, para anotar en el
futuro por qué canal llegó cada línea de venta—. Es una evolución segura:
no cambia ni renombra ninguna columna existente, y las filas ya escritas
simplemente no tienen valor en la columna nueva.
run_trino("ALTER TABLE iceberg.tcdm.web_sales_lab_evolution ADD COLUMN canal_venta VARCHAR")
run_trino("DESCRIBE iceberg.tcdm.web_sales_lab_evolution")
filas_tras_evolucion: pd.DataFrame = run_trino('''
    SELECT count(*) AS filas, count(canal_venta) AS filas_con_canal
    FROM iceberg.tcdm.web_sales_lab_evolution
''')
print(filas_tras_evolucion)
assert (
    int(filas_tras_evolucion.loc[0, "filas_con_canal"]) == 0
), "las filas antiguas no deberían tener valor en la columna nueva"
print("Las filas anteriores a la evolución de esquema se siguen leyendo, con canal_venta a NULL.")
Consultar una versión anterior
Con el identificador del snapshot inicial —el que capturamos antes del
INSERT—, Trino permite viajar en el tiempo con FOR VERSION AS OF. Es la
prueba de que Iceberg no ha "editado" la tabla en el sitio: ha añadido un
snapshot nuevo, y el anterior sigue siendo legible tal cual era, con su
esquema y sus filas de entonces.
conteo_snapshot_inicial: pd.DataFrame = run_trino(f'''
    SELECT count(*) AS filas FROM iceberg.tcdm.web_sales_lab_evolution
    FOR VERSION AS OF {snapshot_inicial_id}
''')
conteo_actual: pd.DataFrame = run_trino(
    "SELECT count(*) AS filas FROM iceberg.tcdm.web_sales_lab_evolution"
)

print("Filas en el snapshot inicial:", conteo_snapshot_inicial.loc[0, "filas"])
print("Filas en la versión actual:  ", conteo_actual.loc[0, "filas"])
assert int(conteo_actual.loc[0, "filas"]) == int(conteo_snapshot_inicial.loc[0, "filas"]) + 1
También se puede viajar en el tiempo por fecha con FOR TIMESTAMP AS OF <timestamp>, útil cuando no se ha guardado el identificador del
snapshot pero sí se sabe aproximadamente cuándo se escribió la versión que
se busca. Ambas cláusulas son sintaxis real de Trino sobre el conector
Iceberg, no HiveQL.
La misma exploración desde Spark
Leemos la misma copia de laboratorio directamente por su nombre de
catálogo, iceberg.tcdm.web_sales_lab_evolution —Spark ve automáticamente
tanto el INSERT como el ALTER TABLE, porque los dos ya están
comprometidos en el catálogo— y consultamos su tabla de metadatos de
snapshots con la sintaxis de Spark para tablas de catálogo:
<catalogo>.<esquema>.<tabla>.snapshots.
lab_evolution_spark: DataFrame = spark.table("iceberg.tcdm.web_sales_lab_evolution")
lab_evolution_spark.printSchema()
print("Filas (Spark):", lab_evolution_spark.count())
snapshots_spark: DataFrame = spark.table("iceberg.tcdm.web_sales_lab_evolution.snapshots")
snapshots_spark.select("snapshot_id", "operation").show(truncate=False)
Y viajamos en el tiempo desde Spark con la opción versionAsOf del
lector Iceberg —la misma opción nativa que usa Spark para cualquier tabla
que soporte viajar en el tiempo, no una opción propia de Iceberg— apuntando
siempre al mismo identificador de tabla del catálogo. Iceberg admite un
identificador de snapshot o el nombre de una rama/etiqueta como valor de
versionAsOf; las opciones snapshot-id/as-of-timestamp que definía el
propio conector Iceberg han quedado obsoletas a favor de esta sintaxis
común de Spark.
spark_snapshot_inicial: DataFrame = spark.read.option("versionAsOf", snapshot_inicial_id).table(
    "iceberg.tcdm.web_sales_lab_evolution"
)
print("Filas en el snapshot inicial (Spark):", spark_snapshot_inicial.count())
assert spark_snapshot_inicial.count() == int(conteo_snapshot_inicial.loc[0, "filas"])
print("Trino y Spark coinciden al viajar en el tiempo al mismo snapshot.")
Metodología de medición
A partir de aquí la sesión cambia de pregunta. Ya existe una tabla Iceberg, ya sabemos crearla, leerla desde dos motores y hacerla evolucionar. Toca decidir qué hace falta para que sea eficiente, y comprobarlo, no sólo suponerlo.
TPC-DS SF1 es lo bastante grande para trabajar con datos realistas durante el curso, pero puede ser demasiado pequeño —y este entorno, al ejecutarse en contenedores Docker compartiendo máquina con el resto del portátil o del servidor de sesiones, demasiado variable— para que el tiempo de pared de una consulta sea una medida fiable. Ya lo advertían S4, S5 y S6 con sus propias consultas, y aquí no es distinto: no vamos a apoyar ninguna conclusión de esta sesión en "esta consulta tardó menos". En su lugar, para cada experimento dejamos constancia de:
- la consulta y los predicados exactos usados;
- el número y tamaño de los ficheros de datos involucrados;
- el número de particiones y de manifests;
- el plan lógico y físico (
EXPLAINen Trino,.explain("formatted")en Spark); - las estadísticas disponibles antes y después de cada cambio;
- el resultado de negocio, para confirmar que la optimización no ha alterado los números;
- la configuración relevante de Spark o Trino que hace posible la comparación.
Proyección y filtros
Antes de tocar particiones, compactación u ordenación, la primera
comprobación es la más básica: leer sólo las columnas necesarias y aplicar
el filtro lo antes posible. Retomamos la comparación de S2 y S4 entre
SELECT * y una proyección estrecha con filtro, ahora sobre
iceberg.tcdm.web_sales.
explain_select_estrella: pd.DataFrame = run_trino("EXPLAIN SELECT * FROM iceberg.tcdm.web_sales")
print("\n".join(explain_select_estrella.iloc[:, 0].tolist()))
explain_proyeccion_filtro: pd.DataFrame = run_trino('''
    EXPLAIN SELECT ws_order_number, ws_net_paid
    FROM iceberg.tcdm.web_sales
    WHERE ws_sold_date >= DATE '2000-01-01' AND ws_sold_date < DATE '2000-02-01'
''')
print("\n".join(explain_proyeccion_filtro.iloc[:, 0].tolist()))
Fíjate en la lista de columnas (outputSymbols o equivalente) del
TableScan/IcebergScan de cada plan: el segundo debería mostrar sólo
ws_order_number y ws_net_paid, además del predicado sobre
ws_sold_date. Esa reducción ocurre gracias al formato columnar de Parquet,
a las estadísticas por fichero que ya guarda Iceberg en sus manifests
(mínimo, máximo y nulos por columna) y al propio planificador de Trino: no
es una técnica exclusiva de Iceberg, pero Iceberg la aprovecha mejor porque
sus manifests ya incluyen estadísticas por fichero sin tener que abrir cada
Parquet para leer su footer. No tiene sentido saltar directamente a
compactación u ordenación si todavía se están leyendo todas las columnas o
todas las particiones de la tabla.
Repetimos la comparación con Spark.
web_sales_spark.explain("formatted")
web_sales_spark.select("ws_order_number", "ws_net_paid").filter(
    "ws_sold_date >= DATE'2000-01-01' AND ws_sold_date < DATE'2000-02-01'"
).explain("formatted")
Particiones de datos
Ya comparamos antes el particionado visible de Hive con la transformación
oculta de Iceberg. Cerramos la comparación añadiendo una tercera variante: el
Parquet sin particionar de la capa raw, tal y como S2 lo dejó en
/datalake/raw/tpcds/web_sales. Registramos esa ruta como una tabla externa
efímera —sólo para esta comparación— para poder consultarla con SQL.
run_trino("DROP TABLE IF EXISTS hive.tcdm.web_sales_raw_sin_particionar")
run_trino('''
    CREATE TABLE hive.tcdm.web_sales_raw_sin_particionar (
        ws_sold_date_sk BIGINT,
        ws_order_number BIGINT,
        ws_item_sk BIGINT
    ) WITH (
        format = 'PARQUET',
        external_location = 'hdfs://namenode:9000/datalake/raw/tpcds/web_sales'
    )
''')
print(
    "hive.tcdm.web_sales_raw_sin_particionar registrada (sólo columnas necesarias para esta comparación)."
)
Comparamos ahora el plan de una consulta equivalente —contar líneas
de venta del año 2000— sobre las tres variantes. La tabla raw no tiene
ninguna columna de fecha ya calculada como ws_sold_date, así que el filtro
tiene que apoyarse en el rango de ws_sold_date_sk que corresponde a ese
año (podemos obtenerlo de date_dim, la tabla que ya registró S6).
rango_2000: pd.DataFrame = run_trino('''
    SELECT min(d_date_sk) AS primero, max(d_date_sk) AS ultimo
    FROM hive.tcdm.date_dim WHERE d_year = 2000
''')
primer_sk_2000: int = int(rango_2000.loc[0, "primero"])
ultimo_sk_2000: int = int(rango_2000.loc[0, "ultimo"])
print(f"Claves d_date_sk de 2000: {primer_sk_2000}..{ultimo_sk_2000}")
explain_raw: pd.DataFrame = run_trino(f'''
    EXPLAIN SELECT count(*) FROM hive.tcdm.web_sales_raw_sin_particionar
    WHERE ws_sold_date_sk BETWEEN {primer_sk_2000} AND {ultimo_sk_2000}
''')
print("=== Parquet sin particionar (raw) ===")
print("\n".join(explain_raw.iloc[:, 0].tolist()))
explain_hive_2000: pd.DataFrame = run_trino('''
    EXPLAIN SELECT count(*) FROM hive.tcdm.web_sales_silver WHERE sold_year = 2000
''')
print("=== Hive particionada por sold_year/sold_month (silver, S6) ===")
print("\n".join(explain_hive_2000.iloc[:, 0].tolist()))
explain_iceberg_2000: pd.DataFrame = run_trino('''
    EXPLAIN SELECT count(*) FROM iceberg.tcdm.web_sales
    WHERE ws_sold_date >= DATE '2000-01-01' AND ws_sold_date < DATE '2001-01-01'
''')
print("=== Iceberg con transformación month(ws_sold_date) ===")
print("\n".join(explain_iceberg_2000.iloc[:, 0].tolist()))
En el primer plan no hay poda de particiones: el catálogo no sabe nada de
la distribución por fecha de web_sales en raw, así que Trino considera
todos sus ficheros — aunque sí puede seguir usando las estadísticas de
footer de cada Parquet para descartar row groups dentro de un fichero,
que no es lo mismo que descartar directorios o ficheros enteros sin
abrirlos. En el segundo plan, la poda ocurre sobre las particiones Hive
sold_year/sold_month que ya conoces de S6. En el tercero, la poda ocurre
sobre la transformación month(ws_sold_date), sin que hayamos tenido que
declarar ninguna columna de partición.
Una advertencia que conviene no perder de vista: particionar por una clave
de alta cardinalidad —un ws_order_number o un bucket con demasiados
cubos para el volumen de datos de SF1— puede producir tantas particiones
pequeñas que el coste de planificación (leer y combinar muchos manifests
pequeños) supere al beneficio de la poda. La transformación temporal que
hemos elegido aquí (month) es razonable porque el número de meses de
TPC-DS SF1 es pequeño y coincide con cómo se suelen filtrar los datos de
ventas en las consultas de negocio.
Retiramos la tabla temporal raw que hemos usado sólo para esta
comparación: es una definición de catálogo efímera, y DROP TABLE sobre una
tabla externa no toca los Parquet de /datalake/raw.
run_trino("DROP TABLE hive.tcdm.web_sales_raw_sin_particionar")
print("Definición temporal retirada; /datalake/raw/tpcds/web_sales no se ha visto afectado.")
Estadísticas
Las estadísticas ayudan al planificador a estimar filas, tamaños y el coste
de un JOIN, pero conviene no confundir varias capas: las estadísticas de
los footers de Parquet (mínimo, máximo, nulos por columna, por fichero),
las estadísticas de tabla/partición del Hive Metastore que ya viste en S6
con ANALYZE, y las estadísticas de tabla propias de Iceberg, que agregan
la información de los manifests. ANALYZE sobre una tabla Iceberg en Trino
alimenta esta última capa.
No prejuzgamos el resultado: comparamos el plan antes y después, y explicamos si la información adicional cambia realmente la decisión del motor, en lugar de asumir que siempre lo hace.
stats_antes: pd.DataFrame = run_trino("SHOW STATS FOR iceberg.tcdm.web_sales")
stats_antes
Antes de ejecutar ANALYZE, capturamos también el plan de un JOIN
con date_dim —la misma unión que ya usábamos en S2 para relacionar
ws_sold_date_sk con el año de negocio—, para tener con qué comparar
después.
explain_join_antes_texto: str = "\n".join(run_trino('''
    EXPLAIN SELECT w.ws_order_number, d.d_year
    FROM iceberg.tcdm.web_sales w
    JOIN hive.tcdm.date_dim d ON w.ws_sold_date_sk = d.d_date_sk
    WHERE d.d_year = 2000
''').iloc[:, 0].tolist())
print(explain_join_antes_texto)
run_trino("ANALYZE iceberg.tcdm.web_sales")
stats_despues: pd.DataFrame = run_trino("SHOW STATS FOR iceberg.tcdm.web_sales")
stats_despues
explain_join_despues_texto: str = "\n".join(run_trino('''
    EXPLAIN SELECT w.ws_order_number, d.d_year
    FROM iceberg.tcdm.web_sales w
    JOIN hive.tcdm.date_dim d ON w.ws_sold_date_sk = d.d_date_sk
    WHERE d.d_year = 2000
''').iloc[:, 0].tolist())
print(explain_join_despues_texto)

print()
print(
    "Planes idénticos antes y después de ANALYZE:",
    explain_join_antes_texto == explain_join_despues_texto,
)
Compara stats_antes y stats_despues: antes de ANALYZE, columnas
como distinct_values_count o data_size suelen venir vacías o son
estimaciones muy toscas basadas sólo en el tamaño de los ficheros; después,
cada columna trae una estimación calculada sobre los datos reales, y
aparece row_count en la fila final. Ahora bien: en una tabla tan pequeña
como la de esta sesión (SF1, unos cientos de miles de líneas de venta), es
perfectamente posible que explain_join_antes_texto y
explain_join_despues_texto resulten idénticos —Trino puede elegir el mismo
tipo de JOIN con o sin estadísticas si el volumen de datos ya es pequeño
de por sí—. Si es tu caso, esa es precisamente la lección: las estadísticas
informan al optimizador, no lo obligan a cambiar de plan, y ANALYZE no es
una operación que "siempre acelera la consulta" sino una que "siempre
mejora la información disponible", que son cosas distintas.
Pequeños ficheros y compactación
Muchas escrituras pequeñas aumentan el coste de listar, planificar y abrir
ficheros; en Iceberg también aumentan el número de manifests y el volumen de
metadatos que hay que leer para planificar una consulta. Para hacer visible
el problema sin arriesgar ninguna de las dos tablas de referencia, creamos
una tabla de laboratorio y la llenamos con varias tandas deliberadamente
pequeñas: iceberg.tcdm.web_sales_lab_smallfiles.
run_trino("DROP TABLE IF EXISTS iceberg.tcdm.web_sales_lab_smallfiles")
run_trino('''
    CREATE TABLE iceberg.tcdm.web_sales_lab_smallfiles (
        ws_order_number BIGINT,
        ws_item_sk BIGINT,
        ws_net_paid DECIMAL(7, 2)
    )
''')

for _tanda in range(8):
    run_trino('''
        INSERT INTO iceberg.tcdm.web_sales_lab_smallfiles
        SELECT ws_order_number, ws_item_sk, ws_net_paid
        FROM iceberg.tcdm.web_sales LIMIT 3
    ''')
print("8 tandas de 3 filas insertadas por separado en iceberg.tcdm.web_sales_lab_smallfiles.")
print("Cada INSERT independiente produce su propio fichero de datos y su propio snapshot,")
print("que es exactamente lo que queremos observar aquí: no importa que las filas se repitan,")
print("esto es una tabla de laboratorio pensada sólo para medir ficheros y manifests.")
Cada INSERT produce su propio fichero de datos y su propio
snapshot. Medimos antes de compactar: número de ficheros de datos, número de
manifests y número de snapshots.
def inventario_tabla_iceberg(esquema: str, tabla: str) -> dict[str, int]:
    '''Recoge un pequeño inventario de una tabla Iceberg vía las tablas de metadatos de Trino.'''
    n_ficheros = run_trino(f'SELECT count(*) AS n FROM iceberg.{esquema}."{tabla}$files"').loc[
        0, "n"
    ]
    n_manifests = run_trino(f'SELECT count(*) AS n FROM iceberg.{esquema}."{tabla}$manifests"').loc[
        0, "n"
    ]
    n_snapshots = run_trino(f'SELECT count(*) AS n FROM iceberg.{esquema}."{tabla}$snapshots"').loc[
        0, "n"
    ]
    return {
        "ficheros": int(n_ficheros),
        "manifests": int(n_manifests),
        "snapshots": int(n_snapshots),
    }


inventario_antes_compactar: dict[str, int] = inventario_tabla_iceberg(
    "tcdm", "web_sales_lab_smallfiles"
)
print("Antes de compactar:", inventario_antes_compactar)
Trino ofrece ALTER TABLE ... EXECUTE optimize para reescribir ficheros
pequeños en tablas Iceberg. El conector Iceberg de
Trino documenta este
procedimiento; Spark ofrece la acción equivalente a través del procedimiento
rewrite_data_files de su catálogo Iceberg —se cita más abajo, en la
sección de Z-order, porque es la única de las dos vías que admite esa
estrategia—. Aquí seguimos con Trino porque es el motor que ya ha creado y
sincronizado esta tabla de laboratorio, y la compactación por tamaño
(strategy => 'binpack', la que activa EXECUTE optimize sin más
parámetros) se comporta igual desde cualquiera de los dos catálogos.
resultado_optimize: pd.DataFrame = run_trino(
    "ALTER TABLE iceberg.tcdm.web_sales_lab_smallfiles EXECUTE optimize"
)
resultado_optimize
inventario_despues_compactar: dict[str, int] = inventario_tabla_iceberg(
    "tcdm", "web_sales_lab_smallfiles"
)
print("Antes de compactar:  ", inventario_antes_compactar)
print("Después de compactar:", inventario_despues_compactar)

assert inventario_despues_compactar["ficheros"] < inventario_antes_compactar["ficheros"]
print(
    f"De {inventario_antes_compactar['ficheros']} ficheros de datos a {inventario_despues_compactar['ficheros']}."
)
EXECUTE optimize no borra las versiones antiguas: reescribe los
datos en ficheros más grandes y añade un snapshot nuevo con
operation = 'replace', pero los ficheros pequeños originales —y los
snapshots que los referenciaban— siguen existiendo hasta que se expiran
explícitamente. Lo comprobamos en la propia tabla de snapshots.
snapshots_lab_smallfiles: pd.DataFrame = run_trino('''
    SELECT snapshot_id, operation FROM iceberg.tcdm."web_sales_lab_smallfiles$snapshots"
    ORDER BY committed_at
''')
snapshots_lab_smallfiles
Manifests y snapshots
Los manifests y los snapshots no son ficheros temporales que se puedan
ignorar: forman parte del modelo de datos de Iceberg y de la trazabilidad de
la tabla. La operación de mantenimiento que sí elimina versiones antiguas es
expire_snapshots, y la aplicamos únicamente sobre la tabla de
laboratorio que acabamos de compactar, nunca sobre iceberg.tcdm.web_sales
ni sobre iceberg.tcdm.web_sales_by_year.
Al intentar expirar snapshots con una retención de cero días, Trino rechaza la operación:
Retention specified (0.00d) is shorter than the minimum retention
configured in the system (7.00d). Minimum retention can be changed with
iceberg.expire-snapshots.min-retention configuration property or
iceberg.expire_snapshots_min_retention session property
Ese límite de 7 días no es un capricho: existe para que un mantenimiento
lanzado sin pensar no borre por accidente una versión que otro proceso
—posiblemente uno de larga duración, como un INSERT OVERWRITE distribuido
o un lector con una consulta abierta desde hace horas— todavía necesita
leer. En un entorno docente, donde queremos ver el efecto en la misma
sesión, hace falta bajar deliberadamente ese mínimo con una propiedad de
sesión, sabiendo que en una tabla real de producción este mismo gesto
debería ir acompañado de una política de retención explícita y de la
certeza de que ningún lector depende ya de las versiones que se van a
borrar.
run_trino("SET SESSION iceberg.expire_snapshots_min_retention = '0s'")
resultado_expire: pd.DataFrame = run_trino('''
    ALTER TABLE iceberg.tcdm.web_sales_lab_smallfiles
    EXECUTE expire_snapshots(retention_threshold => '0d')
''')
resultado_expire
snapshots_tras_expirar: pd.DataFrame = run_trino('''
    SELECT snapshot_id, operation FROM iceberg.tcdm."web_sales_lab_smallfiles$snapshots"
''')
print(f"Snapshots antes de expirar: {len(snapshots_lab_smallfiles)}")
print(f"Snapshots después de expirar: {len(snapshots_tras_expirar)}")
assert len(snapshots_tras_expirar) < len(snapshots_lab_smallfiles)
snapshots_tras_expirar
Tras expire_snapshots, sólo queda el snapshot vigente: los que
apuntaban a los ocho ficheros pequeños ya no son alcanzables desde el
historial de la tabla. remove_orphan_files es el procedimiento
complementario para el caso menos habitual de ficheros huérfanos —escritos
por una operación interrumpida a medio camino— que ningún snapshot llegó a
referenciar nunca; comparte la misma protección de retención mínima que
expire_snapshots por el mismo motivo.
Ordenación física
Conviene distinguir con cuidado tres cosas que suenan parecidas:
ORDER BYen una consulta ordena únicamente el resultado que se entrega al cliente; no cambia en nada cómo están organizados los ficheros en disco.- Un sort order de tabla en Iceberg describe cómo se espera que se organicen los datos dentro de cada fichero cuando se escriben, ayudando a lecturas selectivas por esa columna gracias a las estadísticas de mínimo/máximo por fichero.
- Ordenación local frente a global: ordenar dentro de cada tarea (local) es mucho más barato que garantizar un orden global entre todos los ficheros de la tabla, y normalmente basta con la primera para el beneficio que buscamos.
La documentación de DDL de Iceberg en Spark es explícita en que el orden de escritura no garantiza el orden de las filas que devuelve una consulta posterior: un sort order es una pista para el escritor y para el planificador, no un contrato sobre el resultado.
Creamos una tercera tabla de laboratorio con un sort order declarado sobre
ws_item_sk, usando la propiedad sorted_by que expone el conector
Iceberg de Trino.
run_trino("DROP TABLE IF EXISTS iceberg.tcdm.web_sales_lab_sorted")
run_trino('''
    CREATE TABLE iceberg.tcdm.web_sales_lab_sorted
    WITH (sorted_by = ARRAY['ws_item_sk']) AS
    SELECT ws_order_number, ws_item_sk, ws_sold_date, ws_net_paid
    FROM iceberg.tcdm.web_sales
''')

ddl_lab_sorted: str = run_trino("SHOW CREATE TABLE iceberg.tcdm.web_sales_lab_sorted").iloc[0, 0]
print(ddl_lab_sorted)
assert "sorted_by" in ddl_lab_sorted
SHOW CREATE TABLE confirma la propiedad sorted_by. Para contrastar
con el otro extremo del espectro —ordenar sólo el resultado, sin tocar nada
físico— ejecutamos un ORDER BY normal sobre la tabla de referencia: es
exactamente el mismo tipo de operación que ya usábamos en S2 para presentar
resultados, y no persiste ningún cambio en la tabla.
run_trino('''
    SELECT ws_order_number, ws_net_paid FROM iceberg.tcdm.web_sales
    ORDER BY ws_net_paid DESC LIMIT 5
''')
Z-order
Z-order es una técnica que combina varias columnas de filtrado en un único criterio de organización física, útil cuando las consultas filtran a veces por una columna y a veces por otra, no siempre por la misma.
Esta sesión lo presenta sin ejecutarlo, porque con las versiones del laboratorio no hay una demostración reproducible:
- el conector Iceberg de Trino no ofrece ninguna estrategia de Z-order:
ALTER TABLE ... EXECUTE optimizesólo compacta por tamaño de fichero; - Iceberg sí lo define para Spark, en el procedimiento
rewrite_data_filesconstrategy => 'sort'y unsort_orderde tipozorder(columna1, columna2, ...), pero con dos restricciones: no admite columnasDECIMAL—las monetarias deweb_saleslo son— y en este entorno falla sobre una tabla cuyo sort order ya declaró Trino, comoweb_sales_lab_sorted.
La llamada tendría esta forma:
CALL iceberg.system.rewrite_data_files(
    table => 'tcdm.<tabla>',
    strategy => 'sort',
    sort_order => 'zorder(<columna1>, <columna2>)'
)
Como cualquier otra optimización de esta sesión, Z-order sólo merece la pena cuando hay un problema medido que resolver: filtros frecuentes por varias columnas sobre una tabla lo bastante grande como para que descartar ficheros por sus mínimos y máximos se note.
Experimentos con una misma tabla
Reunimos en una sola tabla lo que hemos ido observando en las celdas anteriores. No inventamos aquí ningún número nuevo: cada fila hace referencia a una variable de Python o a un resultado ya calculado más arriba, siguiendo la misma idea que ya usó S5 en su propia tabla comparativa: mejor señalar exactamente de dónde sale cada dato que fabricar una cifra de tiempo de pared poco fiable en este entorno.
| Variante | Qué observamos | Evidencia en este notebook |
|---|---|---|
Parquet no particionado (raw) |
Sin poda posible; hay que recorrer todo web_sales |
explain_raw, sección "Particiones de datos" |
Hive particionada por año/mes (web_sales_silver, S6) |
Directorios visibles, poda por columnas de partición declaradas | explain_hive_2000 |
Iceberg con transformación temporal (web_sales) |
Particionado gestionado y oculto, poda sobre la columna de negocio | explain_iceberg_2000 |
Iceberg con ficheros pequeños (web_sales_lab_smallfiles) |
Más ficheros y manifests con el mismo volumen de datos | inventario_antes_compactar |
| Iceberg compactada | Menos ficheros, mismo resultado de negocio | inventario_despues_compactar |
Iceberg con sort order (web_sales_lab_sorted) |
Propiedad sorted_by declarada, sin garantía de orden en lectura |
ddl_lab_sorted |
| Iceberg y Z-order | No se ejecuta: Trino no lo ofrece y rewrite_data_files de Spark no admite columnas DECIMAL ni la tabla con sort order declarado por Trino |
sección "Z-order" más arriba |
Y la comprobación de negocio que atraviesa toda la sesión: el número de líneas de venta no es lo mismo que el número de pedidos distintos.
print("Líneas de venta vs pedidos distintos, iceberg.tcdm.web_sales:")
print(resultado_trino.to_dict("records")[0])
print()
print("Inventario de la tabla de laboratorio de ficheros pequeños:")
print("  antes de compactar:  ", inventario_antes_compactar)
print("  después de compactar:", inventario_despues_compactar)
print("  snapshots antes de expirar:  ", len(snapshots_lab_smallfiles))
print("  snapshots después de expirar:", len(snapshots_tras_expirar))
Ampliación opcional: leer una tabla Iceberg sin catálogo
Todo este notebook lee las tablas Iceberg por su nombre de catálogo
(iceberg.tcdm.<tabla>), tal como haría cualquier despliegue normal de
Spark con un Hive Metastore compatible. Existe, sin embargo, una vía
alternativa de lectura que no depende en ningún momento del catálogo:
resolver directamente el fichero metadata.json vigente de la tabla y
cargarlo por su ruta física en HDFS. Es una vía útil en cualquier entorno donde
Spark no tenga configurado un catálogo Iceberg —por ejemplo, un despliegue
sólo con Trino, o una herramienta de inspección que no quiere depender de
ningún catálogo—.
def ruta_metadata_json_vigente(catalogo: str, esquema: str, tabla: str) -> str:
    '''Devuelve la ruta HDFS del metadata.json vigente de una tabla Iceberg.

    No depende del Hive Metastore para nada salvo para preguntarle a Trino
    (que sí puede leer la tabla) cuál es su ubicación en HDFS.
    '''
    ddl_texto: str = run_trino(f"SHOW CREATE TABLE {catalogo}.{esquema}.{tabla}").iloc[0, 0]
    ubicacion: str = ubicacion_de_tabla_iceberg(ddl_texto)

    listado: str = subprocess.run(
        ["hdfs", "dfs", "-ls", f"{ubicacion}/metadata"],
        capture_output=True,
        text=True,
        check=True,
    ).stdout

    ficheros_metadata: list[str] = sorted(
        linea.split()[-1]
        for linea in listado.splitlines()
        if linea.strip().endswith(".metadata.json")
    )
    assert ficheros_metadata, f"no se ha encontrado ningún metadata.json bajo {ubicacion}/metadata"
    return ficheros_metadata[-1]


def leer_tabla_iceberg_por_ruta(catalogo: str, esquema: str, tabla: str) -> DataFrame:
    '''Carga con Spark una tabla Iceberg por su metadata.json vigente, sin pasar por el catálogo.'''
    ruta_metadata: str = ruta_metadata_json_vigente(catalogo, esquema, tabla)
    return spark.read.format("iceberg").load(ruta_metadata)


web_sales_by_year_por_ruta: DataFrame = leer_tabla_iceberg_por_ruta(
    "iceberg", "tcdm", "web_sales_by_year"
)
web_sales_by_year_por_ruta.printSchema()
filas_por_ruta: int = web_sales_by_year_por_ruta.count()
filas_por_catalogo: int = spark.table("iceberg.tcdm.web_sales_by_year").count()
print("Filas leyendo por ruta física:", filas_por_ruta)
print("Filas leyendo por catálogo:  ", filas_por_catalogo)
assert filas_por_ruta == filas_por_catalogo
print("Las dos vías de lectura devuelven el mismo resultado sobre iceberg.tcdm.web_sales_by_year.")
Buenas prácticas del lakehouse
Las reglas que ya aprendiste en S5 sobre organizar un data lake siguen siendo válidas; Iceberg añade algunas propias de su mantenimiento como formato de tabla:
- mantener los datos de origen separados de las tablas derivadas: aquí,
hive.tcdm.web_sales_silverno se ha tocado en ningún momento; - documentar el propietario, el esquema y la ubicación de cada tabla Iceberg, igual que ya hacíamos con las tablas Hive de S6;
- no sobrescribir la fuente para "convertirla" a Iceberg sin una estrategia
explícita de copia o migración: por eso hemos creado
iceberg.tcdm.web_salescon un CTAS, no reescribiendoweb_sales_silver; - elegir las transformaciones de partición según las consultas reales, no
"por si acaso":
month(ws_sold_date)responde a cómo se filtran de hecho las ventas por periodo; - controlar el número y el tamaño de los ficheros de datos, y compactar cuando el inventario lo justifique, no de forma automática;
- mantener una política explícita de snapshots y de retención antes de expirar nada, y aplicarla primero sobre tablas de laboratorio;
- validar el resultado de negocio antes y después de cualquier cambio, como hemos hecho en cada sección de este notebook;
- comprobar que todos los motores que van a usar la tabla comparten realmente el mismo catálogo, y no dar por hecho que "compatible" significa "sin incompatibilidades conocidas entre versiones concretas";
- separar las operaciones reversibles (compactar, reescribir manifests) de las que borran metadatos o datos (expirar snapshots, eliminar ficheros huérfanos);
- no compactar ni reordenar sin conocer primero el problema concreto que se quiere resolver;
- no crear particiones de alta cardinalidad sólo para "tener partición";
- no borrar snapshots sin una política de retención explícita, y nunca sobre las tablas que otras sesiones o procesos todavía necesitan;
- no dar por validada una mejora a partir de una única ejecución en un entorno tan variable como este;
- aislar con nombres claros las tablas de laboratorio de las tablas
oficiales del curso, como hemos hecho con el prefijo
web_sales_lab_.
Preguntas para interpretar la experiencia
- ¿Qué diferencia observable hay entre el
CREATE TABLEde una tabla Hive externa (S6) y el CTAS que ha creadoiceberg.tcdm.web_salesen cuanto a qué ocurre en HDFS y qué metadatos se generan? - ¿Por qué la ubicación real de
iceberg.tcdm.web_salesno coincide exactamente con/warehouse/tcdm.db/web_sales, y qué papel juega ese sufijo añadido? - ¿Qué diferencia hay entre cómo Hive y cómo Iceberg deciden qué directorio corresponde a cada valor de partición? ¿Quién tiene que declarar y sincronizar esa relación en cada caso?
- ¿Qué demuestra que
iceberg.tcdm.web_sales_lab_evolutionconserva su snapshot inicial intacto después delINSERTy delALTER TABLE ADD COLUMN? ¿Qué tendrías que hacer para perder esa capacidad de volver atrás? - ¿Por qué se ha decidido no experimentar con inserciones repetidas ni
evolución de esquema directamente sobre
iceberg.tcdm.web_sales, y crear en su lugar una copia de laboratorio? - ¿Qué diferencia hay entre
ORDER BYen una consulta y elsorted_byque declaramos al creariceberg.tcdm.web_sales_lab_sorted? ¿Qué garantiza cada uno y qué no garantiza ninguno de los dos? - ¿Por qué Trino impide expirar snapshots con una retención de cero días por defecto? ¿Qué riesgo concreto evita ese límite de 7 días?
- Z-order sólo puede pedirse desde Spark con
CALL iceberg.system.rewrite_data_files(...), nunca desde Trino. ¿Por qué? ¿Qué dos restricciones impiden demostrarlo en esta sesión, y qué tipo de consultas justificarían aplicarlo? - Antes de compactar
iceberg.tcdm.web_sales_lab_smallfiles, ¿qué problema concreto estabas resolviendo? ¿Cómo lo mediste, y cómo comprobaste que seguía existiendo el mismo resultado de negocio después de compactar?
Evidencias para la siguiente sesión
Antes de la siguiente sesión tendrás una reunión individual breve con el profesor para revisar el trabajo de esta sesión. Esa reunión combina una demostración en vivo sobre tu propio ordenador y una memoria escrita breve.
Qué mostrar en el ordenador durante la reunión
Ten preparadas estas evidencias:
- El
SHOW CREATE TABLEdeiceberg.tcdm.web_salesy deiceberg.tcdm.web_sales_by_year, con su ubicación efectiva bajo/warehouse. - El listado de HDFS de esa ubicación, distinguiendo los directorios
data(con las particiones ocultasws_sold_date_month=...) demetadata(los ficheros.metadata.jsony los manifests.avro). - Al menos dos snapshots de
iceberg.tcdm.web_sales_lab_evolution, correspondientes a operaciones distintas (la creación y elINSERTposterior), y la confirmación de que el snapshot inicial sigue siendo consultable conFOR VERSION AS OF. - La comprobación de que Trino y Spark devuelven el mismo resultado de
negocio sobre
iceberg.tcdm.web_sales(líneas de venta y pedidos distintos), leído por Spark directamente por su nombre de catálogo (iceberg.tcdm.web_sales), igual que las tablas Hive de S6. - Los planes de
EXPLAIN(Trino) y.explain("formatted")(Spark) antes y después de aplicar un filtro por partición, y la comparación de las tres variantes de particionado. - La tabla de
SHOW STATS FOR iceberg.tcdm.web_salesantes y después deANALYZE, con tu propia valoración de si cambió o no el plan delJOINcondate_dim. - El inventario de ficheros, manifests y snapshots de
iceberg.tcdm.web_sales_lab_smallfilesantes y después deEXECUTE optimize, y antes y después deexpire_snapshots. - Que sabes explicar, con tus propias palabras, la diferencia entre
ORDER BY, un sort order de tabla y la ordenación local frente a global. - Que sabes explicar qué es Z-order, desde qué motor se puede pedir y por
qué esta sesión no lo ejecuta (columnas
DECIMALno admitidas; tabla con un sort order ya declarado). - Una conclusión propia, de una o dos frases, sobre cuándo una optimización de las vistas en esta sesión ayuda de verdad y cuándo no merece la pena aplicarla en TPC-DS SF1.
- Que sabes qué tablas de laboratorio se borran después de la reunión y cuáles deben conservarse para S8, tal como se describe a continuación.
Memoria escrita (una o dos páginas)
Trae también un documento breve —una o dos páginas, no hace falta más— que
no se limite a pegar capturas de las salidas anteriores: debe explicar con
tus propias palabras la diferencia entre un fichero Parquet, una tabla Hive
externa y una tabla Iceberg; qué aporta el catálogo y qué aporta el formato
de tabla; qué es un snapshot y qué ocurre con los anteriores tras un
INSERT o un ALTER TABLE; en qué se diferencia una partición oculta de
Iceberg de una partición visible de Hive; y tu conclusión razonada sobre qué
optimización de las vistas ayuda de verdad en SF1 y cuál no.
Qué es importante de cara al examen final
El examen no pide recordar la sintaxis exacta de una sentencia. Debes poder explicar:
- qué distingue un data lake de ficheros, un data lake catalogado y un lakehouse;
- qué metadatos mantiene Iceberg (
metadata.json, manifests y snapshots) y qué permite cada uno; - cómo funcionan la evolución de esquema y el viaje en el tiempo, y por qué no exigen reescribir los datos;
- qué es una transformación de partición oculta y qué cambia respecto a las columnas de partición de Hive;
- por qué la selección de columnas y los filtros se comprueban antes que cualquier otra optimización;
- el problema de los ficheros pequeños, la compactación y la expiración de snapshots con una política de retención;
- para qué sirven las estadísticas y por qué
ANALYZEinforma al planificador sin obligarlo a cambiar de plan; - la diferencia entre
ORDER BY, un sort order de tabla y Z-order.
Detener y limpiar
Estas operaciones se muestran como texto, no como celdas de código, para
que un «ejecutar todo» de este notebook no las dispare por accidente. Las
tablas de laboratorio de esta sesión —web_sales_lab_evolution,
web_sales_lab_smallfiles y web_sales_lab_sorted— son recursos
desechables: consérvalas hasta la reunión de evidencias, que las necesita,
y bórralas después. Nunca apliques el mismo
razonamiento a iceberg.tcdm.web_sales ni a
iceberg.tcdm.web_sales_by_year: son las dos tablas que reutilizará S8, y
borrarlas o expirar sus snapshots obligaría a repetir esta sesión entera.
| Situación | Orden | Consecuencia |
|---|---|---|
| Eliminar las tablas de laboratorio | DROP TABLE iceberg.tcdm.web_sales_lab_evolution, DROP TABLE iceberg.tcdm.web_sales_lab_smallfiles, DROP TABLE iceberg.tcdm.web_sales_lab_sorted (desde el cliente Trino de este notebook, o docker exec trino-hdfs trino --user luser --execute "..." desde una terminal) |
Borra tanto la entrada del metastore como los ficheros Parquet y los metadatos Iceberg de cada tabla: son tablas administradas, su ciclo de vida de datos depende del catálogo. |
Conservar iceberg.tcdm.web_sales e iceberg.tcdm.web_sales_by_year |
No ejecutar ningún DROP TABLE ni expire_snapshots sobre ellas |
S8 las necesita con exactamente el esquema y la clave compuesta que tienen ahora. |
| Parar temporalmente el warehouse | docker compose -f entorno/compose-warehouse-hdfs.yml stop |
Conserva PostgreSQL, Hive Metastore y Trino (y su contenido, incluidas las tablas Iceberg); se reanuda con start. No afecta al clúster Hadoop. |
| Eliminar el warehouse por completo (destructivo) | docker compose -f entorno/compose-warehouse-hdfs.yml down -v --remove-orphans |
Borra el volumen de PostgreSQL: se pierde todo el contenido del Hive Metastore, incluidas las definiciones de iceberg.tcdm.web_sales y iceberg.tcdm.web_sales_by_year. No borra /datalake ni /warehouse en HDFS: los ficheros Parquet y de metadatos seguirían ahí, ahora sin ninguna definición de catálogo que los describa. Tras volver a levantar el warehouse haría falta repetir los CREATE TABLE/CTAS de esta sesión antes de continuar con S8. |
No confundas ese down -v del warehouse con el down/volume rm de S1
(clúster Hadoop) o con el down -v de la sesión 3 (RustFS): cada Compose
tiene su propio
volumen y afecta sólo a sus propios servicios.
Siguiente paso
S7 establece el modelo de lakehouse sobre la misma tabla que lo hace evolucionar y mide qué decisiones de particionado, tamaño de ficheros, estadísticas, ordenación y mantenimiento mejoran realmente las consultas —y cuáles no—. También ha dejado constancia de que "lakehouse" no es una propiedad binaria de un formato de tabla: las versiones de motor, cliente y catálogo se comprueban contra el clúster real, no se suponen compatibles porque «deberían» serlo.
S8 cierra el recorrido incorporando ingesta continua: un proceso simulado
generará nuevos pedidos que un trabajo de Spark Structured Streaming irá
fusionando desde raw hacia silver y gold sobre esta misma tabla
iceberg.tcdm.web_sales, usando sus mecanismos de merge (copy-on-write y
merge-on-read) en lugar de una recarga completa, y apoyándose exactamente en
la clave compuesta (ws_order_number, ws_item_sk) que hemos mantenido
intacta durante toda esta sesión.