Sesión 6 — Hive Metastore, tablas Hive y Trino
Esta sesión viene después de S5. El alumnado ya ha visto que una colección de Parquet puede organizarse en directorios particionados y que Spark puede leerlos directamente. Ahora se introduce la capa que proporciona nombres y metadatos compartidos a los motores.
La pregunta central es:
¿Cómo pasamos de conocer una ruta física a disponer de una tabla lógica que puedan consultar Spark y Trino?
El Hive Metastore no es un motor de procesamiento y Trino no es el catálogo. El metastore conserva metadatos; Trino consulta y procesa; Spark puede utilizar la misma definición si se configura como cliente del catálogo.
S2: Parquet sin tabla permanente
  → S3: Parquet en HDFS y S3-compatible
  → S4: Spark como motor
  → S5: organización refinada y particionada
  → S6: Hive Metastore y Trino comparten la tabla
  → S7: Iceberg añade gestión de tablas y snapshots
La infraestructura definida en entorno/compose-warehouse-hdfs.yml separa
PostgreSQL, Hive Metastore, Trino y el clúster Hadoop. PostgreSQL almacena el
repositorio del metastore; Hive Metastore expone la información por Thrift;
Trino utiliza esa información para planificar consultas. Ninguno de esos
servicios se convierte por ello en DataNode o NodeManager.
Paquetes de Python de esta sesión. Esta sesión necesita
pyspark,trino,pandas. Respecto a S5 añadetrino,pandas. Se instalan en el kernel denamenodeen la sección «Instalar las dependencias de este notebook»: una celda%%writefile requirements.txtcrea el fichero dentro del contenedor —elrequirements.txtde tu copia des6/está en tu equipo ynamenodeno lo ve— y otra ejecuta%pip install -r requirements.txt. La imagen denamenodeya trae estos paquetes en su entorno Python del curso,/opt/tcdm/venv, que es el intérprete del kernel y donde instala%pip; lo normal es que%pipsólo confirme que están; ejecuta esas celdas de todos modos: dejan explícito qué necesita la sesión y reparan el entorno si falta algo.
Diapositivas de la sesión
Las diapositivas se generan con el paquete jupyter-notebook-slide.
El alias %%diapositiva permite mantener en español los tipos usados en la sesión y produce la misma salida HTML en Jupyter, Colab y la referencia HTML publicada.
En cada sesión encontrarás varios tipos de diapositivas que te ayudarán a seguir el hilo:
- Sección (
titulo): abre la sesión y resume qué vamos a ver y qué haremos. - A continuación (
avance): anuncia el contenido de la parte siguiente, para saber en qué punto del programa estamos. - Recapitulación (
resumen): condensa la parte anterior en puntos clave para recordarlos y revisarlos después. - Pregunta guía (
pregunta): plantea cuestiones que orientan lo que viene a continuación; conviene intentar responderlas antes de seguir. - Evaluación de la sesión (
evaluacion): recuerda cómo se evalúa el trabajo de esta sesión.
%pip install -q "jupyter-notebook-slide @ git+https://github.com/dsevilla/jupyter-notebook-slide.git"
%load_ext notebook_slide

import notebook_slide as jnbs

# Colores de 26-27/teoria/tcdm.css, adaptados al tema de las sesiones.
jnbs.configure(
    background="#eaf2f8",
    foreground="#1f2933",
    border="#c9d6e1",
    heading="#0c304d",
    subheading="#0c304d",
    link="#174f7a",
    code_background="#eaf2f8",
    code_foreground="#0c304d",
    quote_background="#ffffff",
    font_family="Atkinson Hyperlegible, Inter, Aptos, Segoe UI, Helvetica, Arial, sans-serif",
    font_url="https://fonts.googleapis.com/css2?family=Atkinson+Hyperlegible:ital,wght@0,400;0,700;1,400;1,700&display=swap",
)
jnbs.register_slide_type("avance", "A continuación", "#174f7a")
jnbs.register_slide_type("resumen", "Recapitulación", "#a54467")
jnbs.register_slide_type("pregunta", "Pregunta guía", "#0c304d")
jnbs.register_slide_type("evaluacion", "Evaluación de la sesión", "#b3701a")
jnbs.register_slide_type(
    "titulo",
    "Sección",
    "#174f7a",
    layout="title",
    background="linear-gradient(135deg, #0c304d, #174f7a 62%, #a54467)",
    foreground="#ffffff",
    border="transparent",
    heading="#ffffff",
    subheading="#dceaf4",
)
jnbs.register_alias("diapositiva")
Capas que se deben distinguir
| Capa | Responsabilidad | Ejemplo del laboratorio |
|---|---|---|
| Almacenamiento | Conserva bytes y rutas | HDFS bajo /datalake o /warehouse |
| Formato | Describe cómo leer cada fichero | Parquet |
| Metastore | Guarda nombres, esquemas, ubicaciones y particiones | Hive Metastore + PostgreSQL |
| Motor SQL | Planifica y ejecuta consultas | Trino |
| Motor de transformación | Produce o consume DataFrames | Spark |
| Formato de tabla | Gestiona metadatos de tabla y cambios | Iceberg en S7 |
Una ruta Parquet puede existir sin metastore. Una entrada del metastore no contiene todos los bytes de la tabla. Una tabla Hive externa puede apuntar a datos existentes y no debe borrar esos datos automáticamente al eliminar sólo su definición. Esa distinción entre "borrar metadatos" y "borrar datos" es uno de los hilos conductores de esta sesión.
Objetivos de la sesión
Al terminar esta sesión deberías poder:
- explicar qué problema resuelve un catálogo frente a una ruta física;
- distinguir Hive Metastore, Trino, Spark y PostgreSQL en esta arquitectura;
- registrar Parquet ya existente como tabla externa, sin copiar ni transformar los datos;
- distinguir una tabla externa de una tabla administrada, y saber en qué ubicación física vive cada una;
- consultar la ubicación, el esquema y las propiedades de una tabla con
SHOW CREATE TABLEyDESCRIBE; - inspeccionar las particiones que conoce el metastore de una tabla Hive
particionada, y entender por qué hace falta un paso explícito de
descubrimiento tras el
CREATE TABLE; - ejecutar consultas equivalentes desde Trino y desde Spark contra la misma definición de tabla, sin tratarlos como catálogos distintos;
- observar selección de columnas, predicate pushdown y eliminación de particiones en el plan de consulta, no sólo en el tiempo de pared;
- calcular estadísticas con
ANALYZEy explicar para qué sirven; - documentar el ciclo de vida de una tabla y el riesgo de borrar datos gestionados por accidente;
- identificar las limitaciones del Hive Metastore que justifican introducir Iceberg en S7.
Antes de empezar
Dónde se ejecuta este notebook. Igual que en S2, S3, S4 y S5, Jupyter se ejecuta directamente dentro del contenedor
namenode, comoluser, con acceso de red directo a HDFS, YARN, Trino, PostgreSQL y el Hive Metastore: todos comparten la misma red Dockerhadoop-cluster. Las celdas ejecutables hablan directamente con esos servicios. Las órdenes que necesitan el Docker del host — arrancar o detener contenedores,make— se muestran como texto para ejecutarlas en una terminal de tu equipo, nunca como celdas de este notebook.
Esta sesión asume que:
- el clúster de S1 ya está en marcha;
- S2 generó los Parquet de TPC-DS SF1 en
/datalake/raw/tpcds; - S5 ya ejecutó su ETL y dejó
/datalake/silver/tpcds/web_sales(particionado porsold_yearysold_month) y/datalake/gold/tpcds/web_sales_by_yearescritos en HDFS.
Si el clúster de infraestructura (PostgreSQL, Hive Metastore y Trino) no está levantado todavía, desde una terminal de tu equipo situada en la raíz de la distribución de sesiones:
cd ~/tcdm-public
git pull
make -C entorno warehouse-up
warehouse-up depende de hadoop-up, así que también arranca el clúster
Hadoop si hiciera falta, y arranca además el servicio catalog-init, que
crea el esquema hive.tcdm la primera vez que se levanta el entorno.
Este notebook se ejecuta en el Jupyter de namenode, que no arranca solo.
Como en S2, arráncalo desde otra terminal de tu equipo y déjala abierta
mientras trabajes:
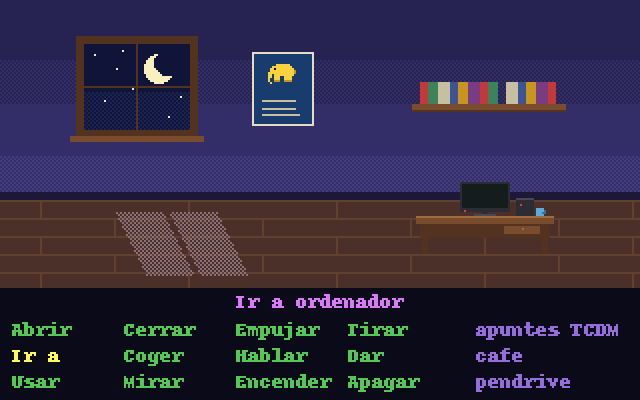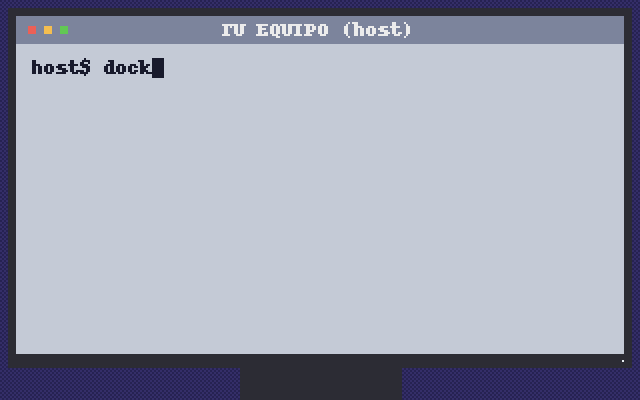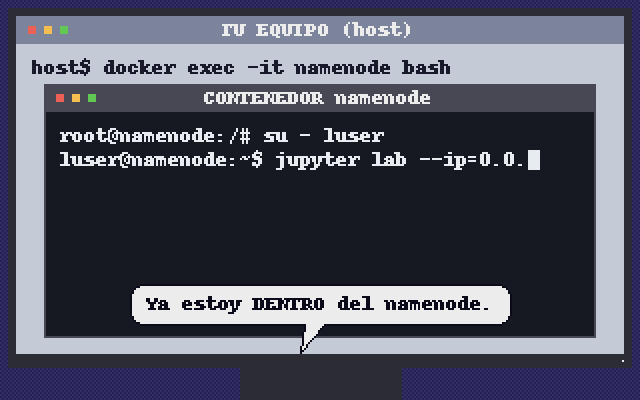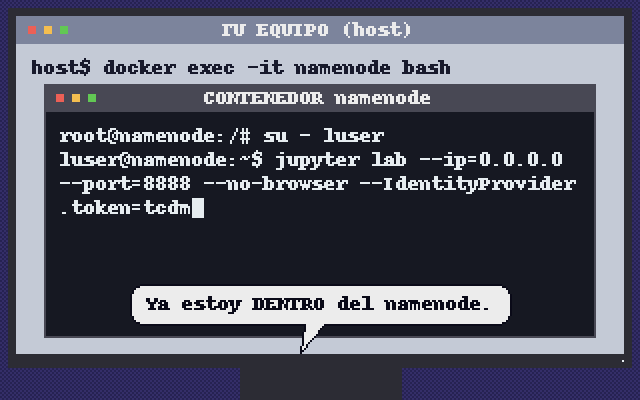
# en tu equipo: entra en namenode
docker exec -it namenode bash
# ya dentro de namenode, como luser: Jupyter con el token fijo «tcdm»
su - luser
jupyter lab --ip=0.0.0.0 --port=8888 --no-browser --IdentityProvider.token=tcdm
La primera orden es la única que se ejecuta en tu equipo; las otras dos, ya
dentro del contenedor, arrancan Jupyter con el Python del curso
(make -C entorno jupyter hace lo mismo en una sola orden). En Visual
Studio Code, conecta este notebook con Select Kernel → Select Another
Kernel → Existing Jupyter Server, usando la dirección
http://127.0.0.1:8888/lab?token=tcdm y eligiendo el kernel Python 3
(ipykernel). El token es siempre tcdm.
Si algo no funciona —el notebook no conecta, una celda !hdfs no
encuentra la orden, un servicio no responde—, consulta «Solución de
problemas» en entorno/README.md.
Esta sesión no regenera S5. Si /datalake/silver/tpcds/web_sales o
/datalake/gold/tpcds/web_sales_by_year no existen todavía, ejecuta antes el
notebook de S5.
!hdfs dfs -ls -d /datalake/raw/tpcds/date_dim \
    /datalake/silver/tpcds/web_sales \
    /datalake/gold/tpcds/web_sales_by_year \
    /warehouse
Si alguna de esas cuatro rutas no aparece, revisa S2 (para date_dim)
o S5 (para web_sales en silver y web_sales_by_year en gold) antes de
continuar. /warehouse ya existe desde que S1 preparó el NameNode: es la
zona reservada para las tablas administradas por Hive e Iceberg, y hasta
ahora ha estado vacía.
Instalar las dependencias de este notebook
Igual que en S4 y S5, el kernel de este notebook instala PySpark sobre sí
mismo. Añadimos además el paquete trino, el cliente DB-API 2.0 con el que
hablaremos con Trino: no hay binario trino en namenode ni acceso al
Docker del host, así que aquí no hay CLI de Trino: usamos el cliente
Python. La celda siguiente recrea requirements.txt con %%writefile para
que este notebook no dependa de ningún otro fichero de la distribución,
tanto si lo abres dentro de namenode como si usas «Existing Jupyter
Server» desde tu equipo.
%%writefile requirements.txt
# Dependencias del kernel interactivo de la sesión 6 (Spark local + cliente
# Trino). La serie de PySpark aceptada por el curso es >4,<4.2, igual que en
# S4 y S5.
pyspark>4,<4.2
# Cliente DB-API 2.0 de Trino: es como este notebook consulta Trino sin usar
# el binario `trino` ni `docker exec` (el kernel corre dentro de namenode, no
# tiene acceso al Docker del host). Se fija la serie mayor para que el tipado
# de columnas y la representación de valores no cambien entre ejecuciones.
trino>=0.330,<1
pandas
%pip install -q -r requirements.txt
import sys

import pandas
import pyspark
import trino

print(f"PySpark {pyspark.__version__} con Python {sys.version.split()[0]}.")
print(f"Cliente trino: {trino.__version__}")
print(f"Pandas: {pandas.__version__}")
Construir la SparkSession con soporte Hive
A diferencia de S4 —donde Spark leía Parquet directamente por ruta y no
necesitaba ningún catálogo—, aquí Spark debe hablar con el mismo Hive
Metastore que usa Trino. Eso exige dos configuraciones explícitas, además de
enableHiveSupport():
spark.hadoop.hive.metastore.uris: la URI Thrift del metastore,thrift://hive-metastore:9083. Es el mismo puerto que declara el healthcheck del serviciohive-metastoreenentorno/compose-warehouse-hdfs.yml.spark.sql.warehouse.dir: la ubicación por defecto de las tablas administradas,hdfs://namenode:9000/warehouse. Coincide conhive.metastore.warehouse.dir, que ese mismo entorno fija enentorno/hive-metastore/conf/hive-site.xmlparahive-metastore, para que Spark y Hive elijan la misma ruta si alguno crea una tabla administrada sin indicarLOCATION.
Spark habla con este metastore con su cliente por defecto porque la versión
fijada del curso es Hive Metastore 3.1.3; la justificación completa está en
entorno/README.md, sección "Versiones fijadas y compatibilidad".
Construimos una única SparkSession en modo local[2], la misma que
reutilizaremos en el resto del notebook — igual que en S4 y S5, no hay
necesidad de YARN para el volumen de datos de esta sesión.
from pyspark import SparkContext
from pyspark.sql import SparkSession

HIVE_METASTORE_URIS: str = "thrift://hive-metastore:9083"
WAREHOUSE_DIR: str = "hdfs://namenode:9000/warehouse"

spark: SparkSession = (
    SparkSession.builder.appName("TCDM_S6_Local")
    .master("local[2]")
    .config("spark.driver.memory", "1g")
    .config("spark.sql.shuffle.partitions", "8")
    .config("spark.hadoop.hive.metastore.uris", HIVE_METASTORE_URIS)
    .config("spark.sql.warehouse.dir", WAREHOUSE_DIR)
    .config("spark.sql.catalogImplementation", "hive")
    .enableHiveSupport()
    .getOrCreate()
)
sc: SparkContext = spark.sparkContext

print(f"Spark version: {spark.version} | Master: {sc.master}")
print(f"Metastore URIs: {HIVE_METASTORE_URIS}")
print(f"Warehouse dir: {WAREHOUSE_DIR}")
spark.sql.catalogImplementation=hive junto con enableHiveSupport()
son lo que hace que Spark deje de usar su catálogo en memoria (el que veías
en S4 al registrar vistas temporales con createOrReplaceTempView) y se
convierta en otro cliente del mismo Hive Metastore que usará Trino. Una
comprobación rápida: si no aparece tcdm entre las bases de datos, esta
SparkSession no está viendo el mismo metastore que Trino; si sólo
apareciera default (la base heredada de Hive, siempre presente),
estaríamos ante el catálogo en memoria de siempre, no ante el Hive
Metastore.
spark.sql("SHOW DATABASES").show()
Abrir la conexión con Trino
Usamos el paquete trino (PyPI) en lugar de la CLI: trino.dbapi.connect
habla el protocolo HTTP de Trino directamente contra el servicio
trino-hdfs de la red hadoop-cluster, en el puerto 8080 — el mismo
puerto que expone entorno/compose-warehouse-hdfs.yml, sólo que aquí no hace
falta el mapeo 127.0.0.1:8080:8080 porque el notebook ya vive dentro de esa
red. Definimos una pequeña función auxiliar que ejecuta SQL y devuelve un
DataFrame de pandas, para no repetir en cada celda la apertura de cursor y
la construcción de columnas.
import pandas as pd
from trino.dbapi import Connection, Cursor

trino_conn: Connection = trino.dbapi.connect(
    host="trino-hdfs",
    port=8080,
    user="luser",
    catalog="hive",
    schema="tcdm",
)


def run_trino(sql: str) -> pd.DataFrame:
    '''Ejecuta una sentencia en Trino y devuelve el resultado como DataFrame.'''
    cursor: Cursor = trino_conn.cursor()
    cursor.execute(sql)
    rows: list[tuple] = cursor.fetchall()
    columns: list[str] = [description[0] for description in cursor.description or []]
    return pd.DataFrame(rows, columns=columns)
run_trino("SELECT 1 AS ping")
La conexión responde. catalog="hive" y schema="tcdm" son los
valores por defecto de trino_conn: en el resto del notebook escribiremos
igualmente los nombres completos (hive.tcdm.<tabla>) en el SQL para que
cada sentencia se entienda sin depender del contexto por defecto de la
conexión.
Tabla externa frente a tabla administrada
Se van a usar dos modelos distintos a lo largo de la sesión.
Tabla externa sobre el data lake
Una tabla externa registra la ubicación de Parquet que ya existe en
/datalake. El catálogo añade nombre, esquema, formato y particiones, pero
la fuente de datos continúa siendo externa al ciclo de vida de la tabla: si
se elimina la definición de la tabla del metastore, los ficheros Parquet
siguen en HDFS exactamente igual que antes.
Este modelo es el adecuado para los datos fuente y refinados de S2 y S5:
/datalake/raw/tpcds/date_dim
    → tabla Hive externa: tcdm.date_dim

/datalake/silver/tpcds/web_sales
    → tabla Hive externa particionada: tcdm.web_sales_silver

/datalake/gold/tpcds/web_sales_by_year
    → tabla Hive externa orientada al consumo: tcdm.web_sales_by_year_gold
Eliminar la definición de una de estas tablas no debe interpretarse como permiso para borrar el data lake. Las operaciones destructivas sobre HDFS deben ser explícitas y documentarse aparte, como se hace al final de este notebook.
Tabla administrada en el warehouse
Una tabla administrada deja que el catálogo y el motor elijan y gestionen
una ubicación bajo /warehouse. Al crearla, Hive/Trino reservan un
directorio con el patrón /warehouse/<esquema>.db/<tabla> — de ahí el
/warehouse/tcdm.db/... que verás más abajo. Al eliminar una tabla administrada,
el motor sí borra también esos ficheros: el ciclo de vida de los datos queda
ligado al ciclo de vida de la tabla.
En el laboratorio se usará esta zona para una única tabla de trabajo
(tcdm.web_sales_by_year_managed_demo), creada sólo para comparar ambos
modelos; en S7 será también la zona de las tablas Iceberg.
Registrar los Parquet originales: tcdm.date_dim
Empezamos por la tabla más pequeña, date_dim, exactamente el mismo Parquet
que S2 y S4 ya leyeron directamente por ruta
(/datalake/raw/tpcds/date_dim, 73.049 filas).
hive.tcdm ya debería existir — lo crea catalog-init al levantar el
entorno—, pero repetir CREATE SCHEMA IF NOT EXISTS aquí es idempotente y
deja el paso explícito en el propio notebook.
run_trino("CREATE SCHEMA IF NOT EXISTS hive.tcdm")
run_trino("DROP TABLE IF EXISTS hive.tcdm.date_dim")

create_date_dim_sql: str = '''
CREATE TABLE hive.tcdm.date_dim (
    d_date_sk BIGINT,
    d_date_id CHAR(16),
    d_date DATE,
    d_month_seq INTEGER,
    d_week_seq INTEGER,
    d_quarter_seq INTEGER,
    d_year INTEGER,
    d_dow INTEGER,
    d_moy INTEGER,
    d_dom INTEGER,
    d_qoy INTEGER,
    d_fy_year INTEGER,
    d_fy_quarter_seq INTEGER,
    d_fy_week_seq INTEGER,
    d_day_name CHAR(9),
    d_quarter_name CHAR(6),
    d_holiday CHAR(1),
    d_weekend CHAR(1),
    d_following_holiday CHAR(1),
    d_first_dom INTEGER,
    d_last_dom INTEGER,
    d_same_day_ly INTEGER,
    d_same_day_lq INTEGER,
    d_current_day CHAR(1),
    d_current_week CHAR(1),
    d_current_month CHAR(1),
    d_current_quarter CHAR(1),
    d_current_year CHAR(1)
) WITH (
    format = 'PARQUET',
    external_location = 'hdfs://namenode:9000/datalake/raw/tpcds/date_dim'
)
'''
run_trino(create_date_dim_sql)
print("tcdm.date_dim creada.")
run_trino("SHOW CREATE TABLE hive.tcdm.date_dim")
run_trino("DESCRIBE hive.tcdm.date_dim")
date_dim_count: pd.DataFrame = run_trino("SELECT count(*) AS filas FROM hive.tcdm.date_dim")
print(date_dim_count)

assert int(date_dim_count.loc[0, "filas"]) == 73_049
Un metastore no sólo guarda esquema y ubicación: también puede guardar un
comentario de tabla. Lo añadimos con COMMENT ON TABLE y lo comprobamos en
el propio SHOW CREATE TABLE — es lo que hace ejecutable la buena práctica
de «cada tabla tiene un propietario y una descripción» que veremos al final
de la sesión.
run_trino('''
    COMMENT ON TABLE hive.tcdm.date_dim IS
    'Dimensión de fechas de TPC-DS SF1, registrada como tabla externa sobre /datalake/raw/tpcds/date_dim (ver S2).'
''')
run_trino("SHOW CREATE TABLE hive.tcdm.date_dim")
El CREATE TABLE no ha tardado más que declarar el esquema: no ha
leído ni copiado ningún byte de date_dim. SHOW CREATE TABLE confirma que
external_location apunta exactamente a la misma ruta HDFS que ya conocías
de S2 y S4, y el recuento de filas coincide con el que obtuvo Spark en S4
leyendo el Parquet directamente. Registrar una tabla no transforma ni
duplica los datos: sólo añade un nombre y un esquema por encima de lo que ya
existía.
Registrar la versión particionada: tcdm.web_sales_silver
Ahora registramos la salida particionada de S5:
/datalake/silver/tpcds/web_sales, organizada en directorios
sold_year=<año>/sold_month=<mes>/. Los tipos de las columnas de negocio
coinciden con el catálogo de columnas de web_sales que documentó S2, con
una excepción: ws_sold_date es un DATE derivado que S5 añadió a partir
de ws_sold_date_sk y date_dim, y no aparece en el catálogo original de
S2. Las dos últimas columnas, sold_year y sold_month, son las columnas de
partición que
introdujo S5 y no están dentro de los ficheros Parquet: Spark las quitó
de los datos al escribir con partitionBy y las dejó codificadas sólo en el
nombre de cada directorio. Por eso deben declararse en partitioned_by y,
en el listado de columnas de Trino, ir al final.
run_trino("DROP TABLE IF EXISTS hive.tcdm.web_sales_silver")

create_web_sales_silver_sql: str = '''
CREATE TABLE hive.tcdm.web_sales_silver (
    ws_order_number BIGINT,
    ws_item_sk BIGINT,
    ws_bill_customer_sk BIGINT,
    ws_bill_addr_sk BIGINT,
    ws_sold_date_sk BIGINT,
    ws_sold_date DATE,
    ws_quantity INTEGER,
    ws_list_price DECIMAL(7, 2),
    ws_ext_discount_amt DECIMAL(7, 2),
    ws_ext_sales_price DECIMAL(7, 2),
    ws_net_paid DECIMAL(7, 2),
    ws_net_profit DECIMAL(7, 2),
    sold_year INTEGER,
    sold_month INTEGER
) WITH (
    format = 'PARQUET',
    external_location = 'hdfs://namenode:9000/datalake/silver/tpcds/web_sales',
    partitioned_by = ARRAY['sold_year', 'sold_month']
)
'''
run_trino(create_web_sales_silver_sql)
print("tcdm.web_sales_silver creada.")
run_trino("SHOW CREATE TABLE hive.tcdm.web_sales_silver")
Por qué hace falta un paso de descubrimiento de particiones
Consultamos la tabla recién creada antes de hacer nada más:
before_repair: pd.DataFrame = run_trino("SELECT count(*) AS filas FROM hive.tcdm.web_sales_silver")
print(before_repair)
El resultado es 0 filas, aunque los ficheros Parquet de S5 llevan
ahí desde que terminó esa sesión. CREATE TABLE ... WITH (external_location = ..., partitioned_by = ...) declara el esquema y la convención de
particionado, pero no recorre HDFS para descubrir qué valores de
sold_year/sold_month existen realmente: el metastore todavía no conoce
ninguna partición.
Cómo se sincronizan las particiones desde Trino. El patrón clásico
de Hive es MSCK REPAIR TABLE, pero esa sentencia es HiveQL, no SQL de
Trino: el conector Hive de Trino
no la implementa. Lo que expone en su lugar es un procedimiento propio del
conector, system.sync_partition_metadata, dentro del esquema system de
cada catálogo Hive — aquí, hive.system.sync_partition_metadata. Por eso
usamos esa llamada, y no MSCK REPAIR TABLE, para pedirle a Trino que
sincronice el metastore con los directorios que encuentre bajo
external_location.
sync_partitions_sql: str = '''
CALL hive.system.sync_partition_metadata(
    schema_name => 'tcdm',
    table_name => 'web_sales_silver',
    mode => 'FULL')
'''
run_trino(sync_partitions_sql)
print("Particiones sincronizadas.")
after_repair: pd.DataFrame = run_trino("SELECT count(*) AS filas FROM hive.tcdm.web_sales_silver")
print(after_repair)

assert int(after_repair.loc[0, "filas"]) > 0
assert int(before_repair.loc[0, "filas"]) == 0
Ahora sí aparecen filas: el metastore ha añadido una entrada de
partición por cada directorio sold_year=.../sold_month=... que ha
encontrado bajo la ubicación externa. Una partición Hive es exactamente esa
combinación: una organización física de directorios más una fila de
metadatos en el metastore que la describe. Sin la segunda parte, la primera
es invisible para el motor SQL, aunque los bytes ya estén en HDFS.
Nota para cuando uses Spark más adelante. Spark, al ser también un cliente compatible con HiveQL, sí entiende
MSCK REPAIR TABLEde forma nativa (spark.sql("MSCK REPAIR TABLE tcdm.web_sales_silver")). No hace falta ejecutarlo aquí porque Trino ya sincronizó las particiones en el mismo metastore que Spark va a leer; si lo lanzaras ahora sería una operación redundante que no encontraría nada nuevo que añadir.
Inspeccionar las particiones con $partitions
Trino expone una tabla de metadatos especial, <tabla>$partitions, con una
fila por partición conocida y sus columnas de partición como columnas
normales.
partitions_df: pd.DataFrame = run_trino(
    'SELECT * FROM hive.tcdm."web_sales_silver$partitions" ORDER BY sold_year, sold_month'
)
print(f"Particiones registradas: {len(partitions_df)}")
partitions_df
Consulta sin filtro frente a consulta filtrada por partición
Comparamos el plan de una consulta que recorre toda la tabla con el de otra
que restringe sold_year y sold_month — las columnas de partición, no una
transformación sobre ellas. EXPLAIN muestra el plan sin ejecutar la
consulta; EXPLAIN ANALYZE la ejecuta de verdad y añade estadísticas reales
de filas y bytes leídos por cada operador.
explain_unfiltered: pd.DataFrame = run_trino(
    "EXPLAIN SELECT count(*) FROM hive.tcdm.web_sales_silver"
)
print("\n".join(explain_unfiltered.iloc[:, 0].tolist()))
explain_filtered: pd.DataFrame = run_trino(
    '''EXPLAIN SELECT count(*) FROM hive.tcdm.web_sales_silver
    WHERE sold_year = 2000 AND sold_month = 1'''
)
print("\n".join(explain_filtered.iloc[:, 0].tolist()))
Busca en el segundo plan una restricción sobre sold_year/sold_month
en el propio TableScan (una condición de partición, no un Filter
posterior a la lectura): esa es la señal de que Trino ha descartado el resto
de directorios de partición antes de abrir ningún fichero, en lugar de leer
todo y filtrar después. EXPLAIN ANALYZE deja ver además cuántas filas y
bytes se leyeron realmente en cada caso.
explain_analyze_filtered: pd.DataFrame = run_trino(
    '''EXPLAIN ANALYZE SELECT count(*) FROM hive.tcdm.web_sales_silver
    WHERE sold_year = 2000 AND sold_month = 1'''
)
print("\n".join(explain_analyze_filtered.iloc[:, 0].tolist()))
Igual que en S4 con predicate/projection pushdown en Spark, la
mejora de una consulta filtrada por partición no se debe dar por hecha sólo
por el tiempo de pared: hay que comprobarla en el plan y en las métricas de
filas y bytes leídos que ofrece EXPLAIN ANALYZE.
Registrar la tabla gold: tcdm.web_sales_by_year_gold
Por último registramos el agregado de negocio que produjo S5:
/datalake/gold/tpcds/web_sales_by_year, sin particiones — es una tabla
pequeña, un año por fila, pensada para consumirse entera. Sus columnas son
d_year, pedidos (pedidos distintos), lineas_de_venta (líneas de venta,
count(*)) y beneficio_neto. Declaramos beneficio_neto como
DECIMAL(17, 2), coherente con el resto de columnas monetarias de esta
sesión (DECIMAL(7, 2) en web_sales_silver): un SUM de una columna
decimal(7,2) en Spark amplía la precisión, pero mantiene el tipo decimal en
lugar de convertirlo a coma flotante — importante para un agregado de dinero.
Si el Parquet físico que escribió S5 usara DOUBLE en su lugar, se notaría
al consultar la tabla, no al declararla: el SELECT de más abajo fallaría o
devolvería NULL en esa columna, y bastaría con ajustar este único tipo.
run_trino("DROP TABLE IF EXISTS hive.tcdm.web_sales_by_year_gold")

create_gold_sql: str = '''
CREATE TABLE hive.tcdm.web_sales_by_year_gold (
    d_year INTEGER,
    pedidos BIGINT,
    lineas_de_venta BIGINT,
    beneficio_neto DECIMAL(17, 2)
) WITH (
    format = 'PARQUET',
    external_location = 'hdfs://namenode:9000/datalake/gold/tpcds/web_sales_by_year'
)
'''
run_trino(create_gold_sql)
print("tcdm.web_sales_by_year_gold creada.")
run_trino("DESCRIBE hive.tcdm.web_sales_by_year_gold")
gold_df: pd.DataFrame = run_trino("SELECT * FROM hive.tcdm.web_sales_by_year_gold ORDER BY d_year")
gold_df
DESCRIBE muestra el esquema declarado en el CREATE TABLE, no el de los
ficheros. Si el tipo declarado para beneficio_neto no coincidiera con el
del Parquet físico, la señal aparecería al leer: Trino se quejaría en el
SELECT anterior o los valores saldrían como NULL. El conector Hive de
Trino asocia columnas por nombre y espera un tipo compatible con el que
encuentra en el fichero; no infiere el esquema por sí solo.
Consultar con Trino
Con las tres tablas registradas, exploramos el catálogo desde Trino como lo haría cualquier herramienta de BI o cualquier persona analista que sólo conozca el nombre lógico de las tablas, sin saber nada de rutas HDFS.
run_trino("SHOW SCHEMAS FROM hive")
run_trino("SHOW TABLES FROM hive.tcdm")
Estadísticas antes y después de ANALYZE
El metastore puede guardar estadísticas por columna (número de valores
distintos aproximado, fracción de nulos, tamaño medio...) que el planificador
de Trino usa para elegir el orden de los JOIN o el tipo de agregación. Esas
estadísticas no se calculan solas: hace falta pedirlas explícitamente con
ANALYZE.
run_trino("SHOW STATS FOR hive.tcdm.web_sales_silver")
run_trino("ANALYZE hive.tcdm.web_sales_silver")
run_trino("SHOW STATS FOR hive.tcdm.web_sales_silver")
explain_filtered_tras_analyze: pd.DataFrame = run_trino(
    '''EXPLAIN SELECT count(*) FROM hive.tcdm.web_sales_silver
    WHERE sold_year = 2000 AND sold_month = 1'''
)
print("\n".join(explain_filtered_tras_analyze.iloc[:, 0].tolist()))
Compara ambas tablas de estadísticas: antes de ANALYZE, la mayoría
de columnas numéricas (nulls_fraction, distinct_values_count,
data_size) aparecen vacías o son estimaciones muy toscas basadas sólo en el
tamaño de los ficheros; después, cada columna trae una estimación calculada
sobre los datos reales, y la fila final añade row_count. Los EXPLAIN de
unas celdas más arriba se ejecutaron antes de este ANALYZE, así que
planificaron sin estas estadísticas de columna. La celda anterior ha
repetido el EXPLAIN de la misma consulta filtrada: compáralo con el de
antes de ANALYZE y fíjate en las líneas Estimates, donde el número de
filas estimado deja de aparecer como desconocido (?). El optimizador ya
dispone de estas estadísticas para decidir el plan.
Consultar la misma tabla con Spark
Ahora usamos la SparkSession que configuramos al principio del notebook
para leer la misma definición de tabla, no para releer el Parquet por
ruta como en S4. La diferencia es la que separa "Spark lee ficheros" de
"Spark es un cliente del catálogo": aquí no aparece ninguna ruta HDFS en el
código, sólo el nombre lógico tcdm.web_sales_silver.
spark.sql("SHOW TABLES IN tcdm").show()
from pyspark.sql import DataFrame

web_sales_silver_spark: DataFrame = spark.table("tcdm.web_sales_silver")
web_sales_silver_spark.printSchema()
spark.sql('''SELECT sold_year, sold_month, count(*) AS lineas_de_venta
    FROM tcdm.web_sales_silver
    GROUP BY sold_year, sold_month
    ORDER BY sold_year, sold_month''').show(100)
Comparar ubicación y esquema
DESCRIBE FORMATTED en Spark es el equivalente de SHOW CREATE TABLE en
Trino: expone la ubicación física, el formato de fichero y las columnas de
partición tal como las ve el mismo metastore.
spark.sql("DESCRIBE FORMATTED tcdm.web_sales_silver").show(100, truncate=False)
Busca en la salida la línea Location: debe ser la misma ruta HDFS
que declaraste como external_location en el CREATE TABLE de Trino, y las
líneas Partition Provider / # Partition Information deben mencionar
sold_year y sold_month. Spark no ha vuelto a preguntar "dónde están los
datos": lo ha leído del mismo metastore que consultó Trino.
Comparar el resultado de negocio
Repetimos, con Spark, la misma pregunta de negocio que ya respondió Trino
sobre tcdm.web_sales_by_year_gold, y comprobamos que ambos motores
devuelven exactamente los mismos números sobre la misma definición de tabla.
gold_spark_df: pd.DataFrame = spark.sql(
    "SELECT d_year, pedidos, lineas_de_venta, beneficio_neto FROM tcdm.web_sales_by_year_gold ORDER BY d_year"
).toPandas()
gold_spark_df
comparacion: pd.DataFrame = gold_df.merge(gold_spark_df, on="d_year", suffixes=("_trino", "_spark"))
comparacion["beneficio_neto_trino"] = comparacion["beneficio_neto_trino"].astype(float)
comparacion["beneficio_neto_spark"] = comparacion["beneficio_neto_spark"].astype(float)
comparacion["diferencia_beneficio"] = (
    comparacion["beneficio_neto_trino"] - comparacion["beneficio_neto_spark"]
).abs()

assert (comparacion["pedidos_trino"] == comparacion["pedidos_spark"]).all()
assert (comparacion["lineas_de_venta_trino"] == comparacion["lineas_de_venta_spark"]).all()
assert (comparacion["diferencia_beneficio"] < 0.01).all()
print("Trino y Spark devuelven el mismo resultado de negocio sobre tcdm.web_sales_by_year_gold.")
comparacion
Plan de lectura y caché de metadatos
explain() en Spark, igual que EXPLAIN en Trino, deja ver si el filtro por
columnas de partición se resuelve podando particiones antes de leer ningún
fichero (PartitionFilters en el plan) o si Spark tiene que abrir todos los
ficheros y filtrar después.
spark.sql("SELECT * FROM tcdm.web_sales_silver WHERE sold_year = 2000 AND sold_month = 1").explain(
    "formatted"
)
Busca PartitionFilters en la sección del Scan: debe incluir la
condición sobre sold_year/sold_month, la misma poda que ya viste en el
plan de Trino.
Un último aviso, coherente con el objetivo docente sobre cachés de
metadatos: Spark guarda en memoria del driver la lista de particiones que ya
ha visto para una tabla externa. Si otro cliente —Trino, Hive o el propio
sync_partition_metadata— añade particiones nuevas después de que Spark ya
haya consultado la tabla en esta sesión, Spark no las verá hasta que se le
pida explícitamente que refresque esa tabla:
spark.catalog.refreshTable("tcdm.web_sales_silver")
No hace falta ejecutarlo ahora —no hemos añadido particiones nuevas después de leer la tabla con Spark—, pero es el motivo por el que a veces una tabla "no aparece actualizada" en Spark aunque Trino ya vea los datos nuevos.
Tabla administrada: tcdm.web_sales_by_year_managed_demo
Para cerrar la comparación externa/administrada, creamos una tabla de
laboratorio con CREATE TABLE ... AS SELECT (CTAS) a partir de la tabla gold
que ya registramos. No se declara ningún external_location: dejamos que
Hive/Trino elijan la ubicación bajo /warehouse.
run_trino("DROP TABLE IF EXISTS hive.tcdm.web_sales_by_year_managed_demo")

ctas_sql: str = '''
CREATE TABLE hive.tcdm.web_sales_by_year_managed_demo
WITH (format = 'PARQUET') AS
SELECT * FROM hive.tcdm.web_sales_by_year_gold
'''
run_trino(ctas_sql)
print("tcdm.web_sales_by_year_managed_demo creada (tabla administrada).")
run_trino("SHOW CREATE TABLE hive.tcdm.web_sales_by_year_managed_demo")
Compara este SHOW CREATE TABLE con el de tcdm.web_sales_by_year_gold:
la tabla administrada no declara external_location, y su ubicación real
—visible también en la propiedad location que añade Trino— cae bajo
/warehouse/tcdm.db/web_sales_by_year_managed_demo, siguiendo el patrón
/warehouse/<esquema>.db/<tabla> que se explicó en «Tabla administrada en
el warehouse».
Lo comprobamos directamente en HDFS:
!hdfs dfs -ls -R -h /warehouse/tcdm.db/web_sales_by_year_managed_demo
Ahí sí hay ficheros Parquet nuevos, escritos por el propio CTAS: a
diferencia de las tablas externas de las secciones anteriores, esta tabla
sí copió y materializó los datos. Es la diferencia observable entre
registrar una ubicación existente y pedirle al motor que gestione una nueva.
Qué ocurre al borrar cada tipo de tabla
La diferencia entre los dos modelos se ve al borrar. Para no tocar ninguna
tabla de la sesión, creamos dos tablas efímeras con los mismos datos de
gold: una administrada, cuya ubicación elige el catálogo, y una externa,
sobre una ruta de trabajo propia bajo /user/luser/s6.
!hdfs dfs -mkdir -p /user/luser/s6
!hdfs dfs -rm -r -f /user/luser/s6/drop_demo_external

run_trino("DROP TABLE IF EXISTS hive.tcdm.drop_demo_managed")
run_trino("DROP TABLE IF EXISTS hive.tcdm.drop_demo_external")

run_trino('''
    CREATE TABLE hive.tcdm.drop_demo_managed
    WITH (format = 'PARQUET') AS
    SELECT * FROM hive.tcdm.web_sales_by_year_gold
''')
run_trino('''
    CREATE TABLE hive.tcdm.drop_demo_external
    WITH (
        format = 'PARQUET',
        external_location = 'hdfs://namenode:9000/user/luser/s6/drop_demo_external'
    ) AS
    SELECT * FROM hive.tcdm.web_sales_by_year_gold
''')
print("Tablas efímeras creadas: drop_demo_managed y drop_demo_external.")
Antes de borrar, las dos tienen ficheros en HDFS: la administrada bajo
/warehouse/tcdm.db, la externa en la ruta que le indicamos.
!hdfs dfs -ls /warehouse/tcdm.db/drop_demo_managed /user/luser/s6/drop_demo_external
Ahora ejecutamos el mismo DROP TABLE sobre las dos y volvemos a mirar
HDFS.
import subprocess

run_trino("DROP TABLE hive.tcdm.drop_demo_managed")
run_trino("DROP TABLE hive.tcdm.drop_demo_external")


def hdfs_dir_exists(path: str) -> bool:
    return subprocess.run(["hdfs", "dfs", "-test", "-d", path]).returncode == 0


managed_dir_exists: bool = hdfs_dir_exists("/warehouse/tcdm.db/drop_demo_managed")
external_dir_exists: bool = hdfs_dir_exists("/user/luser/s6/drop_demo_external")
print(f"¿Sigue el directorio de la tabla administrada? {managed_dir_exists}")
print(f"¿Sigue el directorio de la tabla externa?      {external_dir_exists}")

assert not managed_dir_exists
assert external_dir_exists
!hdfs dfs -ls /user/luser/s6/drop_demo_external
Las dos tablas han desaparecido del catálogo, pero sólo la administrada se
ha llevado sus ficheros: los de la externa siguen en HDFS, sin ninguna
definición que los describa. Por eso el DROP TABLE de una tabla externa no
es una forma de borrar datos, y por eso las definiciones de /datalake se
pueden eliminar y volver a crear sin riesgo. Borrar esos ficheros es una
decisión aparte:
!hdfs dfs -rm -r /user/luser/s6/drop_demo_external
Buenas prácticas de catálogo y data lake
El metastore permite formalizar las decisiones de S5:
- cada tabla tiene un propietario y una descripción;
- la ubicación física está documentada;
- el esquema y las claves tienen un contrato;
- las columnas de partición se justifican por las consultas que se van a hacer, no se añaden "por si acaso";
- los ficheros auxiliares (
_SUCCESS, checksums...) no se confunden con datos de la tabla; - las estadísticas se generan y se revisan cuando son necesarias, no una vez y para siempre;
- las tablas fuente y las tablas derivadas tienen ciclos de vida distintos: borrar una tabla derivada nunca debe poder borrar su fuente;
- una regeneración no borra datos ajenos;
- las operaciones de limpieza están separadas de las consultas normales, como se hace en la última sección de este notebook.
El metastore mejora la localización y la reutilización, pero no proporciona
por sí solo transacciones completas, historial de versiones ni una política
de calidad de datos. Un INSERT fallido a mitad de camino, dos escrituras
concurrentes sobre la misma partición o la necesidad de "viajar en el
tiempo" a una versión anterior de la tabla son problemas que el Hive
Metastore no resuelve. Esas limitaciones son exactamente las que motivan
introducir Iceberg en S7.
Preguntas para interpretar la experiencia
- ¿Qué diferencia observable hay entre
tcdm.date_dimytcdm.web_sales_by_year_managed_demoen cuanto a lo que ocurre en HDFS al ejecutar elCREATE TABLE? - ¿Por qué
SELECT count(*) FROM hive.tcdm.web_sales_silverdevolvió 0 filas justo después delCREATE TABLE, si los ficheros ya existían en HDFS desde que terminó S5? - ¿Por qué Trino no admite
MSCK REPAIR TABLEy qué usa en su lugar? ¿Por qué esa misma sentencia sí funciona en Spark SQL? - ¿Qué información añade
hive.tcdm."web_sales_silver$partitions"que no aparece en unDESCRIBEnormal de la tabla? - ¿Qué cambia entre el plan de
EXPLAINde una consulta sin filtrar y el de una consulta filtrada porsold_year/sold_month? ¿Dónde exactamente aparece la poda de particiones en el plan? - ¿Qué mostraba
SHOW STATS FOR hive.tcdm.web_sales_silverantes deANALYZEy qué cambió después? ¿Para qué las usa el planificador? - ¿Por qué se dice que Spark y Trino son "dos clientes de la misma definición" y no "dos catálogos distintos"? ¿Qué comprobación de esta sesión lo demuestra?
- ¿Qué podría pasar si, tras crear una tabla externa con
CREATE TABLE, ejecutasDROP TABLEsobre ella? ¿Y si en su lugar borraras la tabla administradatcdm.web_sales_by_year_managed_demo? ¿Por qué la respuesta es distinta en cada caso? - ¿Qué limitación del Hive Metastore, de las mencionadas en «Buenas prácticas de catálogo y data lake», esperarías que resolviera un formato de tabla como Iceberg?
Evidencias para la siguiente sesión
Antes de la siguiente sesión tendrás una reunión individual breve con el profesor para revisar el trabajo de esta sesión. Esa reunión combina una demostración en vivo sobre tu propio ordenador y una memoria escrita breve.
Qué mostrar en el ordenador durante la reunión
Ten preparadas estas evidencias:
- El
SHOW CREATE TABLEdetcdm.date_dim,tcdm.web_sales_silverytcdm.web_sales_by_year_gold, mostrando que las tres son tablas externas conexternal_locationapuntando a/datalake. - El recuento de filas de
tcdm.web_sales_silverantes y después deCALL hive.system.sync_partition_metadata(...), junto con la explicación de por qué cambia. - El contenido de
hive.tcdm."web_sales_silver$partitions". - Un plan de
EXPLAIN(oEXPLAIN ANALYZE) que muestre la poda de particiones al filtrar porsold_year/sold_month. - La tabla de
SHOW STATS FOR hive.tcdm.web_sales_silverantes y después deANALYZE. - El mismo resultado de negocio de
tcdm.web_sales_by_year_goldobtenido desde Trino y desde Spark, comprobando que coinciden fila a fila. - El
SHOW CREATE TABLEdetcdm.web_sales_by_year_managed_demoy el listado HDFS de su ubicación bajo/warehouse/tcdm.db/, comparado con el de una tabla externa. - Que sabes explicar, con tus propias palabras, la diferencia entre eliminar la definición de una tabla externa y eliminar una tabla administrada.
Memoria escrita (una o dos páginas)
Trae también un documento breve —una o dos páginas, no hace falta más— que
no se limite a pegar capturas de las salidas anteriores: debe explicar con
tus propias palabras qué papel tiene cada pieza de la arquitectura
(PostgreSQL, Hive Metastore, Trino y Spark); qué diferencia hay entre una
tabla externa y una administrada, y qué ocurre con los datos al borrar cada
una; por qué la tabla particionada devolvía cero filas hasta sincronizar
sus particiones; para qué sirven las estadísticas de ANALYZE; y qué
limitaciones del metastore justifican introducir Iceberg.
Qué es importante de cara al examen final
El examen no pide recordar la sintaxis exacta de una sentencia. Debes poder explicar:
- qué problema resuelve un catálogo frente a una ruta física, y qué guarda y qué no guarda el Hive Metastore;
- por qué el metastore no es un motor de consultas y Trino no es un catálogo, y qué significa que Spark y Trino sean dos clientes de la misma definición de tabla;
- la diferencia entre tabla externa y tabla administrada: ubicación y ciclo de vida de los datos;
- que una partición Hive son dos cosas, un directorio
columna=valory una fila de metadatos, y por qué hace falta un paso de descubrimiento; - cómo se reconoce en un plan la poda de particiones y la selección de columnas;
- qué son las estadísticas de tabla y de columna y para qué las usa el planificador;
- qué no ofrece el metastore: transacciones, historial de versiones y evolución segura del esquema.
Detener y limpiar
Estas operaciones se muestran como texto, no como celdas de código, para que
un «ejecutar todo» de este notebook no las dispare por accidente. La tabla
administrada de esta sesión es un recurso de laboratorio: consérvala hasta
la reunión de evidencias, que la necesita, y bórrala después. Nunca
apliques el mismo razonamiento a las tablas externas, cuyo DROP TABLE
sólo afecta al catálogo; y no elimines sus definiciones antes de terminar
S7, que parte de ellas.
| Situación | Orden | Consecuencia |
|---|---|---|
| Eliminar sólo la tabla de laboratorio (administrada) | DROP TABLE hive.tcdm.web_sales_by_year_managed_demo (desde el cliente Trino de este notebook, o docker exec trino-hdfs trino --user luser --execute "..." desde una terminal) |
Borra tanto la entrada del metastore como los ficheros Parquet bajo /warehouse/tcdm.db/web_sales_by_year_managed_demo: es una tabla administrada, su ciclo de vida de datos depende del catálogo. |
| Eliminar las definiciones externas de esta sesión | DROP TABLE hive.tcdm.date_dim, DROP TABLE hive.tcdm.web_sales_silver, DROP TABLE hive.tcdm.web_sales_by_year_gold |
Borra únicamente las tres entradas del metastore. Los Parquet de /datalake/raw, /datalake/silver y /datalake/gold siguen intactos: nunca interpretes este DROP TABLE como "borrar el data lake". S7 necesita las tres definiciones: no las elimines hasta haberla terminado. |
| Parar temporalmente el warehouse | docker compose -f entorno/compose-warehouse-hdfs.yml stop |
Conserva PostgreSQL, Hive Metastore y Trino (y su contenido); se reanuda con start. No afecta al clúster Hadoop. |
| Eliminar el warehouse por completo (destructivo) | docker compose -f entorno/compose-warehouse-hdfs.yml down -v --remove-orphans |
Borra también el volumen de PostgreSQL: se pierde todo el contenido del Hive Metastore, incluidas las definiciones de esta sesión. No borra ni /datalake ni /warehouse en HDFS: los ficheros Parquet de las tablas externas y los de la tabla administrada de laboratorio (si no se borró antes) seguirían ahí, ahora sin ninguna definición de catálogo que los describa. Tras volver a levantar el warehouse haría falta repetir los CREATE TABLE de este notebook. |
No confundas ese down -v del warehouse con el down/volume rm de S1
(clúster Hadoop) o con el down -v de la sesión 3 (RustFS): cada Compose
tiene su propio
volumen y afecta sólo a sus propios servicios.
Siguiente paso
S6 muestra que el metastore da nombres y metadatos compartidos a una
organización de Parquet, y que Spark y Trino pueden consultar exactamente la
misma definición sin duplicar configuración. S7 introducirá Iceberg como
formato de tabla para gestionar cambios, snapshots y particionado evolutivo,
partiendo de la misma tcdm.web_sales_silver que se acaba de registrar aquí
— sin presentar esa transición como un simple cambio de nombre en el
catálogo.