Sesión 5 — Buenas prácticas de data lake y particionado físico
Esta sesión se sitúa justo después de S4: ya sabemos leer Parquet con Spark, construir DataFrames y ejecutar transformaciones tanto en local como sobre YARN. Toca dar un paso que no es de motor sino de organización: un data lake no es solamente un directorio lleno de ficheros Parquet. También necesita convenciones de nombres, contratos documentados, comprobaciones de calidad y una estrategia de mantenimiento, para que el mismo conjunto de datos pueda reutilizarse, entenderse y consultarse eficientemente sin convertirlo todavía en una tabla gestionada por un catálogo.
La pregunta central de esta sesión es:
¿Cómo organizamos los ficheros para que sean reutilizables, comprensibles y eficientes sin convertir todavía el data lake en una tabla gestionada?
Para responderla mantendremos el mismo TPC-DS SF1 de las sesiones anteriores y compararemos tres versiones del mismo dato: la fuente raw que ya conoces de S2, una versión refinada silver que construiremos con Spark, y un agregado de negocio gold derivado de esa versión refinada. El recorrido completo del curso hasta este punto, y el siguiente paso, son:
S2: datos fuente como Parquet sin catálogo
  → S3: los mismos objetos sobre un almacenamiento S3-compatible
  → S4: Spark procesa los ficheros, en local y sobre YARN
  → S5: Spark escribe datos silver y un producto gold
  → S6: el Metastore registra esa organización como tabla Hive
Al terminar S5 seguimos teniendo un data lake basado en ficheros: que los
directorios sigan el patrón columna=valor no crea por sí mismo una tabla
permanente ni proporciona snapshots, transacciones o evolución de esquema.
Eso llegará con el Hive Metastore en S6 y con Iceberg en S7. Lo que sí
habremos hecho es aplicar, de forma observable, la arquitectura medallion
que ya se mencionó al crear el data lake en S1 y al explorar la zona raw
en S2: datos detallados y reutilizables en silver, y un agregado orientado
a una pregunta de negocio en gold.
Paquetes de Python de esta sesión. Esta sesión necesita
pyspark. No añade ningún paquete respecto a S4. Se instalan en el kernel denamenodeen la sección «Instalar PySpark en este notebook»: una celda%%writefile requirements.txtcrea el fichero dentro del contenedor —elrequirements.txtde tu copia des5/está en tu equipo ynamenodeno lo ve— y otra ejecuta%pip install -r requirements.txt. La imagen denamenodeya trae estos paquetes en su entorno Python del curso,/opt/tcdm/venv, que es el intérprete del kernel y donde instala%pip; lo normal es que%pipsólo confirme que están; ejecuta esas celdas de todos modos: dejan explícito qué necesita la sesión y reparan el entorno si falta algo.
Diapositivas de la sesión
Las diapositivas se generan con el paquete jupyter-notebook-slide.
El alias %%diapositiva permite mantener en español los tipos usados en la sesión y produce la misma salida HTML en Jupyter, Colab y la referencia HTML publicada.
En cada sesión encontrarás varios tipos de diapositivas que te ayudarán a seguir el hilo:
- Sección (
titulo): abre la sesión y resume qué vamos a ver y qué haremos. - A continuación (
avance): anuncia el contenido de la parte siguiente, para saber en qué punto del programa estamos. - Recapitulación (
resumen): condensa la parte anterior en puntos clave para recordarlos y revisarlos después. - Pregunta guía (
pregunta): plantea cuestiones que orientan lo que viene a continuación; conviene intentar responderlas antes de seguir. - Evaluación de la sesión (
evaluacion): recuerda cómo se evalúa el trabajo de esta sesión.
%pip install -q "jupyter-notebook-slide @ git+https://github.com/dsevilla/jupyter-notebook-slide.git"
%load_ext notebook_slide

import notebook_slide as jnbs

# Colores de 26-27/teoria/tcdm.css, adaptados al tema de las sesiones.
jnbs.configure(
    background="#eaf2f8",
    foreground="#1f2933",
    border="#c9d6e1",
    heading="#0c304d",
    subheading="#0c304d",
    link="#174f7a",
    code_background="#eaf2f8",
    code_foreground="#0c304d",
    quote_background="#ffffff",
    font_family="Atkinson Hyperlegible, Inter, Aptos, Segoe UI, Helvetica, Arial, sans-serif",
    font_url="https://fonts.googleapis.com/css2?family=Atkinson+Hyperlegible:ital,wght@0,400;0,700;1,400;1,700&display=swap",
)
jnbs.register_slide_type("avance", "A continuación", "#174f7a")
jnbs.register_slide_type("resumen", "Recapitulación", "#a54467")
jnbs.register_slide_type("pregunta", "Pregunta guía", "#0c304d")
jnbs.register_slide_type("evaluacion", "Evaluación de la sesión", "#b3701a")
jnbs.register_slide_type(
    "titulo",
    "Sección",
    "#174f7a",
    layout="title",
    background="linear-gradient(135deg, #0c304d, #174f7a 62%, #a54467)",
    foreground="#ffffff",
    border="transparent",
    heading="#ffffff",
    subheading="#dceaf4",
)
jnbs.register_alias("diapositiva")
Objetivos de la sesión
Al terminar esta sesión deberías poder:
- explicar la arquitectura medallion (
raw/silver/gold) y qué papel cumple cada zona en un data lake basado en ficheros; - escribir el contrato de una salida de datos: rutas, columnas, claves de unión, significado de cada métrica, formato y regla de regeneración;
- distinguir el particionado físico por directorios
columna=valorde otras nociones que comparten la palabra "partición": las particiones de ejecución de Spark, los bloques HDFS, los splits de un motor SQL y las transformaciones de partición de una tabla Iceberg; - justificar la elección de columnas de partición a partir de los patrones de consulta y de la cardinalidad de los datos, no por costumbre;
- construir con Spark una tabla
silverparticionada por año y mes a partir deweb_salesydate_dim, conservando una salida de control sin particionar para comparar; - validar, con comprobaciones ejecutables (no sólo visuales), que una unión no multiplica ni pierde filas y que las claves de unión no aparecen inesperadamente nulas;
- agregar desde
silverun productogoldorientado a una pregunta de negocio y distinguir la métrica de pedidos de la métrica de líneas de venta; - observar el descubrimiento automático de particiones al releer una tabla particionada por su ruta raíz, y comparar una lectura completa con una lectura filtrada mirando el plan físico y los ficheros efectivamente leídos, no el tiempo de reloj;
- describir qué límites sigue teniendo una colección de Parquet particionada sin catálogo, como preparación para S6.
Antes de empezar
Dónde se ejecuta este notebook. Igual que en S2, S3 y S4, Jupyter se ejecuta directamente dentro del contenedor
namenode, comoluser, con acceso de red directo a HDFS y YARN. Las celdas ejecutables hablan directamente con el clúster. Las órdenes que necesitan el Docker del host —arrancar o detener contenedores,make— se muestran como texto para ejecutarlas en una terminal de tu equipo, nunca como celdas de este notebook.
Esta sesión asume que el clúster de S1 ya está en marcha y que S2 dejó
materializado TPC-DS SF1 en /datalake/raw/tpcds (S4 sólo lo leyó). S5 no
vuelve a generar esos datos ni los modifica: se limita a leerlos. Si el clúster no
está arriba, desde una terminal de tu equipo situada en la raíz de la
distribución de sesiones:
cd ~/tcdm-public
git pull
make -C entorno warehouse-up
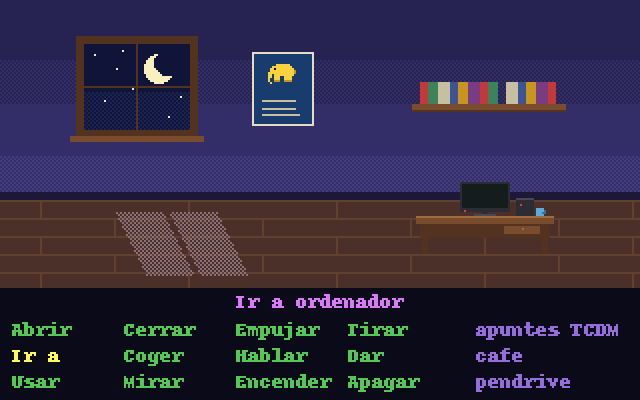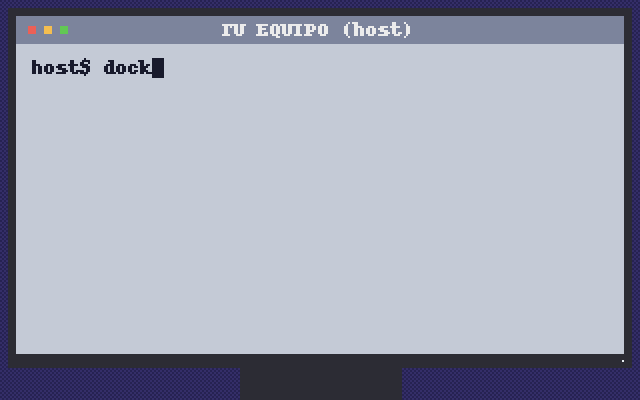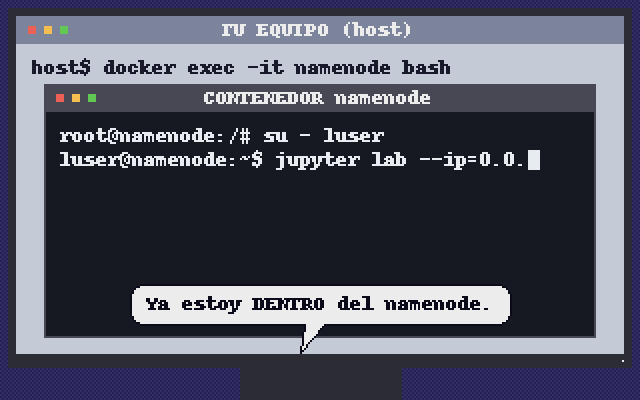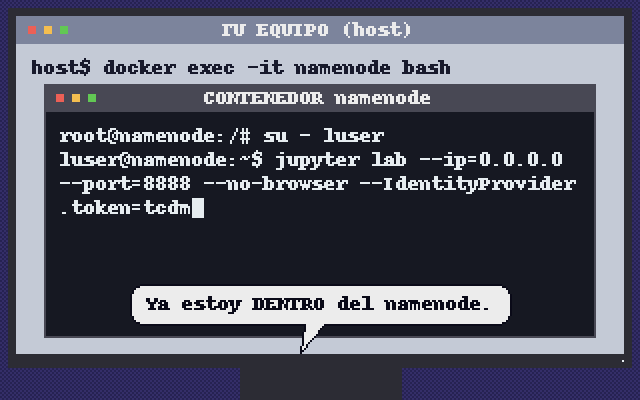
Este notebook se ejecuta en el Jupyter de namenode, que no arranca solo.
Como en S2, arráncalo desde otra terminal de tu equipo y déjala abierta
mientras trabajes:
# en tu equipo: entra en namenode
docker exec -it namenode bash
# ya dentro de namenode, como luser: Jupyter con el token fijo «tcdm»
su - luser
jupyter lab --ip=0.0.0.0 --port=8888 --no-browser --IdentityProvider.token=tcdm
La primera orden es la única que se ejecuta en tu equipo; las otras dos, ya
dentro del contenedor, arrancan Jupyter con el Python del curso
(make -C entorno jupyter hace lo mismo en una sola orden). En Visual
Studio Code, conecta este notebook con Select Kernel → Select Another
Kernel → Existing Jupyter Server, usando la dirección
http://127.0.0.1:8888/lab?token=tcdm y eligiendo el kernel Python 3
(ipykernel). El token es siempre tcdm.
Si algo no funciona —el notebook no conecta, una celda !hdfs no
encuentra la orden, un servicio no responde—, consulta «Solución de
problemas» en entorno/README.md.
Antes de instalar nada, comprueba que la fuente sigue donde S2 la dejó y S4 la utilizó:
!hdfs dfs -ls -d /datalake/raw/tpcds
Si el directorio no existe, revisa S2 antes de continuar: esta sesión no
regenera TPC-DS. Tampoco vamos a tocar nada bajo esa ruta: todas las
escrituras de este notebook van a /datalake/silver, /datalake/gold o a
la ruta de trabajo /user/luser/s5.
Instalar PySpark en este notebook
Como en S4, el kernel de este notebook instala PySpark directamente sobre
sí mismo. Construiremos una única SparkSession en modo local[2] un poco
más abajo y la reutilizaremos en todo el notebook: aquí no hay una sección
de envío a YARN como en S4, porque el objetivo de S5 no es comparar motores
de ejecución sino la organización física de la salida.
La celda siguiente crea requirements.txt con %%writefile dentro de
namenode —el de tu copia de la distribución está en tu equipo y el kernel no
lo ve— y la posterior lo instala con %pip en el intérprete del kernel. La
imagen de namenode ya trae PySpark, así que lo normal es que %pip sólo
confirme que está.
%%writefile requirements.txt
# Dependencias del kernel interactivo de la sesión 5 (Spark en modo local).
# La serie de PySpark aceptada por el curso es >4,<4.2.
pyspark>4,<4.2
%pip install -q -r requirements.txt
import sys

import pyspark

print(f"PySpark {pyspark.__version__} con Python {sys.version.split()[0]}.")
Crear una SparkSession local
La memoria del driver se deja deliberadamente modesta, por el mismo motivo
que en S4: esta JVM comparte el contenedor namenode con el propio
NameNode, el ResourceManager, el Timeline Server y el kernel de Jupyter
(recuerda la tabla de límites de S1: 2 vCPU y 4096 MiB para todo el
contenedor; cada NodeManager, aparte, sólo anuncia 2560 MiB a YARN). Para
los volúmenes de SF1 que vamos a leer y escribir no hace falta más.
from pyspark import SparkContext
from pyspark.sql import SparkSession

spark: SparkSession = (
    SparkSession.builder.appName("TCDM_S5_Local")
    .master("local[2]")
    .config("spark.driver.memory", "1g")
    .config("spark.sql.shuffle.partitions", "8")
    .getOrCreate()
)
sc: SparkContext = spark.sparkContext

print(f"Spark version: {spark.version} | Master: {sc.master} | App: {sc.appName}")
Buenas prácticas de data lake
Un data lake de ficheros no deja de ser un data lake por no tener un catálogo permanente: puede ser correcto, reproducible y eficiente si se siguen algunas convenciones básicas. Esta sección describe esas convenciones antes de aplicarlas en código; son las mismas que justificarán, en S6, por qué merece la pena registrar estas rutas en un Hive Metastore en lugar de dejarlas como simples directorios.
Conservar una zona fuente
Los Parquet de /datalake/raw/tpcds representan la fuente reproducible del
curso. Ninguna transformación de esta sesión los sobrescribe. Conservar
una fuente inmutable permite repetir una sesión, comparar lectores y
motores, reconstruir una tabla refinada si cambia el código de
transformación, comprobar que una transformación no altera los datos
originales, y mantener una referencia estable frente a la que comprobar
cualquier resultado derivado.
La organización lógica del data lake del curso puede describirse mediante tres zonas. Las etiquetas raw, silver y gold son una ayuda de diseño, no una garantía de calidad por sí mismas: cada conjunto debe documentar su origen, su transformación, su esquema y quién es responsable de mantenerlo.
| Zona | Función | Aplicación en el curso |
|---|---|---|
| Fuente o raw | Datos originales, conservados e inmutables | /datalake/raw/tpcds |
| Refinada o silver | Datos limpiados, enriquecidos y reorganizados | /datalake/silver/tpcds |
| Curada o gold | Productos preparados para una pregunta o consumidor concreto | /datalake/gold |
Esta terminología sigue la arquitectura medallion documentada por
Databricks: los
datos ganan estructura y calidad a medida que avanzan desde la ingestión
hasta los productos destinados al consumo. El segundo nivel de cada ruta
identifica la fuente y permite incorporar otras colecciones sin mezclarlas:
por ejemplo, /datalake/raw/weather o /datalake/raw/prices convivirían
con /datalake/raw/tpcds sin interferir entre sí. Una transformación que
algún día cruzara esas fuentes con TPC-DS escribiría un conjunto nuevo en
silver o un producto específico en gold, dejando intactas las entradas
raw.
Contratos y nombres
Cada salida de datos debe tener una ruta estable y documentada. Para
/datalake/silver/tpcds/web_sales y /datalake/gold/tpcds/web_sales_by_year,
el contrato que aplicaremos en esta sesión —y que documentamos aquí mismo,
en lugar de dejarlo sólo en la cabeza de quien escribió el código— indica:
- qué tabla y escala de TPC-DS contiene:
web_salesde TPC-DS SF1; - qué columnas conserva o añade: las columnas de negocio de la línea de
venta más
ws_sold_date(derivada) y las particionessold_year,sold_month; - qué claves de unión utiliza:
ws_sold_date_sk = d_date_skcontradate_dim; - qué significa cada métrica del producto
gold: pedidos distintos, líneas de venta y beneficio neto, sin confundir unas con otras; - dónde vive el producto
goldy qué columnas tiene: una fila porsold_yearen/datalake/gold/tpcds/web_sales_by_year, con esas tres métricas; - qué formato y compresión emplea: Parquet con la compresión por defecto de Spark;
- qué columnas se utilizan para particionar:
sold_yearysold_month, en ese orden; - cómo se regenera cada salida:
silverygoldse reconstruyen volviendo a ejecutar las celdas de la sección "Ejercicio de transformación con Spark" de este notebook, que escriben siempre en modooverwrite(primerosilver, ygolda partir desilver, no deraw); - qué ficheros auxiliares no deben leerse como datos: en particular,
_SUCCESSes un marcador de generación, no un fragmento Parquet, y no debe incluirse en los patrones de lectura.
Esquema y calidad
Antes de dar por buena una salida —y desde luego antes de que otra sesión la registre como tabla— conviene comprobar al menos:
- que el esquema es el esperado, tanto en nombres como en tipos;
- que las claves necesarias no aparecen inesperadamente nulas;
- que el número de filas es razonable, comparado con la fuente;
- que los rangos de fechas y claves tienen sentido (por ejemplo, que
sold_monthesté siempre entre 1 y 12); - que las uniones no multiplican filas por error;
- que la métrica de negocio distingue líneas de venta de pedidos distintos;
- que los ficheros se pueden leer con más de un lector cuando sea relevante (ya lo comprobamos en S2 con PyArrow, Polars y DuckDB sobre la misma fuente).
Estas comprobaciones no sustituyen a un sistema de calidad de producción,
pero enseñan que escribir ficheros Parquet correctamente no basta, por sí
solo, para tener datos fiables. Más abajo, en la sección de transformación,
convertiremos varias de estas comprobaciones en assert ejecutables: no
son comentarios que digan "esto debería cumplirse", son afirmaciones que
detienen el notebook si no se cumplen.
Qué significa particionar
Particionar datos consiste en agrupar físicamente filas relacionadas y escribirlas en directorios que codifican valores de columnas. Para la tabla que vamos a construir, la estructura de directorios tendrá esta forma:
web_sales/
├── sold_year=1998/
│   ├── sold_month=1/
│   │   └── part-....parquet
│   ├── sold_month=2/
│   │   └── part-....parquet
│   └── ...
├── sold_year=1999/
│   └── ...
└── ...
Una consulta que filtra por sold_year (y, más aún, por sold_year junto
con sold_month) puede evitar leer directorios completos que no contienen
datos relevantes. Spark puede descubrir esas columnas a partir de la ruta,
incluso sin un Hive Metastore de por medio: al leer la ruta raíz de la
tabla, sold_year y sold_month aparecen como columnas normales del
DataFrame aunque no estén dentro de ningún fichero Parquet. Cuando haga
falta indicar explícitamente desde qué directorio raíz debe realizarse ese
descubrimiento —por ejemplo, al leer un único subdirectorio de partición—
existe la opción basePath.
Este particionado físico por directorios no debe confundirse con otras cosas que también se llaman "partición" y que ya han aparecido en el curso:
- las particiones de ejecución de Spark, la unidad sobre la que trabaja cada tarea del motor (S4, sección "Particiones de ejecución");
- los bloques HDFS, la unidad de almacenamiento físico de bytes en el sistema de ficheros (S1);
- los splits que un motor SQL crea al planificar una consulta sobre un conjunto de ficheros;
- las particiones lógicas y transformaciones ocultas que tendrá una
tabla Iceberg (
month(),year()...), que veremos en S7 y que usarán la misma columna de fecha derivada que estamos a punto de construir, pero gestionadas por el propio formato de tabla en lugar de por el nombre de un directorio.
Ampliando la tabla de "Capas que se deben distinguir" de S4:
| Concepto | Significado |
|---|---|
| Partición de ejecución de Spark | Porción lógica de un DataFrame que procesa una tarea; depende del paralelismo, no de cómo están organizados los ficheros en disco |
| Bloque HDFS | Unidad de almacenamiento físico de bytes; no tiene por qué coincidir con una fila, una columna ni un fichero completo |
| Partición Hive (esta sesión) | Directorio columna=valor que agrupa físicamente filas por el valor de una o varias columnas |
| Partición/transformación Iceberg (S7) | Agrupación lógica gestionada por el formato de tabla, que puede usar transformaciones como month() sin exigir una columna física propia |
Compartir la palabra "partición" no las convierte en la misma unidad; a lo
largo de esta sesión seguiremos usando siempre "partición Hive" o
"directorio columna=valor" cuando nos refiramos específicamente a lo que
vamos a construir aquí.
Diseño de las particiones
Las columnas de partición deben elegirse a partir de las consultas y del
tamaño de los datos, no por costumbre. Una buena elección debe: aparecer
habitualmente en los filtros de las consultas que se esperan sobre la
tabla; tener una cardinalidad moderada (ni una única partición gigante, ni
miles de particiones diminutas); producir directorios suficientemente
grandes como para que merezca la pena evitar leerlos; poder explicarse con
una frase a quien vaya a consultar la tabla; y no generar un número
excesivo de ficheros pequeños, el mismo problema que ya vimos en S4 con
repartition frente a coalesce.
Para web_sales vamos a enriquecer la tabla con date_dim y añadir
sold_year y sold_month. Es una elección docente comprensible porque
permite consultar por tiempo —"ventas de 2001", "ventas de enero de
1999"— sin necesidad de explicar nada más sobre el dominio.
En cambio, ws_bill_customer_sk, ws_item_sk y ws_order_number son
malas columnas de partición principal, y no por casualidad: las tres
identifican entidades con muchísimos valores distintos dentro de
web_sales (clientes, artículos y pedidos), muy por encima del número de
años o meses distintos que aparecen en date_dim. Particionar por una
columna así produciría un directorio por cada cliente, artículo o pedido,
casi todos con uno o muy pocos ficheros diminutos: exactamente el problema
de los "ficheros pequeños" que penaliza tanto a HDFS (metadatos del
NameNode por fichero) como a cualquier motor que después tenga que abrir
todos esos directorios. Comprobaremos estas cardinalidades con datos reales
de SF1 en cuanto carguemos las tablas, en la siguiente sección.
Una clave surrogate de fecha (ws_sold_date_sk) sufre un problema
parecido: es una columna casi tan fina como una fecha exacta, con muchos
más valores distintos que sold_year/sold_month, y además no es
directamente comprensible para quien consulte la tabla —es un entero
sintético del generador TPC-DS, no una fecha legible—. Por eso derivamos
sold_year y sold_month a partir de d_date en lugar de particionar
directamente por la clave surrogate.
Por último, la elección entre particionar sólo por sold_year o por la
pareja sold_year, sold_month debe relacionarse con el tamaño real de los
fragmentos resultantes, no con una preferencia a priori: más niveles de
partición no significan automáticamente más rendimiento, sobre todo si
cada partición mensual termina teniendo un único fichero pequeño. Para
SF1, con unas pocas centenas de miles de líneas de venta repartidas entre
varios años, la pareja sold_year, sold_month sigue produciendo
fragmentos razonables, así que es la que usaremos.
Ejercicio de transformación con Spark
El ejercicio crea una salida nueva a partir de los Parquet de S2, sin tocarlos:
/datalake/raw/tpcds/web_sales
    → /datalake/silver/tpcds/web_sales/sold_year=.../sold_month=.../part-...
El flujo, celda a celda, será: leer web_sales y date_dim desde sus
rutas físicas; comprobar con datos reales la cardinalidad de las columnas
que descartamos como partición; unir por ws_sold_date_sk = d_date_sk;
conservar las columnas de negocio necesarias y derivar sold_year y
sold_month; validar filas y claves con assert; escribir la salida
particionada; escribir además una salida de control sin particionar; y
agregar desde silver los pedidos, las líneas y el beneficio por año para
escribir el producto gold.
Leer las tablas fuente
from pyspark.sql.dataframe import DataFrame
from pyspark.sql.functions import col, count, countDistinct
from pyspark.sql.functions import max as spark_max
from pyspark.sql.functions import min as spark_min
from pyspark.sql.functions import month
from pyspark.sql.functions import sum as spark_sum

web_sales_path: str = "/datalake/raw/tpcds/web_sales"
web_sales: DataFrame = spark.read.parquet(web_sales_path)

print(f"Ruta física leída: {web_sales_path}")
web_sales.printSchema()
date_dim_path: str = "/datalake/raw/tpcds/date_dim"
date_dim: DataFrame = spark.read.parquet(date_dim_path)

print(f"Ruta física leída: {date_dim_path}")
date_dim.printSchema()
Comprobar las cardinalidades antes de elegir la partición
Antes de unir nada, confirmamos con datos reales de SF1 la reflexión de la sección anterior: cuántos valores distintos tienen las columnas que descartamos como partición principal.
cardinality_report: DataFrame = web_sales.select(
    countDistinct("ws_order_number").alias("pedidos_distintos"),
    countDistinct("ws_item_sk").alias("articulos_distintos"),
    countDistinct("ws_bill_customer_sk").alias("clientes_distintos"),
)
cardinality_report.show()
Compara esas tres cifras con el número de años y meses distintos que
veremos más abajo tras unir con date_dim (a lo sumo unas pocas decenas de
combinaciones sold_year/sold_month). Cualquiera de las tres columnas
anteriores generaría muchísimos más directorios que la pareja
sold_year/sold_month, la mayoría con muy pocas filas: es precisamente
la razón por la que no las usamos como partición principal.
Unir con date_dim y construir el esquema silver
Unimos por ws_sold_date_sk = d_date_sk, conservamos las columnas de
negocio del contrato y derivamos ws_sold_date (la fecha real, no sólo la
clave surrogate), junto con las particiones sold_year y sold_month.
sold_year viene directamente de date_dim.d_year; sold_month se
calcula con month(d_date), equivalente a usar d_moy de date_dim.
web_sales_silver: DataFrame = web_sales.join(
    date_dim.select("d_date_sk", "d_date", "d_year"),
    on=web_sales["ws_sold_date_sk"] == date_dim["d_date_sk"],
    how="inner",
).select(
    "ws_order_number",
    "ws_item_sk",
    "ws_bill_customer_sk",
    "ws_bill_addr_sk",
    "ws_sold_date_sk",
    col("d_date").alias("ws_sold_date"),
    "ws_quantity",
    "ws_list_price",
    "ws_ext_discount_amt",
    "ws_ext_sales_price",
    "ws_net_paid",
    "ws_net_profit",
    col("d_year").alias("sold_year"),
    month(col("d_date")).alias("sold_month"),
)
web_sales_silver.printSchema()
Validar filas y claves antes de escribir
Un join interno mal planteado puede multiplicar filas (si la clave de la
dimensión no es única) o perder más filas de las esperadas (si aparecen
claves de hecho sin correspondencia en la dimensión). TPC-DS, además,
introduce deliberadamente una pequeña fracción de líneas de venta sin
ws_sold_date_sk —una característica documentada del propio generador,
pensada para simular datos de origen imperfectos, no un error de esta
sesión—: esas líneas no pueden fecharse y un join interno las descarta
igual que descartaría cualquier fila sin pareja en date_dim. Antes de
escribir nada comprobamos que la única pérdida de filas es exactamente esa,
ni una más ni una menos:
raw_count: int = web_sales.count()
silver_count: int = web_sales_silver.count()
missing_date_key_count: int = web_sales.filter(col("ws_sold_date_sk").isNull()).count()

print(f"Filas en la fuente (web_sales): {raw_count}")
print(f"Filas sin ws_sold_date_sk (no se pueden fechar): {missing_date_key_count}")
print(f"Filas tras la unión con date_dim: {silver_count}")

assert raw_count - silver_count == missing_date_key_count, (
    "El join con date_dim sólo debería perder las líneas sin ws_sold_date_sk, "
    "ninguna otra: "
    f"raw={raw_count} silver={silver_count} sin_fecha={missing_date_key_count}"
)
Después comprobamos que la clave de unión y la fecha derivada no aparecen
inesperadamente nulas, algo que sí podría ocurrir con un left_outer pero
que un inner bien planteado no debería dejar pasar:
null_join_keys: int = web_sales_silver.filter(
    col("ws_sold_date_sk").isNull() | col("ws_sold_date").isNull()
).count()

print(f"Líneas con clave de unión o fecha derivada nula: {null_join_keys}")

assert null_join_keys == 0, (
    "No debería haber claves de unión nulas tras un join interno: "
    f"{null_join_keys} filas afectadas"
)
Por último, comprobamos que los rangos de las columnas de partición tienen
sentido: sold_month debe estar siempre entre 1 y 12, y el rango de años
debe corresponder a fechas de venta reales, no a valores fuera de escala.
from pyspark.sql import Row

year_month_bounds: Row | None = web_sales_silver.select(
    spark_min("sold_year").alias("min_year"),
    spark_max("sold_year").alias("max_year"),
    spark_min("sold_month").alias("min_month"),
    spark_max("sold_month").alias("max_month"),
).first()

print(year_month_bounds)

assert (
    year_month_bounds["min_month"] >= 1 and year_month_bounds["max_month"] <= 12
), f"sold_month debe estar en el rango 1-12: {year_month_bounds}"

# Las cifras que la sección anterior prometía comparar con las
# cardinalidades descartadas como partición principal.
year_month_combinations: int = web_sales_silver.select("sold_year", "sold_month").distinct().count()
print(f"Combinaciones distintas de sold_year/sold_month: {year_month_combinations}")
Escribir la salida silver particionada
Antes de escribir, reagrupamos las filas por las columnas de partición con
repartition("sold_year", "sold_month"): así cada partición Hive de salida
tiende a corresponder a un número pequeño de particiones de ejecución de
Spark, en lugar de que cada tarea escriba un fragmento en casi todos los
directorios. Es la misma lección de "ficheros pequeños" de S4, aplicada
ahora a una escritura particionada. mode("overwrite") hace la escritura
idempotente: volver a ejecutar esta celda reconstruye la tabla desde cero
en lugar de acumular ficheros duplicados.
silver_path: str = "/datalake/silver/tpcds/web_sales"

(
    web_sales_silver.repartition("sold_year", "sold_month")
    .write.mode("overwrite")
    .partitionBy("sold_year", "sold_month")
    .parquet(silver_path)
)

print(f"Escrito: {silver_path}")
Escribir una salida de control sin particionar
Para poder comparar honestamente "qué aporta particionar" necesitamos una
versión de referencia con exactamente las mismas filas y columnas, pero
escrita en un único directorio sin subdirectorios columna=valor. Esta
salida es únicamente un artefacto de laboratorio para la comparación de
esta sesión: a diferencia de /datalake/silver/tpcds/web_sales, no forma
parte del contrato que usarán S6, S7 o S8, así que la dejamos bajo la
ruta de trabajo personal /user/luser/s5, no bajo /datalake.
!hdfs dfs -mkdir -p /user/luser/s5
silver_control_path: str = "/user/luser/s5/web_sales_silver_sin_particionar"

web_sales_silver.write.mode("overwrite").parquet(silver_control_path)

print(f"Escrito (control, sin particionar): {silver_control_path}")
Agregar el producto gold
El producto gold responde a una pregunta de negocio concreta —"pedidos,
líneas de venta y beneficio neto por año"— y se calcula agregando desde
silver, no releyendo raw: la celda lee la tabla que acabamos de escribir
en silver_path y agrupa por sold_year, una columna que Spark reconstruye
a partir de los nombres de directorio (lo veremos con detalle al releer la
tabla, más abajo). Mantenemos la misma disciplina de métricas
que en S2: count(DISTINCT ws_order_number) cuenta pedidos, count(*)
cuenta líneas de venta, y ambas cifras se muestran por separado para que no
se confundan.
web_sales_silver_written: DataFrame = spark.read.parquet(silver_path)

web_sales_by_year: DataFrame = (
    web_sales_silver_written.groupBy("sold_year")
    .agg(
        countDistinct("ws_order_number").alias("pedidos"),
        count("*").alias("lineas_de_venta"),
        spark_sum("ws_net_profit").alias("beneficio_neto"),
    )
    .withColumnRenamed("sold_year", "d_year")
    .orderBy("d_year")
)

web_sales_by_year.printSchema()
web_sales_by_year.show()
El producto gold es pequeño (una fila por año) y no necesita particionado
físico: lo escribimos como un único fichero Parquet con coalesce(1), la
misma técnica de consolidación que usamos en S4 para evitar múltiples
ficheros diminutos.
gold_path: str = "/datalake/gold/tpcds/web_sales_by_year"

web_sales_by_year.coalesce(1).write.mode("overwrite").parquet(gold_path)

print(f"Escrito: {gold_path}")
Releer la tabla silver desde la ruta raíz
Cerramos el ciclo de escritura releyendo /datalake/silver/tpcds/web_sales
exactamente igual que leeríamos cualquier otro Parquet: por su ruta raíz,
sin mencionar los subdirectorios de partición en ningún sitio.
web_sales_silver_read_back: DataFrame = spark.read.parquet(silver_path)

web_sales_silver_read_back.printSchema()
sold_year y sold_month aparecen en el esquema como columnas normales
del DataFrame, aunque ningún fichero Parquet las contenga físicamente:
Spark las ha descubierto a partir de los nombres de directorio
sold_year=.../sold_month=... durante el listado de la ruta. Esto ocurre
sin ningún Hive Metastore de por medio; es exactamente el "descubrimiento
por convención de directorios" que describimos en la sección "Qué
significa particionar". En S6 este mismo descubrimiento pasará a estar
centralizado en un catálogo, en lugar de depender de que cada motor liste
la ruta por su cuenta.
Comparar una lectura completa con una lectura filtrada
El tiempo total de una consulta SF1 en un portátil, dentro de un contenedor, no es una evidencia fiable de que el particionado ayuda: depende de cachés del sistema operativo, de la carga del equipo, de Docker y de cuántas veces se haya ejecutado ya la misma consulta antes. Lo que sí podemos observar de forma reproducible es el plan físico de la consulta y el número de ficheros que Spark decide abrir antes de leer una sola fila. Eso es lo que vamos a comparar, no un cronómetro.
Primero elegimos, con datos reales, un año sobre el que filtrar: el que
tenga más líneas de venta en la tabla silver.
year_counts: DataFrame = (
    web_sales_silver_read_back.groupBy("sold_year")
    .count()
    .orderBy(col("count").desc(), col("sold_year"))
)
year_counts.show()

sample_year: int = year_counts.first()["sold_year"]
print(f"Año elegido para el filtro: {sample_year}")
full_scan: DataFrame = web_sales_silver_read_back
filtered: DataFrame = web_sales_silver_read_back.filter(col("sold_year") == sample_year)
Plan físico de la lectura completa
full_scan.explain("formatted")
Plan físico de la lectura filtrada
Busca en el bloque Scan parquet una sección PartitionFilters: si
aparece con la condición sold_year = <año elegido>, significa que Spark
ha aplicado el filtro antes de decidir qué directorios listar, no
después de leer todas las filas.
filtered.explain("formatted")
Ficheros efectivamente leídos
explain() dice qué decide Spark; para ver qué ha leído hay que
ejecutar las dos consultas y mirar sus métricas. La celda siguiente lanza
una acción sobre cada una.
full_scan_rows: int = full_scan.count()
filtered_rows: int = filtered.count()

print(f"Filas de la lectura completa: {full_scan_rows}")
print(f"Filas de la lectura filtrada (sold_year = {sample_year}): {filtered_rows}")

assert filtered_rows < full_scan_rows
Abre la pestaña SQL / DataFrame de http://localhost:4040 —la
interfaz web de Spark presentada en S4— y entra en las dos últimas
consultas. En el nodo Scan parquet de cada una aparecen, entre otras, las
métricas number of files read, size of files read y number of
partitions read: en la lectura filtrada deben ser una fracción de las de
la lectura completa. Esa es la medida directa de la poda.
Como comprobación independiente, contamos también los ficheros que existen
en HDFS bajo cada ruta: los de la partición del año elegido deberían
coincidir con el number of files read de la consulta filtrada.
DataFrame.inputFiles() no sirve para esto: en una relación basada en ruta
(sin catálogo) devuelve siempre la lista completa de ficheros de la tabla,
aunque el plan aplique PartitionFilters.
import subprocess


def hdfs_file_count(path: str) -> int:
    output: str = subprocess.run(
        ["hdfs", "dfs", "-count", path], check=True, capture_output=True, text=True
    ).stdout
    return int(output.split()[1])


full_scan_files: int = hdfs_file_count(silver_path) - 1  # descarta _SUCCESS
filtered_files: int = hdfs_file_count(f"{silver_path}/sold_year={sample_year}")

print(f"Ficheros bajo la ruta completa: {full_scan_files}")
print(f"Ficheros bajo sold_year={sample_year}: {filtered_files}")

assert filtered_files < full_scan_files, (
    "La partición de un solo año debería tener estrictamente menos ficheros que "
    f"la tabla completa: completa={full_scan_files} filtrada={filtered_files}"
)
print(f"Ficheros descartados por la poda de particiones: {full_scan_files - filtered_files}")
sample_year es el año con más líneas de los que hay en SF1 (unos pocos
años en total), así que su partición es sólo una fracción del total:
filtered_files debe ser estrictamente menor que full_scan_files, y
debería coincidir con lo que mostró la interfaz de Spark para la consulta
filtrada. Esa diferencia de ficheros —no el tiempo que ha tardado la
celda— es la evidencia que vamos a citar en la tabla comparativa de más
abajo.
No volveremos a usar la SparkSession: el resto de la sesión sólo
mira la estructura de directorios con hdfs dfs. La cerramos aquí, como
hace S4 antes de cambiar de sección.
spark.stop()
Comprobar la estructura de directorios en HDFS
Por último, miramos directamente en HDFS la estructura columna=valor que
Spark ha creado, y la comparamos con la de la salida de control sin
particionar y con la del producto gold.
!hdfs dfs -ls {silver_path}
hdfs dfs -ls sólo enumera un nivel de directorios. Para contar de
verdad cuántos ficheros ha escrito Spark en total bajo todas las
combinaciones sold_year/sold_month, hdfs dfs -count recorre el árbol
completo y devuelve, en este orden, el número de directorios, el número de
ficheros y el tamaño lógico total:
!hdfs dfs -count -h {silver_path}
Cada entrada sold_year=<año> es un directorio, no un fichero de datos.
Bajamos un nivel más para ver los subdirectorios mensuales del año elegido
antes:
!hdfs dfs -ls {silver_path}/sold_year={sample_year}
Compara esa estructura con la salida de control, que no tiene ningún
subdirectorio columna=valor: todos los fragmentos Parquet cuelgan
directamente de la ruta:
!hdfs dfs -ls {silver_control_path}
Y con el producto gold, que al llevar coalesce(1) debería mostrar un
único fichero de datos junto al marcador _SUCCESS:
!hdfs dfs -ls {gold_path}
Tabla comparativa: fuente, refinada y gold
Con lo observado en las celdas anteriores se pueden comparar las tres versiones del dato que anunciaba la introducción —más la salida de control—, con evidencia concreta de esta ejecución en lugar de con texto genérico:
| Versión | Organización | Filas | Lo que aporta / responde |
|---|---|---|---|
Fuente (raw) |
/datalake/raw/tpcds/web_sales, un directorio sin particionar |
raw_count filas (719.384 en SF1) |
Qué datos existen físicamente; es la referencia inmutable frente a la que se valida todo lo demás |
| Refinada sin particionar | /user/luser/s5/web_sales_silver_sin_particionar, un directorio, mismas filas que la fuente tras el join |
silver_count filas: raw_count menos missing_date_key_count (comprobado con assert), no raw_count exacto |
Qué aporta la transformación por sí sola: columnas de negocio limpias, ws_sold_date derivada, líneas sin fecha ya descartadas de forma documentada, sin reorganización física todavía |
| Refinada particionada | /datalake/silver/tpcds/web_sales/sold_year=.../sold_month=..., un subdirectorio por combinación año/mes |
Las mismas filas que la versión sin particionar, repartidas entre directorios (ver year_counts más arriba) |
Qué datos puede evitar leer un filtro: compara full_scan_files con filtered_files — si el segundo es menor, la poda de particiones ha descartado directorios completos |
| Gold | /datalake/gold/tpcds/web_sales_by_year, un único fichero |
Una fila por año distinto de sold_year |
Qué producto consume directamente una pregunta de negocio (pedidos, líneas y beneficio neto por año), sin que quien lo consulte tenga que repetir el join con date_dim |
Las columnas "Filas" de esta tabla no son números fijos de esta plantilla:
son los valores impresos por raw_count, silver_count,
missing_date_key_count, year_counts, full_scan_files y
filtered_files en las celdas de arriba, en esta misma ejecución del
notebook. Vuelve a mirarlos si repites la sesión más adelante.
Buenas prácticas que quedan pendientes del catálogo
Aunque /datalake/silver/tpcds/web_sales y
/datalake/gold/tpcds/web_sales_by_year ya siguen convenciones razonables
de organización, siguen siendo colecciones de Parquet sobre HDFS, no tablas
gestionadas. Eso deja límites concretos que S5 no resuelve:
- el nombre lógico de la tabla (
web_sales, ensilver) no está centralizado en ningún sitio: cada motor que quiera leerla necesita conocer la ruta física exacta, como hemos hecho aquí a mano; - los motores deben conocer esa ubicación física de antemano; no hay un
servicio al que preguntar "¿dónde está la tabla
web_salesdesilver?"; - una partición nueva —por ejemplo, si llegaran ventas de un año posterior— puede escribirse en el directorio correcto y, aun así, no estar "registrada" para un cliente que dependa de una lista de particiones cacheada o de un catálogo (como el Hive Metastore de S6): quien descubre la tabla por rutas, como hace este mismo notebook al leer desde la raíz, sí vería la partición nueva de inmediato;
- no hay un historial de cambios de la tabla: si alguien vuelve a ejecutar
esta sesión con otra lógica de transformación, la versión anterior
simplemente desaparece con el
overwrite, sin dejar rastro de qué había antes; - no existe un commit atómico de todos los ficheros de una escritura: si el proceso se interrumpiera a mitad de la escritura particionada, un lector podría ver una tabla a medio escribir;
- las actualizaciones y eliminaciones de filas concretas requerirían coordinación manual entre quien escribe y quien lee, porque no hay transacciones;
- los metadatos y las estadísticas (número de filas por partición, rangos de columnas...) no tienen todavía una política común: cada motor que lea esta tabla tendría que recalcularlas por su cuenta.
Estas limitaciones no hacen que el data lake construido en esta sesión
sea incorrecto: son exactamente los problemas que resolverán el Hive
Metastore en S6 y el formato de tabla Iceberg en S7, y conviene haberlos
sentido de primera mano —intentando, por ejemplo, acordarse a mano de la
ruta física de web_sales— antes de ver cómo un catálogo los resuelve.
Relación con HDFS y S3
La organización columna=valor que hemos aplicado en esta sesión puede
utilizarse tanto en HDFS como en un almacenamiento de objetos compatible
con S3, como el que se introdujo en la sesión 3. Sin embargo, un
almacenamiento de objetos no tiene directorios reales: lo que aquí llamamos "directorio" es, en un backend
S3, una convención sobre el prefijo de las claves de objeto. Conviene
mantener separadas tres ideas que es fácil mezclar:
- la semántica del formato Parquet y del particionado por directorios, que es la misma en ambos casos;
- las operaciones concretas de HDFS (
hdfs dfs -ls, bloques, el NameNode) o de la API S3 (listar por prefijo, objetos), que son mecanismos distintos para conseguir el mismo efecto observable; - la gestión de catálogo que se incorporará después, en S6 y S7, y que es independiente del almacenamiento subyacente.
La sesión 3 ya mostró que el mismo Parquet puede copiarse a un almacenamiento S3-compatible sin modificar su esquema. S5 continúa ese recorrido centrándose en la organización física y el particionado de los ficheros, no en dónde viven los bytes.
Preguntas para interpretar la experiencia
- ¿Por qué conservar
/datalake/raw/tpcdssin modificar facilita comparar esta sesión con las anteriores, incluso si cambiamos por completo la lógica de la transformaciónsilver? - Da un ejemplo, con tus propias palabras, de la diferencia entre una partición de ejecución de Spark y una partición Hive como las que hemos creado aquí. ¿Podrías tener muchas particiones de ejecución sobre una tabla con una única partición Hive, o al revés?
- ¿Por qué
ws_bill_customer_sksería una mala columna de partición principal paraweb_sales, aunque aparezca muy a menudo en los filtros de negocio (por ejemplo, "ventas de un cliente concreto")? - En la comparación de planes, ¿qué diferencia concreta viste entre el plan
de la lectura completa y el de la lectura filtrada? ¿Coincidió con la
diferencia de ficheros contados en HDFS? ¿Por qué
inputFiles()no sirve para medir esto? - ¿Por qué el enunciado insiste en que el tiempo de ejecución de una celda en un portátil no demuestra, por sí solo, que el particionado ayuda? ¿Qué evidencia usaste en su lugar?
- La salida de control sin particionar vive en
/user/luser/s5, no en/datalake/silver. ¿Por qué tiene sentido esa distinción de rutas para un artefacto que sólo sirve para esta comparación? - Explica, sin usar la palabra "particionar", qué comprueban los
assertde esta sesión y por qué cada uno detecta un problema distinto (filas perdidas o duplicadas frente a claves nulas). - De la lista de límites pendientes del catálogo, elige uno y describe con un ejemplo concreto de esta sesión en qué momento lo has notado.
Evidencias para la siguiente sesión
Antes de la siguiente sesión tendrás una reunión individual breve con el profesor para revisar el trabajo de esta sesión. Esa reunión combina una demostración en vivo sobre tu propio ordenador y una memoria escrita breve.
Qué mostrar en el ordenador durante la reunión
Ten preparadas estas evidencias:
- La ruta fuente inmutable (
/datalake/raw/tpcds/web_sales) y su número de filas, sin modificar. - La ruta refinada
/datalake/silver/tpcds/web_sales, con su esquema (printSchema) y la definición de sus particiones (sold_year,sold_month). - El producto
gold/datalake/gold/tpcds/web_sales_by_year, derivado desilver, con su contenido (show()). - La comprobación de filas y claves: el resultado de los
assertde esta sesión, junto con los valores que compararon (raw_count,silver_count,missing_date_key_count,null_join_keys). - El listado
hdfs dfs -lsde al menos un nivel de directorioscolumna=valorde la tabla particionada. - La comparación entre la consulta completa y la consulta filtrada: los
dos planes de
.explain("formatted")(con susPartitionFilters), los ficheros leídos por cada consulta según la interfaz de Spark y los dos recuentos de ficheros en HDFS (full_scan_files,filtered_files). - Una explicación, con tus propias palabras, de por qué
sold_year/sold_monthes una partición útil paraweb_salesy por quéws_order_number,ws_item_skows_bill_customer_skno lo serían.
Las evidencias que salen de Spark (esquemas, planes y recuentos) necesitan
una SparkSession viva: como el notebook la cierra con spark.stop(), para
enseñarlas en la reunión hay que volver a ejecutar las celdas desde «Crear
una SparkSession local».
Memoria escrita (una o dos páginas)
Trae también un documento breve —una o dos páginas, no hace falta más— que
no se limite a pegar capturas de las salidas anteriores: debe explicar con
tus propias palabras qué garantiza cada zona del data lake (raw, silver
y gold); qué dice el contrato de las dos salidas de esta sesión; por qué
sold_year y sold_month son una buena partición y una clave de cliente,
de artículo o de pedido no lo sería; qué evidencia demuestra que el filtro
evita leer ficheros; y qué sigue sin resolver una colección de Parquet bien
organizada pero sin catálogo.
Qué es importante de cara al examen final
El examen no pide recordar la sintaxis exacta de una función. Debes poder explicar:
- la arquitectura medallion y qué se espera de los datos en cada zona;
- qué debe decir el contrato de una salida de datos: ruta, columnas, claves de unión, significado de cada métrica, formato y regla de regeneración;
- qué es el particionado físico por directorios
columna=valory en qué se distingue de una partición de ejecución de Spark, de un bloque HDFS y de una transformación de partición de Iceberg; - con qué criterios se elige una columna de partición: filtros habituales, cardinalidad y tamaño de los ficheros resultantes;
- qué comprobaciones de calidad conviene hacer tras una unión (filas perdidas o duplicadas, claves nulas, rangos) y qué detecta cada una;
- cómo se reconoce la poda de particiones en un plan y por qué el tiempo de una celda no es una evidencia fiable;
- qué limitaciones tiene un data lake de ficheros sin catálogo.
Siguiente paso
S5 deja preparados los tres niveles del recorrido medallion: una fuente
inmutable, una tabla silver particionada físicamente y un producto gold
derivado de ella. S6 registrará las rutas silver y gold como tablas
externas Hive, mostrará las particiones desde un metastore y permitirá que
Spark y Trino consulten la misma definición de tabla sin que cada motor
tenga que conocer de antemano la ruta física ni volver a listar los
directorios por su cuenta.