Sesión 4 — Spark como motor de procesamiento distribuido
Esta sesión es el siguiente paso después de S1, S2 y S3. En S1 se estudiaron HDFS, YARN y MapReduce; en S2 se exploraron los Parquet de TPC-DS SF1 como ficheros, sin catálogo; en S3 se comprobó que esos mismos Parquet pueden vivir en un almacenamiento compatible con S3. Ahora se incorpora un motor de procesamiento distribuido capaz de leer esos ficheros y ejecutar el trabajo sobre los DataNodes a través de YARN.
La pregunta central de esta sesión es:
¿Cómo pasa una aplicación Python de leer datos desde una ruta a construir y ejecutar un trabajo distribuido sobre los DataNodes?
Spark no se presentará todavía como un sistema de catálogo ni como una solución de lakehouse. En esta primera etapa es un motor que lee y escribe datos estructurados y que puede ejecutarse localmente o sobre YARN. El recorrido completo hasta este punto es:
S1: HDFS, YARN y MapReduce
  → S2: Parquet en /datalake/raw/tpcds, sin catálogo permanente
  → S3: Parquet sobre un almacenamiento S3-compatible
  → S4: Spark procesa los Parquet y utiliza YARN
Los datos de entrada siguen siendo los de TPC-DS SF1. Se conserva el
materializado original de /datalake/raw/tpcds y se evita modificarlo
durante los ejercicios: las transformaciones de Spark escribirán sus
salidas en rutas de trabajo separadas, bajo /user/luser/s4.
Paquetes de Python de esta sesión. Esta sesión necesita
pyspark. Respecto a S3 añadepyspark. Se instalan en el kernel denamenodeen la sección «Instalar PySpark en este notebook»: una celda%%writefile requirements.txtcrea el fichero dentro del contenedor —elrequirements.txtde tu copia des4/está en tu equipo ynamenodeno lo ve— y otra ejecuta%pip install -r requirements.txt. La imagen denamenodeya trae estos paquetes en su entorno Python del curso,/opt/tcdm/venv, que es el intérprete del kernel y donde instala%pip; lo normal es que%pipsólo confirme que están; ejecuta esas celdas de todos modos: dejan explícito qué necesita la sesión y reparan el entorno si falta algo.
Diapositivas de la sesión
Las diapositivas se generan con el paquete jupyter-notebook-slide.
El alias %%diapositiva permite mantener en español los tipos usados en la sesión y produce la misma salida HTML en Jupyter, Colab y la referencia HTML publicada.
En cada sesión encontrarás varios tipos de diapositivas que te ayudarán a seguir el hilo:
- Sección (
titulo): abre la sesión y resume qué vamos a ver y qué haremos. - A continuación (
avance): anuncia el contenido de la parte siguiente, para saber en qué punto del programa estamos. - Recapitulación (
resumen): condensa la parte anterior en puntos clave para recordarlos y revisarlos después. - Pregunta guía (
pregunta): plantea cuestiones que orientan lo que viene a continuación; conviene intentar responderlas antes de seguir. - Evaluación de la sesión (
evaluacion): recuerda cómo se evalúa el trabajo de esta sesión.
%pip install -q "jupyter-notebook-slide @ git+https://github.com/dsevilla/jupyter-notebook-slide.git"
%load_ext notebook_slide

import notebook_slide as jnbs

# Colores de 26-27/teoria/tcdm.css, adaptados al tema de las sesiones.
jnbs.configure(
    background="#eaf2f8",
    foreground="#1f2933",
    border="#c9d6e1",
    heading="#0c304d",
    subheading="#0c304d",
    link="#174f7a",
    code_background="#eaf2f8",
    code_foreground="#0c304d",
    quote_background="#ffffff",
    font_family="Atkinson Hyperlegible, Inter, Aptos, Segoe UI, Helvetica, Arial, sans-serif",
    font_url="https://fonts.googleapis.com/css2?family=Atkinson+Hyperlegible:ital,wght@0,400;0,700;1,400;1,700&display=swap",
)
jnbs.register_slide_type("avance", "A continuación", "#174f7a")
jnbs.register_slide_type("resumen", "Recapitulación", "#a54467")
jnbs.register_slide_type("pregunta", "Pregunta guía", "#0c304d")
jnbs.register_slide_type("evaluacion", "Evaluación de la sesión", "#b3701a")
jnbs.register_slide_type(
    "titulo",
    "Sección",
    "#174f7a",
    layout="title",
    background="linear-gradient(135deg, #0c304d, #174f7a 62%, #a54467)",
    foreground="#ffffff",
    border="transparent",
    heading="#ffffff",
    subheading="#dceaf4",
)
jnbs.register_alias("diapositiva")
Capas que se deben distinguir
En esta sesión aparecen varias palabras que se reutilizarán más adelante y que conviene separar desde el principio:
| Concepto | Significado en esta sesión |
|---|---|
| HDFS o S3 | Sistema de almacenamiento que contiene los datos |
| Parquet | Formato columnar de los ficheros |
| Spark | Motor que construye y ejecuta el procesamiento |
| YARN | Gestor que asigna recursos a la aplicación Spark |
| Partición de Spark | Parte lógica del trabajo que puede ejecutar una tarea |
| Partición Hive | Organización física de datos por valores de columnas; se verá en S5 |
| Catálogo | Servicio que da nombres y metadatos a las tablas; se verá en S6 y S7 |
Una partición de ejecución de Spark no es un directorio de partición Hive. Tampoco es un bloque HDFS ni un fichero Parquet. Que compartan el nombre no significa que sean la misma unidad; a lo largo de esta sesión se insistirá varias veces en esa distinción.
Objetivos de la sesión
Al terminar esta sesión deberías poder:
- crear una
SparkSessiony ejecutar una aplicación PySpark; - leer Parquet desde una ruta HDFS y examinar su esquema;
- construir DataFrames con
select,filter,withColumn,joinygroupBy; - distinguir transformaciones de acciones;
- explicar que Spark construye un plan antes de ejecutar el trabajo;
- observar el plan lógico y físico con
explain; - diferenciar el driver, los ejecutores y el gestor de recursos;
- comparar los modos
localyyarn; - comprender qué son las particiones de ejecución de Spark;
- comprobar qué ejecutores remotos y qué DataNodes realizan trabajo;
- escribir resultados Parquet sin confundir todavía una salida de Spark con una tabla registrada;
- utilizar vistas temporales para introducir Spark SQL sin un catálogo permanente;
- conservar consultas reproducibles y explicar la métrica que calcula cada ejemplo (líneas de venta frente a pedidos distintos, por ejemplo).
Antes de empezar
Dónde se ejecuta este notebook. Igual que en S2 y S3, Jupyter se ejecuta directamente dentro del contenedor
namenode, comoluser, con acceso de red directo a HDFS y YARN. Las celdas ejecutables hablan directamente con el clúster. Las órdenes que necesitan el Docker del host — arrancar o detener contenedores,make— se muestran como texto para ejecutarlas en una terminal de tu equipo, nunca como celdas de este notebook.
Esta sesión asume que el clúster de S1 ya está en marcha y que S2 generó
los Parquet de TPC-DS SF1 en /datalake/raw/tpcds. Si no es así, desde una
terminal de tu equipo situada en la raíz de la distribución de sesiones:
cd ~/tcdm-public
git pull
make -C entorno warehouse-up
Este notebook se ejecuta en el Jupyter de namenode, que no arranca solo.
Como en S2, arráncalo desde otra terminal de tu equipo y déjala abierta
mientras trabajes:
# en tu equipo: entra en namenode
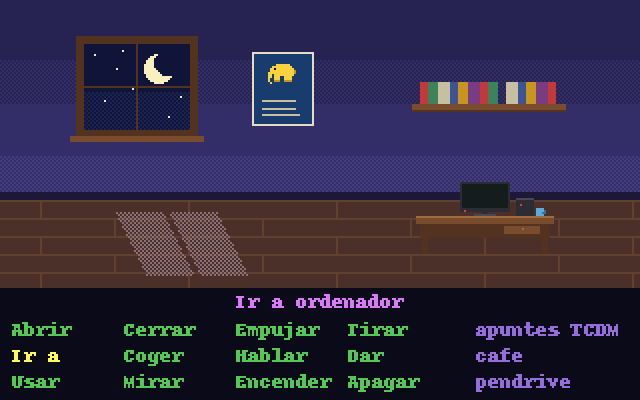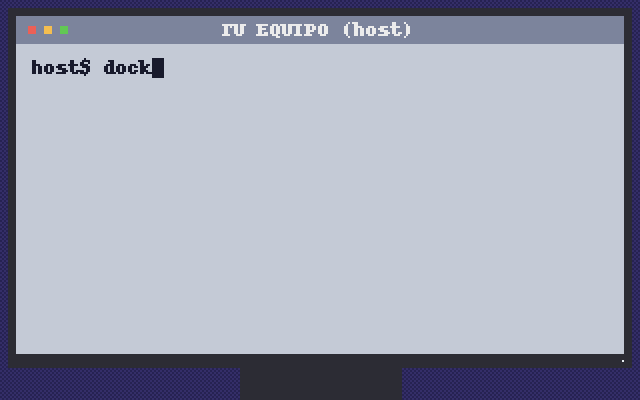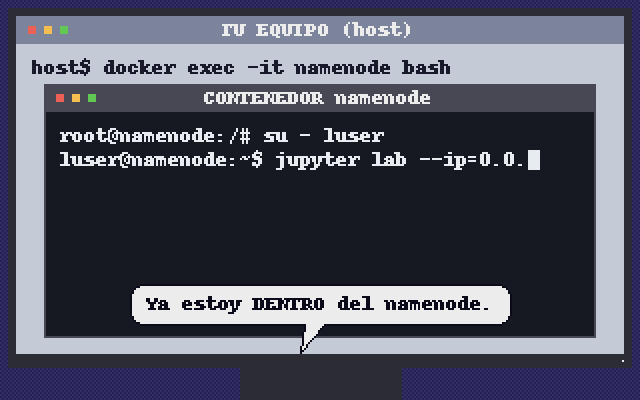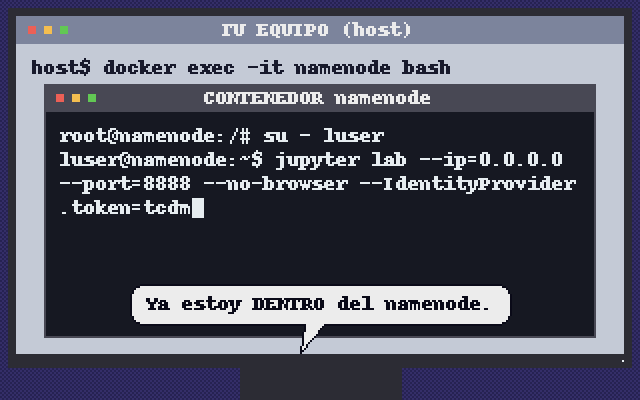
docker exec -it namenode bash
# ya dentro de namenode, como luser: Jupyter con el token fijo «tcdm»
su - luser
jupyter lab --ip=0.0.0.0 --port=8888 --no-browser --IdentityProvider.token=tcdm
La primera orden es la única que se ejecuta en tu equipo; las otras dos, ya
dentro del contenedor, arrancan Jupyter con el Python del curso
(make -C entorno jupyter hace lo mismo en una sola orden). En Visual
Studio Code, conecta este notebook con Select Kernel → Select Another
Kernel → Existing Jupyter Server, usando la dirección
http://127.0.0.1:8888/lab?token=tcdm y eligiendo el kernel Python 3
(ipykernel). El token es siempre tcdm.
Si algo no funciona —el notebook no conecta, una celda !hdfs no
encuentra la orden, un servicio no responde—, consulta «Solución de
problemas» en entorno/README.md.
Antes de instalar nada, comprueba que los datos de entrada siguen donde S2 los dejó:
!hdfs dfs -ls -d /datalake/raw/tpcds
Si el directorio no existe, revisa S2 antes de continuar: esta sesión no regenera TPC-DS.
El progreso y los planes se observan con .show(), .explain() y la CLI
de yarn. El ResourceManager (:8088) y el
Timeline Server (:8188), ya conocidos desde S1, siguen disponibles para
mirar el estado de las aplicaciones YARN en el navegador. A ellos se suma
la interfaz web del propio Spark (:4040), que se presenta en cuanto exista
la SparkSession.
Instalar PySpark en este notebook
El kernel de este notebook instalará PySpark directamente sobre sí mismo,
igual que S2 y S3 instalaron PyArrow, Polars o DuckDB. Esta instalación es
la que usaremos para todos los ejemplos en modo local del notebook: una
única SparkSession construida más abajo y reutilizada en la mayoría de
las secciones. La sección "Driver, ejecutores y YARN" no reutiliza esa
SparkSession, porque no se puede cambiar el master de una sesión ya
construida: lanza un proceso aparte con spark-submit, pero con este mismo
PySpark del entorno /opt/tcdm/venv.
La celda siguiente crea requirements.txt con %%writefile dentro de
namenode —el de tu copia de la distribución está en tu equipo y el kernel no
lo ve— y la posterior lo instala con %pip en el intérprete del kernel. La
imagen de namenode ya trae PySpark, así que lo normal es que %pip sólo
confirme que está.
%%writefile requirements.txt
# Dependencias del kernel interactivo de la sesión 4 (Spark en modo local).
# La serie de PySpark aceptada por el curso es >4,<4.2.
# El envío a YARN de la sección "Driver, ejecutores y YARN" usa este mismo
# PySpark (spark-submit de /opt/tcdm/venv).
pyspark>4,<4.2
%pip install -q -r requirements.txt
import sys

import pyspark

print(f"PySpark {pyspark.__version__} con Python {sys.version.split()[0]}.")
El motor Spark
Apache Spark nació en 2009 en el AMPLab de UC Berkeley, motivado por lo costoso que resultaba encadenar trabajos iterativos con el modelo MapReduce que ya conoces de S1: cada paso de un pipeline MapReduce vuelve a leer y escribir HDFS, aunque los datos quepan en memoria. Se hizo open source en 2010 y pasó a la Apache Software Foundation en 2013. Spark generaliza el modelo de MapReduce: sigue dividiendo el trabajo en tareas sobre particiones de datos, pero encadena esas tareas en un grafo de ejecución y puede mantener resultados intermedios en memoria entre una etapa y la siguiente, en lugar de pasar obligatoriamente por HDFS entre cada paso.
Spark ofrece varios módulos sobre un mismo motor central: SQL/DataFrames, streaming estructurado, una biblioteca de aprendizaje automático (MLlib) y procesamiento de grafos. Esta sesión se queda únicamente en SQL/DataFrames, que es el módulo relevante para un data lake de ficheros Parquet.
API estructurada frente a RDDs
Spark ofrece dos niveles de API:
- la API estructurada (DataFrames y, en Scala/Java, Datasets tipados), que describe qué se quiere calcular sobre columnas con nombre y deja que el optimizador Catalyst y el motor de ejecución Tungsten decidan cómo ejecutarlo;
- la API de bajo nivel (RDDs, Resilient Distributed Datasets), la interfaz original de Spark 1.x: colecciones distribuidas de objetos Python arbitrarios, sin optimizador de por medio.
Los RDDs siguen existiendo y en algún punto muy concreto de esta sesión
—al final, en la sección sobre YARN— se usará uno para hacer visible en qué
host se ha ejecutado cada tarea, porque es la única forma directa de leer
socket.gethostname() dentro de cada partición. Fuera de ese caso muy
puntual, todo el notebook usa exclusivamente DataFrames: es la API
recomendada, tanto por rendimiento (Catalyst puede reordenar y podar
operaciones que RDDs ejecutaría literalmente) como por expresividad
(select, filter, groupBy, join, SQL).
Driver, ejecutores y gestor de recursos
Tres papeles se repiten en cualquier ejecución de Spark, en modo local o sobre YARN:
- el driver crea la
SparkSession, construye el plan lógico y físico de cada consulta y coordina la ejecución; - los ejecutores son los procesos que ejecutan las tareas sobre las particiones de datos y pueden mantener resultados en memoria;
- el gestor de recursos decide dónde se ejecutan el driver y los
ejecutores. En modo
local[N]ese gestor no existe realmente: todo vive en un único proceso JVM conNhilos simulando ejecutores. Sobre YARN, el gestor de recursos es el mismo ResourceManager que ya conoces de S1: el driver pide un ApplicationMaster y unos contenedores de ejecutor, y los NodeManagers de los DataNodes los conceden.
Términos que reaparecerán en los planes de ejecución
- Job: conjunto de stages que dispara una acción.
- Stage: grupo de tareas que se pueden ejecutar sin necesidad de redistribuir datos entre ellas (sin shuffle).
- Task: unidad de trabajo sobre una única partición.
- Partición: la porción de un DataFrame que procesa una tarea.
- Dependencia estrecha (narrow): cada partición de salida depende de
una única partición de entrada (
select,filter,withColumn). - Dependencia ancha (wide): una partición de salida depende de varias
particiones de entrada, lo que obliga a un shuffle (
groupBy,orderBy,joinsinbroadcast,distinct).
Crear una SparkSession local
Construimos una única SparkSession en modo local[2]: dos hilos que
simulan dos ejecutores dentro del mismo proceso Python/JVM del kernel. Esta
sesión es la que reutilizaremos en casi todas las secciones siguientes.
La memoria del driver se deja deliberadamente modesta. Esta JVM comparte el
contenedor namenode con el propio NameNode, el ResourceManager, el
Timeline Server y el kernel de Jupyter (recuerda la tabla de límites de S1:
2 vCPU y 4096 MiB para todo el contenedor). Pedir varios gigabytes de
memoria del driver aquí dejaría sin margen a los demonios de Hadoop; para
los volúmenes de SF1 que leeremos con select/filter/agregaciones no hace
falta.
from pyspark import SparkContext
from pyspark.sql import SparkSession

spark: SparkSession = (
    SparkSession.builder.appName("TCDM_S4_Local")
    .master("local[2]")
    .config("spark.driver.memory", "1g")
    .config("spark.sql.shuffle.partitions", "8")
    .getOrCreate()
)
sc: SparkContext = spark.sparkContext

print(f"Spark version: {spark.version} | Master: {sc.master} | App: {sc.appName}")
spark.sql.shuffle.partitions controla cuántas particiones produce Spark
tras una operación wide (por ejemplo, un groupBy). El valor por defecto
es 200, pensado para clústeres grandes; lo bajamos a 8 porque en local[2],
con los volúmenes de SF1, 200 particiones diminutas sólo añadirían
coordinación sin paralelismo real. Volveremos sobre este parámetro más
adelante, en la sección dedicada a la configuración del shuffle.
La interfaz web de Spark
Mientras exista una SparkSession, su driver sirve una interfaz web en el
puerto 4040. El driver de esta sesión vive en namenode, y
compose-hadoop-cluster.yml publica ese puerto en tu equipo: ábrela en
http://localhost:4040 y déjala en una pestaña del navegador durante toda
la sesión. Se actualiza con cada acción que ejecutes y sigue disponible,
con todo lo ejecutado hasta entonces, hasta que se llame a spark.stop().
| Pestaña | Qué muestra | Para qué sirve en esta sesión |
|---|---|---|
| Jobs | Un job por cada acción (show, count, una escritura…), con su estado, su duración y una línea de tiempo |
Comprobar que una transformación no lanza nada y que una acción sí |
| Stages | Las etapas de cada job y sus tareas: cuántas son, qué ejecutor hizo cada una, cuánto tardó y cuántos datos leyó o intercambió en el shuffle. «DAG Visualization» dibuja el grafo de dependencias entre las operaciones de la etapa | Ver dónde hay un shuffle (dependencia ancha) y cuántas tareas genera cada número de particiones |
| Storage | Los DataFrames persistidos con cache() o persist(), qué fracción está materializada y cuánto ocupa en memoria y en disco |
Sección de persistencia |
| Environment | La configuración efectiva: propiedades de Spark, versiones de Java y Scala, rutas de bibliotecas | Confirmar valores como spark.sql.shuffle.partitions |
| Executors | Los ejecutores registrados, con sus núcleos, su memoria, las tareas completadas y el tiempo de recolección de basura. En local[2] sólo aparece driver |
Sobre YARN, ver un ejecutor por contenedor y en qué DataNode está cada uno |
| SQL / DataFrame | Una entrada por consulta ejecutada, con el plan físico dibujado como grafo y las métricas reales de cada operador (filas producidas, ficheros y bytes leídos, registros de shuffle). «Details» muestra los planes lógico y físico en texto | Es la versión gráfica, y con medidas, de explain("formatted") |
explain() muestra el plan antes de ejecutar; la pestaña SQL /
DataFrame muestra ese mismo plan después, con lo que ocurrió de verdad
en cada operador. Las dos vistas se complementan durante toda la sesión.
Si tienes abierto otro notebook con su propia SparkSession, la segunda
interfaz se sirve en el puerto 4041, que no está publicado: cierra antes la
otra sesión con spark.stop().
Primera lectura de Parquet
Leemos primero una tabla pequeña, date_dim, y después una tabla de
hechos, web_sales. HDFS es el sistema de ficheros por defecto de este
clúster (igual que en S1 y S2), así que no hace falta ningún prefijo
hdfs://: basta la ruta absoluta /datalake/raw/tpcds/<tabla>.
from pyspark.sql.dataframe import DataFrame

date_dim_path: str = "/datalake/raw/tpcds/date_dim"
date_dim: DataFrame = spark.read.parquet(date_dim_path)

print(f"Ruta física leída: {date_dim_path}")
date_dim.printSchema()
spark.read.parquet(...) no ha leído todavía ninguna fila: sólo ha
abierto los metadatos Parquet para conocer el esquema. Es una
transformación, perezosa como todas. Las siguientes dos llamadas sí son
acciones: obligan a Spark a ejecutar el plan sobre los datos.
date_dim.show(5)

n_date_dim: int = date_dim.count()
print(f"Filas en date_dim: {n_date_dim}")
print(f"Particiones de ejecución: {date_dim.rdd.getNumPartitions()}")

assert n_date_dim == 73_049
Ahora repetimos la misma secuencia con web_sales, la tabla de hechos que
usaremos en la mayor parte de la sesión. Fíjate en que el número de
particiones de ejecución no tiene por qué coincidir con el número de
ficheros Parquet que escribió S2: Spark decide la partición de lectura a
partir del tamaño de los ficheros y de spark.sql.files.maxPartitionBytes,
no copiando uno a uno los ficheros físicos.
web_sales_path: str = "/datalake/raw/tpcds/web_sales"
web_sales: DataFrame = spark.read.parquet(web_sales_path)

print(f"Ruta física leída: {web_sales_path}")
web_sales.printSchema()
web_sales.show(5)

n_web_sales: int = web_sales.count()
print(f"Filas en web_sales: {n_web_sales}")
print(f"Particiones de ejecución: {web_sales.rdd.getNumPartitions()}")

assert n_web_sales == 719_384
El objetivo de esta lectura no es traer SF1 completo a la memoria del
driver: es distribuir la lectura y el cómputo entre particiones que Spark
puede procesar en paralelo. web_sales es sólo una parte de los 261 MiB que
ocupa todo SF1 en Parquet (su tamaño exacto lo da
hdfs dfs -du -h /datalake/raw/tpcds/web_sales); TPC-DS a escalas mayores (SF100, SF1000...) seguiría funcionando
con el mismo código precisamente porque el driver nunca materializa la
tabla entera, sólo coordina el trabajo sobre sus particiones.
Mira ahora la pestaña Jobs de http://localhost:4040: deben aparecer
los jobs que han lanzado los show() y los count() de estas celdas, y
ninguno por las dos llamadas a spark.read.parquet(...).
Transformaciones, acciones y planificación
Encadenamos varias transformaciones sobre web_sales: select, filter y
withColumn. Ninguna ejecuta nada todavía.
from pyspark.sql.functions import col

web_sales_profitable: DataFrame = (
    web_sales.select(
        "ws_order_number",
        "ws_bill_customer_sk",
        "ws_net_profit",
        "ws_ext_sales_price",
    )
    .filter(col("ws_net_profit") > 0)
    .withColumn("margen_sobre_venta", col("ws_net_profit") / col("ws_ext_sales_price"))
)

print(f"Tipo del objeto: {type(web_sales_profitable)}")
web_sales_profitable es un DataFrame con un plan pendiente, no un
resultado. La siguiente celda dispara una acción (show) y es el momento
en el que Spark realmente lee, filtra y calcula.
web_sales_profitable.show(5)
Seleccionar pocas columnas frente a select *
Parquet es un formato columnar: leer sólo las columnas que hacen falta reduce los bytes que hay que transportar desde el fichero. Comparamos el plan físico de una consulta que sólo toca dos columnas con el de otra que lee todas.
narrow_query: DataFrame = web_sales.select("ws_order_number", "ws_net_profit").filter(
    col("ws_net_profit") > 0
)
wide_query: DataFrame = web_sales.select("*").filter(col("ws_net_profit") > 0)

print("Plan de la consulta con columnas seleccionadas:")
narrow_query.explain("formatted")
print("Plan de la consulta con select(\"*\"):")
wide_query.explain("formatted")
Compara la sección ReadSchema de ambos planes: en la consulta estrecha
sólo aparecen ws_order_number y ws_net_profit; en la de select("*")
aparece el esquema completo de web_sales. El filtro
ws_net_profit > 0 también aparece empujado hacia el PushedFilters del
Scan parquet en los dos casos: eso es predicate/projection pushdown.
El efecto hay que comprobarlo en el plan, no
darlo por hecho sólo porque la función se llame filter.
Filtrado, ordenación y agrupamiento
Contamos, para cada cliente, cuántas líneas de venta con beneficio positivo
tiene en web_sales, y mostramos los diez clientes con más líneas.
Antes de agrupar descartamos las líneas sin cliente. TPC-DS deja a propósito
algunas claves nulas en las tablas de hechos, para simular datos de origen
imperfectos, y groupBy reúne todos los nulos en un único grupo: sin el
filtro, ese grupo NULL encabezaría la lista con más líneas que cualquier
cliente real, como si fuera uno más. S2 hizo lo mismo con is_valid al
contar pedidos por cliente con PyArrow.
Aquí seguimos
contando líneas, no pedidos: cada fila de web_sales es una línea de
un pedido, y un mismo pedido puede tener varias líneas.
lineas_con_beneficio: DataFrame = (
    web_sales.filter((col("ws_net_profit") > 0) & col("ws_bill_customer_sk").isNotNull())
    .groupBy("ws_bill_customer_sk")
    .count()
    .orderBy(col("count").desc())
)
lineas_con_beneficio.show(10)
rollup y cube
Unimos web_sales con date_dim (por ws_sold_date_sk = d_date_sk) y con
item (por ws_item_sk = i_item_sk) para agregar el beneficio neto por año
y por categoría de producto.
item: DataFrame = spark.read.parquet("/datalake/raw/tpcds/item")

web_sales_dated_categorized: DataFrame = (
    web_sales.join(date_dim, web_sales.ws_sold_date_sk == date_dim.d_date_sk)
    .join(item, web_sales.ws_item_sk == item.i_item_sk)
    .select("d_year", "i_category", "ws_net_profit")
)

n_item: int = item.count()
print(f"Filas en item: {n_item}")
assert n_item == 18_000
from pyspark.sql.functions import sum as spark_sum

rollup_year_category: DataFrame = (
    web_sales_dated_categorized.rollup("d_year", "i_category")
    .agg(spark_sum("ws_net_profit").alias("beneficio_neto"))
    .orderBy("d_year", "i_category")
)
rollup_year_category.show(100)
En el resultado del rollup, un null en i_category con d_year
relleno es el subtotal de ese año en todas las categorías; un null en
ambas columnas es el total general. rollup añade subtotales siguiendo el
orden de las columnas indicadas (primero por d_year, luego por la
combinación de ambas), pero no añade el subtotal de cada categoría sumando
todos los años.
cube sí genera todas las combinaciones de subtotales, incluida esa:
cube_year_category: DataFrame = (
    web_sales_dated_categorized.cube("d_year", "i_category")
    .agg(spark_sum("ws_net_profit").alias("beneficio_neto"))
    .orderBy("d_year", "i_category")
)
cube_year_category.show(100)
Comprueba en el resultado del cube que ahora también aparece una fila con
d_year a null e i_category con un valor concreto: el beneficio de esa
categoría sumando todos los años, algo que rollup no calculaba.
Joins
Cargamos customer y customer_address, y preparamos una selección de
web_sales con las claves de unión que necesitaremos.
import pyspark.sql.functions as F

customer: DataFrame = spark.read.parquet("/datalake/raw/tpcds/customer")
customer_address: DataFrame = spark.read.parquet("/datalake/raw/tpcds/customer_address")

n_customer: int = customer.count()
n_customer_address: int = customer_address.count()
print(f"Filas en customer: {n_customer}")
print(f"Filas en customer_address: {n_customer_address}")
assert n_customer == 100_000
assert n_customer_address == 50_000

# Mismo filtro que usó S2 para reconocer las direcciones ya cruzadas con el
# INE: país fijado a España, municipio y provincia no nulos, y código de
# provincia de dos dígitos.
localized_addresses: DataFrame = customer_address.filter(
    (F.trim(F.col("ca_country")) == "España")
    & F.col("ca_city").isNotNull()
    & F.col("ca_county").isNotNull()
    & F.trim(F.col("ca_state")).rlike(r"^[0-9]{2}$")
)
assert localized_addresses.count() == n_customer_address

web_sales_slim: DataFrame = web_sales.select(
    "ws_order_number", "ws_bill_customer_sk", "ws_bill_addr_sk", "ws_net_profit"
)
Tipos de join
Probamos varios tipos de join entre web_sales_slim y customer_address
por ws_bill_addr_sk = ca_address_sk. No todos los domicilios facturados
en web_sales tienen por qué existir en customer_address con
integridad referencial estricta —Parquet no la impone, y TPC-DS la deja
opcional—, así que estos ejemplos también sirven para detectar huérfanos.
from pyspark.sql.column import Column

join_expr: Column = web_sales_slim.ws_bill_addr_sk == customer_address.ca_address_sk

inner: DataFrame = web_sales_slim.join(customer_address, join_expr, "inner")
print(f"INNER JOIN: {inner.count()} filas.")
left_outer: DataFrame = web_sales_slim.join(customer_address, join_expr, "left_outer")
print(f"LEFT OUTER JOIN: {left_outer.count()} filas (incluye líneas sin domicilio conocido).")
right_outer: DataFrame = web_sales_slim.join(customer_address, join_expr, "right_outer")
print(f"RIGHT OUTER JOIN: {right_outer.count()} filas (incluye domicilios sin ventas).")
left_semi: DataFrame = web_sales_slim.join(localized_addresses, join_expr, "left_semi")
print(
    f"LEFT SEMI JOIN: {left_semi.count()} filas de web_sales cuyo domicilio existe"
    " y está localizado (municipio del INE) en customer_address."
)
left_anti: DataFrame = web_sales_slim.join(customer_address, join_expr, "left_anti")
print(
    f"LEFT ANTI JOIN: {left_anti.count()} filas de web_sales cuyo domicilio NO existe en customer_address."
)
# Producto cartesiano: cada fila de web_sales_slim con TODAS las filas de
# customer_address. NO debe ejecutarse: el resultado tendría
# aproximadamente 719.384 x 50.000 filas.
# cross = web_sales_slim.crossJoin(customer_address)
Broadcast join
customer_address tiene 50.000 filas: es pequeña comparada con las 719.384
de web_sales. Podemos pedirle a Spark que la distribuya entera a cada
ejecutor con broadcast(), evitando el shuffle de la tabla grande.
from pyspark.sql.functions import broadcast

sales_with_state: DataFrame = web_sales_slim.join(broadcast(customer_address), join_expr, "inner")

print("Plan físico del broadcast join:")
sales_with_state.explain("formatted")
En el plan busca BroadcastHashJoin y BroadcastExchange: la tabla
grande (web_sales_slim) no aparece envuelta en un Exchange de
shuffle, sólo la pequeña se distribuye entera. Guardamos
sales_with_state porque la reutilizaremos más adelante, en la sección de
persistencia.
Funciones escalares y agregadas
Calculamos estadísticos simples sobre ws_ext_sales_price, el importe
extendido de venta antes de descuentos e impuestos.
web_sales.select(
    F.avg("ws_ext_sales_price").alias("precio_medio"),
    F.max("ws_ext_sales_price").alias("precio_maximo"),
    F.min("ws_ext_sales_price").alias("precio_minimo"),
    F.count("ws_ext_sales_price").alias("lineas_con_precio"),
).show()
web_sales.select("ws_ext_sales_price", "ws_net_profit").describe().show()
describe() añade además la desviación típica y los valores mínimo/máximo
como cadenas de texto (por eso todas las columnas del resultado aparecen
como string); es una forma rápida de comprobar rangos y detectar valores
sospechosos antes de construir una consulta de negocio más elaborada.
Tipos complejos: arrays y structs
Spark puede representar columnas que contienen, a su vez, estructuras o
listas. Vamos a construir, para cada cliente, su historial de pedidos web
como un array de struct. Primero agregamos web_sales a nivel de
pedido (no de línea): un mismo ws_order_number puede tener varias
líneas, así que sumamos su importe neto pagado antes de construir el
historial.
orders_base: DataFrame = web_sales.groupBy("ws_bill_customer_sk", "ws_order_number").agg(
    F.sum("ws_net_paid").alias("importe_pedido"),
    F.first("ws_sold_date_sk").alias("ws_sold_date_sk"),
)
print(f"Pedidos distintos agregados: {orders_base.count()}")
customer_order_history: DataFrame = orders_base.groupBy("ws_bill_customer_sk").agg(
    F.collect_list(
        F.struct(
            col("ws_order_number"),
            col("importe_pedido"),
            col("ws_sold_date_sk"),
        )
    ).alias("historial_pedidos")
)
customer_order_history.printSchema()
customer_order_history.show(5, truncate=False)
Cada elemento del array historial_pedidos es ya un pedido agregado
(gracias al groupBy anterior por ws_order_number), no una línea suelta.
Podemos acceder al primer pedido del array con getItem, contar cuántos
pedidos tiene cada cliente con size, y filtrar clientes con muchos
pedidos.
customer_order_history.select(
    "ws_bill_customer_sk",
    F.col("historial_pedidos").getItem(0).alias("primer_pedido_del_array"),
    F.size("historial_pedidos").alias("numero_de_pedidos"),
).orderBy(F.col("numero_de_pedidos").desc()).show(10, truncate=False)
clientes_con_muchos_pedidos: DataFrame = customer_order_history.filter(
    F.size("historial_pedidos") > 5
)
print(f"Clientes con más de 5 pedidos: {clientes_con_muchos_pedidos.count()}")
explode hace el camino inverso: convierte cada elemento del array en una
fila independiente, recuperando una fila por pedido en vez de una fila por
cliente.
exploded_orders: DataFrame = customer_order_history.select(
    "ws_bill_customer_sk", F.explode("historial_pedidos").alias("pedido")
)
exploded_orders.select(
    "ws_bill_customer_sk",
    col("pedido.ws_order_number").alias("pedido_numero"),
    col("pedido.importe_pedido").alias("importe"),
).orderBy("ws_bill_customer_sk", "pedido_numero").show(10)
Funciones definidas por el usuario (UDFs)
Cuando una transformación no se puede expresar con las funciones integradas de Spark, se puede registrar una función Python como UDF. Vamos a clasificar cada línea de venta según su beneficio neto en tres etiquetas.
from decimal import Decimal

from pyspark.sql.types import StringType


@F.udf(returnType=StringType())
def clasificar_beneficio(net_profit: Decimal | None) -> str:
    # Clasifica una línea de venta según su beneficio neto (ws_net_profit).
    if net_profit is None:
        return "desconocido"
    if net_profit < 0:
        return "perdida"
    if net_profit < 50:
        return "margen_bajo"
    return "margen_alto"


web_sales_classified: DataFrame = web_sales.withColumn(
    "clasificacion_beneficio", clasificar_beneficio(col("ws_net_profit"))
)
web_sales_classified.groupBy("clasificacion_beneficio").count().orderBy(
    F.col("count").desc()
).show()
Aviso de rendimiento. Esta UDF funciona, pero Spark no puede mirar
dentro del código Python que hemos escrito: no sabe qué hace
clasificar_beneficio, así que no puede aplicarle las optimizaciones de
Catalyst (reordenar, podar columnas dentro de la función) ni ejecutarla en
Tungsten como haría con una expresión nativa. Además, cada fila viaja de la
JVM al proceso Python y vuelve, lo que añade serialización. La misma
clasificación con funciones integradas —F.when(...).otherwise(...)— se
ejecuta enteramente dentro del motor y suele ser bastante más rápida:
web_sales_classified_builtin: DataFrame = web_sales.withColumn(
    "clasificacion_beneficio",
    F.when(col("ws_net_profit").isNull(), "desconocido")
    .when(col("ws_net_profit") < 0, "perdida")
    .when(col("ws_net_profit") < 50, "margen_bajo")
    .otherwise("margen_alto"),
)
web_sales_classified_builtin.groupBy("clasificacion_beneficio").count().orderBy(
    F.col("count").desc()
).show()
Regla de la sesión: usa una UDF sólo cuando no exista una combinación de funciones integradas que exprese la misma lógica.
Funciones de ventana
Reutilizamos orders_base (un pedido por fila, con su importe neto
pagado) y le añadimos la fecha de negocio uniendo con date_dim. A partir
de ahí construimos cuatro ejemplos clásicos de funciones de ventana.
from pyspark.sql.window import Window, WindowSpec

orders_dated: DataFrame = orders_base.join(
    date_dim, orders_base.ws_sold_date_sk == date_dim.d_date_sk
).select(
    col("ws_bill_customer_sk").alias("cliente"),
    col("ws_order_number").alias("pedido"),
    col("d_date").alias("fecha_pedido"),
    col("importe_pedido"),
)
orders_dated.orderBy("cliente", "fecha_pedido").show(10)
Máximo por partición: el pedido mayor de cada cliente
Window.partitionBy no reduce filas —a diferencia de groupBy—: añade una
columna calculada a cada fila original, agregada dentro de su partición.
from pyspark.sql.column import Column

ventana_por_cliente: WindowSpec = Window.partitionBy("cliente")
importe_maximo_cliente: Column = F.max("importe_pedido").over(ventana_por_cliente)

orders_dated.select(
    "cliente",
    "pedido",
    "importe_pedido",
    importe_maximo_cliente.alias("pedido_mayor_del_cliente"),
).withColumn(
    "es_su_pedido_mayor", col("importe_pedido") == col("pedido_mayor_del_cliente")
).orderBy(
    "cliente", "fecha_pedido"
).show(
    15
)
lag/lead: días entre pedidos consecutivos de un mismo cliente
Aquí sí importa el orden dentro de la ventana: la particionamos por cliente y la ordenamos por fecha de pedido.
ventana_ordenada: WindowSpec = Window.partitionBy("cliente").orderBy("fecha_pedido")

fecha_pedido_anterior: Column = F.lag("fecha_pedido", 1).over(ventana_ordenada)
fecha_pedido_siguiente: Column = F.lead("fecha_pedido", 1).over(ventana_ordenada)

orders_dated.select(
    "cliente",
    "pedido",
    "fecha_pedido",
    F.datediff("fecha_pedido", fecha_pedido_anterior).alias("dias_desde_pedido_anterior"),
    F.datediff(fecha_pedido_siguiente, "fecha_pedido").alias("dias_hasta_pedido_siguiente"),
).orderBy("cliente", "fecha_pedido").show(15)
Media móvil de los últimos 3 pedidos por cliente
rowsBetween(-2, 0) define un marco que incluye la fila actual y las dos
anteriores dentro de la misma partición ordenada.
ventana_movil: WindowSpec = ventana_ordenada.rowsBetween(-2, 0)
media_movil_3_pedidos: Column = F.avg("importe_pedido").over(ventana_movil)

orders_dated.select(
    "cliente",
    "pedido",
    "fecha_pedido",
    "importe_pedido",
    media_movil_3_pedidos.alias("media_movil_3_pedidos"),
).orderBy("cliente", "fecha_pedido").show(15)
Suma acumulada del gasto por cliente
Window.unboundedPreceding hasta la fila actual acumula todas las filas
anteriores de la partición: es el patrón habitual para un total corriente.
ventana_acumulada: WindowSpec = ventana_ordenada.rowsBetween(
    Window.unboundedPreceding, Window.currentRow
)
gasto_acumulado: Column = F.sum("importe_pedido").over(ventana_acumulada)

orders_dated.select(
    "cliente",
    "pedido",
    "fecha_pedido",
    "importe_pedido",
    gasto_acumulado.alias("gasto_acumulado_cliente"),
).orderBy("cliente", "fecha_pedido").show(15)
Spark SQL con vistas temporales
Un DataFrame se puede registrar como vista temporal y consultarse con SQL:
web_sales.createOrReplaceTempView("web_sales")
spark.sql("SELECT ... FROM web_sales")
La vista desaparece al terminar la sesión: no crea ningún nombre persistente, ni un esquema de catálogo, ni una tabla Hive. Es sólo una forma de escribir la misma consulta con SQL en lugar de con el API de DataFrames. Reproducimos aquí, en Spark SQL, las tres preguntas de negocio que S2 ya respondió con PyArrow, Polars y DuckDB sobre los mismos ficheros, para comprobar que el motor cambia pero el significado de los datos no.
web_sales.createOrReplaceTempView("web_sales")
customer.createOrReplaceTempView("customer")
customer_address.createOrReplaceTempView("customer_address")
date_dim.createOrReplaceTempView("date_dim")

time_dim: DataFrame = spark.read.parquet("/datalake/raw/tpcds/time_dim")
n_time_dim: int = time_dim.count()
print(f"Filas en time_dim: {n_time_dim}")
assert n_time_dim == 86_400
time_dim.createOrReplaceTempView("time_dim")
Cliente con más pedidos
Como en S2, contamos pedidos distintos con
count(DISTINCT ws_order_number): contar * contaría líneas, no pedidos.
spark.sql("""
    SELECT
        c.c_customer_id,
        count(DISTINCT s.ws_order_number) AS pedidos,
        count(*) AS lineas_de_venta
    FROM web_sales AS s
    JOIN customer AS c
        ON s.ws_bill_customer_sk = c.c_customer_sk
    GROUP BY c.c_customer_id
    ORDER BY pedidos DESC, c.c_customer_id
    LIMIT 10
""").show()
Provincia con más compras
S2 cruzó las direcciones sintéticas con la relación municipal del INE.
ca_county contiene ahora la provincia y ca_state su código INE de dos
caracteres; las claves que enlazan las ventas no cambiaron.
spark.sql("""
    SELECT
        a.ca_state AS codigo_provincia,
        a.ca_county AS provincia,
        count(DISTINCT s.ws_order_number) AS pedidos,
        sum(s.ws_ext_sales_price) AS ventas
    FROM web_sales AS s
    JOIN customer_address AS a
        ON s.ws_bill_addr_sk = a.ca_address_sk
    GROUP BY a.ca_state, a.ca_county
    ORDER BY pedidos DESC, a.ca_state
    LIMIT 10
""").show()
Distribución horaria de las compras
Unimos por ws_sold_time_sk = t_time_sk, no por t_time: esa segunda
columna es la representación numérica completa de la hora, no la clave que
usa web_sales.
spark.sql("""
    SELECT
        t.t_hour,
        count(DISTINCT s.ws_order_number) AS pedidos,
        sum(s.ws_ext_sales_price) AS ventas
    FROM web_sales AS s
    JOIN time_dim AS t
        ON s.ws_sold_time_sk = t.t_time_sk
    GROUP BY t.t_hour
    ORDER BY t.t_hour
""").show(24)
Las tres consultas anteriores son equivalentes, columna a columna y clave a clave, a las que S2 resolvió con PyArrow, Polars y DuckDB. Lo único que ha cambiado es el motor que las ejecuta y el hecho de que ahora puede distribuirse sobre YARN, como veremos más adelante.
Beneficio neto por año
Esta consulta no viene de S2: es la misma agregación que ejecutará más
adelante el trabajo que se envía a YARN (spark_sum(ws_net_profit),
count(DISTINCT ws_order_number) y count(*), agrupando por d_year).
Guardamos el resultado en local para compararlo con el que produzca YARN
sobre los mismos datos.
from pyspark.sql import Row

sales_by_year_local: DataFrame = spark.sql("""
    SELECT
        d.d_year,
        sum(s.ws_net_profit) AS beneficio_neto_total,
        count(DISTINCT s.ws_order_number) AS pedidos_distintos,
        count(*) AS lineas_de_venta
    FROM web_sales AS s
    JOIN date_dim AS d
        ON s.ws_sold_date_sk = d.d_date_sk
    GROUP BY d.d_year
    ORDER BY d.d_year
""")
sales_by_year_local.show()

# Se guarda como filas de Python: la SparkSession local se cierra antes de
# lanzar el trabajo sobre YARN y el DataFrame deja de poder usarse.
sales_by_year_local_rows: list[Row] = sales_by_year_local.collect()
Guardar resultados
Escribimos la agregación de beneficio por año y categoría en HDFS, bajo una
ruta de trabajo separada de /datalake. Es un groupBy normal sobre
web_sales_dated_categorized, no el rollup de la sección anterior: aquí
no hace falta ninguna fila de subtotal, sólo el detalle por año y
categoría. Primero preparamos el espacio de trabajo de esta sesión.
!hdfs dfs -mkdir -p /user/luser/s4
sales_by_year_category: DataFrame = web_sales_dated_categorized.groupBy("d_year", "i_category").agg(
    spark_sum("ws_net_profit").alias("beneficio_neto")
)
print(f"Filas a escribir: {sales_by_year_category.count()}")
El problema de los ficheros pequeños
Si repartimos el resultado en muchas particiones antes de escribir, Spark crea hasta un fichero Parquet por partición (las particiones vacías no llegan a escribir fichero), y la mayoría de las que sí escriben quedan casi vacías: es el problema de los "ficheros pequeños" que tanto penaliza a HDFS y a los motores que después lean esa tabla.
Para listar el resultado usamos una orden de shell con una variable de
Python entre llaves: en las celdas !orden, IPython sustituye {variable}
por su valor antes de ejecutar la orden.
many_files_path: str = "/user/luser/s4/sales-by-year-category-muchos-ficheros"
sales_by_year_category.repartition(50).write.mode("overwrite").parquet(many_files_path)
!hdfs dfs -ls {many_files_path}
Consolidar antes de escribir con coalesce
coalesce(n) reduce el número de particiones sin forzar un shuffle
completo (a diferencia de repartition(n)), agrupando particiones
existentes. Es la forma habitual de evitar el problema anterior sin pagar
el coste de una redistribución completa.
few_files_path: str = "/user/luser/s4/sales-by-year-category-pocos-ficheros"
sales_by_year_category.coalesce(4).write.mode("overwrite").parquet(few_files_path)
!hdfs dfs -ls {few_files_path}
En esta sección coalesce controla cuántos ficheros produce la escritura.
S5 retomará esta idea al organizar físicamente los datos por valores de
columna.
Particiones de ejecución
repartition(n) y coalesce(n) cambian cuántas particiones tiene un
DataFrame, pero tienen costes distintos: repartition siempre hace un
shuffle completo (puede aumentar o reducir el número de particiones,
redistribuyendo todas las filas); coalesce sólo puede reducir particiones
y evita el shuffle completo agrupando particiones vecinas, aunque a
costa de un reparto potencialmente menos equilibrado.
Reparticionar antes de un join
Si dos DataFrames que se van a unir se reparticionan por la misma clave de
unión y con el mismo número de particiones, Spark puede aprovechar esa
coincidencia para reducir el shuffle del join. No es automático ni
garantizado: hay que comprobarlo en el plan, no darlo por supuesto por
haber llamado a repartition.
print(f"web_sales_slim particiones (antes): {web_sales_slim.rdd.getNumPartitions()}")
print(f"customer_address particiones (antes): {customer_address.rdd.getNumPartitions()}")

web_sales_by_addr: DataFrame = web_sales_slim.repartition(8, "ws_bill_addr_sk")
customer_address_by_key: DataFrame = customer_address.repartition(8, "ca_address_sk")

print(f"web_sales_by_addr particiones (después): {web_sales_by_addr.rdd.getNumPartitions()}")
print(
    f"customer_address_by_key particiones (después): {customer_address_by_key.rdd.getNumPartitions()}"
)
join_expr_repartitioned: Column = (
    web_sales_by_addr.ws_bill_addr_sk == customer_address_by_key.ca_address_sk
)
sales_with_state_repartitioned: DataFrame = web_sales_by_addr.join(
    customer_address_by_key, join_expr_repartitioned, "inner"
)

print("Plan físico tras reparticionar por la clave de unión:")
sales_with_state_repartitioned.explain("formatted")
Busca en el plan si sigue apareciendo un Exchange justo antes del Join
para cada lado. Reparticionar por la misma clave y el mismo número de
particiones facilita que Spark reconozca la coincidencia, pero el
optimizador decide caso a caso; por eso hay que medir el plan
en lugar de suponer el efecto sólo por el nombre de la función.
Configuración del shuffle
spark.sql.shuffle.partitions fija cuántas particiones produce cualquier
operación wide. Lo comprobamos con una agregación de store_sales
—2.880.404 filas, la mayor tabla de hechos que usaremos en esta
sesión— por año de venta. Desactivamos primero Adaptive Query Execution
(activo por defecto en Spark 4): si no, AQE podría fusionar particiones de
shuffle pequeñas él mismo y el número de particiones que se imprime a
continuación dejaría de depender solo de shuffle.partitions. La
reactivamos al terminar esta demostración, antes de la sección dedicada a
AQE.
spark.conf.set("spark.sql.adaptive.enabled", "false")

store_sales: DataFrame = spark.read.parquet("/datalake/raw/tpcds/store_sales")
n_store_sales: int = store_sales.count()
print(f"Filas en store_sales: {n_store_sales}")
assert n_store_sales == 2_880_404

print(f"spark.sql.shuffle.partitions actual: {spark.conf.get('spark.sql.shuffle.partitions')}")
store_sales_by_year: DataFrame = (
    store_sales.join(date_dim, store_sales.ss_sold_date_sk == date_dim.d_date_sk)
    .groupBy("d_year")
    .agg(spark_sum("ss_ext_sales_price").alias("ventas_tienda"))
)
print(
    f"Particiones tras el groupBy (shuffle.partitions=8): {store_sales_by_year.rdd.getNumPartitions()}"
)
spark.conf.set("spark.sql.shuffle.partitions", 3)

store_sales_by_year_3: DataFrame = (
    store_sales.join(date_dim, store_sales.ss_sold_date_sk == date_dim.d_date_sk)
    .groupBy("d_year")
    .agg(spark_sum("ss_ext_sales_price").alias("ventas_tienda"))
)
print(
    f"Particiones tras el groupBy (shuffle.partitions=3): {store_sales_by_year_3.rdd.getNumPartitions()}"
)

# Volvemos a los valores usados en el resto del notebook
spark.conf.set("spark.sql.shuffle.partitions", 8)
spark.conf.set("spark.sql.adaptive.enabled", "true")
El número de filas del resultado no cambia (sigue habiendo un puñado de años en SF1); lo que cambia es en cuántas particiones queda repartido ese resultado, y por tanto cuántas tareas paralelas puede lanzar Spark sobre él en el siguiente paso del pipeline.
Adaptive Query Execution (AQE)
AQE deja que Spark reajuste el plan durante la ejecución, con estadísticas reales en lugar de sólo estimaciones previas. Una de sus funciones más visibles es fusionar particiones de shuffle que han quedado demasiado pequeñas tras un filtro selectivo.
Para verlo con datos reales, primero calculamos el rango de años presente
en date_dim, en lugar de suponer un año concreto.
from pyspark.sql.types import Row

year_bounds: Row | None = date_dim.agg(
    F.min("d_year").alias("min_year"), F.max("d_year").alias("max_year")
).first()
sample_year: int = (year_bounds["min_year"] + year_bounds["max_year"]) // 2
print(
    f"Años en date_dim: {year_bounds['min_year']}-{year_bounds['max_year']}. Usamos {sample_year}."
)
spark.conf.set("spark.sql.shuffle.partitions", 200)
spark.conf.set("spark.sql.adaptive.enabled", "false")

sin_aqe: DataFrame = (
    store_sales.join(date_dim, store_sales.ss_sold_date_sk == date_dim.d_date_sk)
    .filter(col("d_year") == sample_year)
    .groupBy("d_year")
    .agg(spark_sum("ss_ext_sales_price").alias("ventas_tienda"))
)
sin_aqe.collect()
print(f"Particiones sin AQE (shuffle.partitions=200): {sin_aqe.rdd.getNumPartitions()}")
spark.conf.set("spark.sql.adaptive.enabled", "true")
spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "true")

con_aqe: DataFrame = (
    store_sales.join(date_dim, store_sales.ss_sold_date_sk == date_dim.d_date_sk)
    .filter(col("d_year") == sample_year)
    .groupBy("d_year")
    .agg(spark_sum("ss_ext_sales_price").alias("ventas_tienda"))
)
con_aqe.collect()
print(f"Particiones con AQE (coalescePartitions habilitado): {con_aqe.rdd.getNumPartitions()}")

# Volvemos al valor usado en el resto del notebook
spark.conf.set("spark.sql.shuffle.partitions", 8)
El filtro d_year == sample_year selecciona un único año de los varios
que hay en date_dim; el groupBy("d_year") posterior agrupa todas esas
filas bajo una sola clave, así que el shuffle concentra casi todo en una
partición y deja las otras 199 vacías. Sin AQE, esas 200 particiones de
shuffle casi vacías se mantienen tal cual. Con coalescePartitions
habilitado, Spark las fusiona en menos particiones después de ver
cuántas filas sobrevivieron al filtro y a cuántas claves de agrupación se
redujeron, no antes.
Persistencia
sales_with_state, el resultado del broadcast join de la sección de
joins, es un buen candidato para cachear: lo vamos a consultar varias
veces seguidas. Por defecto, Spark recalcula un DataFrame desde sus fuentes
cada vez que una acción lo necesita; cache()/persist() evitan ese
recálculo guardando el resultado la primera vez que se materializa.
print(f"¿Está cacheado antes de cache()?: {sales_with_state.is_cached}")

sales_with_state.cache()
sales_with_state.count()  # acción que materializa la cache

print(f"¿Está cacheado después de cache()?: {sales_with_state.is_cached}")
print(f"Nivel de almacenamiento: {sales_with_state.storageLevel}")
sales_with_state.groupBy("ca_state", "ca_county").count().orderBy(F.col("count").desc()).show(5)
sales_with_state.agg(F.avg("ws_net_profit")).show()
Ambas acciones anteriores han reutilizado la versión cacheada, sin volver a
ejecutar el broadcast join. Pero la persistencia no se hereda: un
DataFrame construido a partir de uno cacheado, mediante una nueva
transformación, no queda cacheado automáticamente. Mientras
sales_with_state está cacheado, la pestaña Storage de la interfaz de
Spark lo lista con el espacio que ocupa.
sales_with_state_profitable: DataFrame = sales_with_state.filter(col("ws_net_profit") > 0)
print(f"¿Está cacheado el DataFrame derivado?: {sales_with_state_profitable.is_cached}")
from pyspark import StorageLevel

sales_with_state.unpersist()
print(f"¿Está cacheado tras unpersist()?: {sales_with_state.is_cached}")

sales_with_state.persist(StorageLevel.MEMORY_AND_DISK)
sales_with_state.count()
print(f"Nuevo nivel de almacenamiento: {sales_with_state.storageLevel}")
sales_with_state.unpersist()
MEMORY_AND_DISK guarda en disco las particiones que no quepan en
memoria, en lugar de recalcularlas cada vez; es un compromiso razonable
cuando el DataFrame es más grande que la memoria disponible del driver en
modo local. Dejamos sales_with_state sin persistir al terminar esta
sección, para no competir por memoria con las siguientes.
spark.stop()
Cerramos aquí la sesión local: la siguiente sección no puede reutilizarla,
porque Spark no permite cambiar el master de una SparkSession ya
construida. El envío a YARN se hace como un proceso completamente aparte,
mediante spark-submit.
Driver, ejecutores y YARN
Hasta ahora, "driver" y "ejecutores" eran hilos dentro del mismo proceso
local[2]. Sobre YARN son procesos reales, potencialmente en máquinas
distintas:
- el driver sigue siendo el proceso que construye el plan y coordina
la aplicación; en modo
client(el que usaremos) vive ennamenode, junto al procesospark-submitque lo lanza; - el ApplicationMaster es el interlocutor de la aplicación ante el ResourceManager: pide y libera contenedores;
- los ejecutores son contenedores YARN que se ejecutan en los
NodeManagers de los DataNodes —los mismos
datanode1,datanode2ydatanode3de S1— y sobre los que Spark reparte las tareas.
Como ya se explicó en "Instalar PySpark en este notebook", una SparkSession no puede
cambiar de master una vez construida: por eso esta sección no reutiliza
la sesión local de las secciones anteriores, sino que escribe un script
independiente y lo lanza con spark-submit --master yarn como un proceso
nuevo.
Qué Python usan el driver y los ejecutores
El envío a YARN usa el mismo entorno Python que el kernel de este notebook,
/opt/tcdm/venv, instalado en la imagen de namenode y comprobado con
%pip install -r requirements.txt al principio de la sesión. De él salen
tanto spark-submit como el intérprete del driver, el único proceso que
necesita el paquete pyspark instalado para construir la SparkSession y
lanzar la aplicación.
Los ejecutores son otra historia: se ejecutan en los DataNodes, cuyas
imágenes sólo traen el python3 de base (sin PySpark ni ningún paquete
instalado por pip). spark-submit --master yarn distribuye a través de YARN
los ficheros de soporte de PySpark (pyspark.zip y py4j.zip) y los .jar
de Spark, así que a cada DataNode le basta con ese intérprete base para
ejecutar el código ya distribuido. Por eso el envío pide
spark.pyspark.python=python3 a secas: el python3 del sistema en cada
DataNode, que es la misma versión de Python que la de /opt/tcdm/venv
porque ambas imágenes parten de la misma base.
El script que se enviará a YARN
Escribimos un fichero .py independiente. Hace dos cosas: calcula el
beneficio neto total de web_sales por año (uniendo con date_dim, la
misma clave de negocio de siempre) y, además, genera un pequeño informe de
qué host ha procesado cada partición. mapPartitionsWithIndex ejecuta una
función en cada partición y permite registrar allí
socket.gethostname(). Así se comprueba que YARN reparte el trabajo entre
varios DataNodes.
from pathlib import Path

JOB_SCRIPT: str = r'''
# Trabajo independiente para YARN, lanzado con spark-submit --master yarn.
#
# No es la SparkSession del notebook: Spark no permite cambiar el master de
# una sesión ya construida, así que esta aplicación crea la suya propia.
import socket

from pyspark.sql import SparkSession
from pyspark.sql.functions import count, countDistinct
from pyspark.sql.functions import sum as spark_sum
from pyspark.sql.types import IntegerType, LongType, StringType, StructField, StructType

BUSINESS_OUTPUT = "/user/luser/s4/yarn-job/business-result"
EXECUTOR_REPORT_OUTPUT = "/user/luser/s4/yarn-job/executor-report"

spark = SparkSession.builder.appName("TCDM_S4_YARN_business").master("yarn").getOrCreate()

date_dim = spark.read.parquet("/datalake/raw/tpcds/date_dim")
web_sales = spark.read.parquet("/datalake/raw/tpcds/web_sales")

sales_by_year = (
    web_sales.join(date_dim, web_sales.ws_sold_date_sk == date_dim.d_date_sk)
    .groupBy("d_year")
    .agg(
        spark_sum("ws_net_profit").alias("beneficio_neto_total"),
        countDistinct("ws_order_number").alias("pedidos_distintos"),
        count("*").alias("lineas_de_venta"),
    )
    .orderBy("d_year")
)
sales_by_year.coalesce(1).write.mode("overwrite").csv(BUSINESS_OUTPUT, header=True)

# Registra el host que ha ejecutado cada partición.
def describe_partition(partition_id, rows):
    rows = list(rows)
    yield (partition_id, socket.gethostname(), len(rows))


reports = (
    web_sales.select("ws_order_number").rdd.mapPartitionsWithIndex(describe_partition).collect()
)

report_schema = StructType(
    [
        StructField("partition", IntegerType(), False),
        StructField("executor_host", StringType(), False),
        StructField("records", LongType(), False),
    ]
)
(
    spark.createDataFrame(reports, report_schema)
    .orderBy("partition")
    .coalesce(1)
    .write.mode("overwrite")
    .csv(EXECUTOR_REPORT_OUTPUT, header=True)
)

distinct_hosts = {report[1] for report in reports}
print(f"Hosts remotos que procesaron alguna partición: {sorted(distinct_hosts)}")
spark.stop()
'''

Path("/tmp/s4_yarn_job.py").write_text(JOB_SCRIPT)
print("Escrito /tmp/s4_yarn_job.py")
Cuántos ejecutores pedir
El número de ejecutores que se solicita debe derivarse de los NodeManagers
que YARN anuncia como
RUNNING, no de un número fijo elegido a mano. La variable de entorno
TCDM_SPARK_EXECUTORS, si está definida, permite forzar otro valor, por
ejemplo para probar con menos ejecutores.
import subprocess

result: subprocess.CompletedProcess[str] = subprocess.run(
    [
        "bash",
        "-lc",
        "yarn node -list -all 2>/dev/null | awk '$2 == \"RUNNING\" {count++} END {print count + 0}'",
    ],
    capture_output=True,
    text=True,
    check=True,
)
running_nodemanagers: int = int(result.stdout.strip() or 0)
print(f"NodeManagers en estado RUNNING: {running_nodemanagers}")

assert running_nodemanagers >= 2, "Se esperan al menos dos NodeManagers RUNNING"
import os

requested_executors: int = int(os.environ.get("TCDM_SPARK_EXECUTORS", running_nodemanagers))
print(f"Solicitando {requested_executors} ejecutores Spark a YARN.")
El envío con spark-submit
Los valores de memoria y núcleos están ajustados a los recursos de este clúster:
--executor-cores 1 --executor-memory 512mjunto conspark.executor.memoryOverhead=256msuman 768 MiB por ejecutor, dentro de los 2560 MiB que cada NodeManager anuncia a YARN (recuerda: de los 3072 MiB del contenedor DataNode, 512 MiB quedan reservados para el propio DataNode, el NodeManager y otros procesos auxiliares).spark.yarn.am.coresyspark.yarn.am.memory/memoryOverheadson la petición de recursos del ApplicationMaster, un contenedor YARN aparte de los ejecutores.spark.scheduler.minRegisteredResourcesRatio=1.0junto conmaxRegisteredResourcesWaitingTime=60shacen que Spark espere a tener todos los ejecutores solicitados (o hasta 60 segundos) antes de empezar a repartir tareas, evitando medir la distribución de trabajo con sólo parte de los ejecutores ya registrados.spark.pyspark.python=python3es el intérprete de los ejecutores (elpython3de base de cada DataNode);spark.pyspark.driver.pythonapunta al Python de/opt/tcdm/venv, el único sitio donde hace falta el paquetepysparkinstalado.
Usamos el spark-submit de /opt/tcdm/venv/bin, el mismo entorno que el
kernel, para que coincida exactamente con la versión de PySpark que usa el
resto del notebook.
Mientras el trabajo está en marcha, su driver —que también vive en
namenode— vuelve a servir la interfaz de Spark, y la pestaña Executors
muestra ahora un ejecutor por contenedor YARN, cada uno en su DataNode.
Sobre YARN esa interfaz se consulta a través del ResourceManager: en
http://localhost:8088, el enlace ApplicationMaster de la aplicación; si
el navegador acaba en una dirección con el nombre resourcemanager,
sustitúyelo por localhost. El trabajo dura poco y la interfaz desaparece
cuando termina: la evidencia permanente de qué host procesó cada partición
es el informe que escribe el propio script.
La orden imprime muchas líneas de registro de Spark y puede tardar un minuto
o más. La que importa está casi al final:
Hosts remotos que procesaron alguna partición: [...].
spark_submit_cmd: str = f"""/opt/tcdm/venv/bin/spark-submit \
    --master yarn \
    --deploy-mode client \
    --num-executors {requested_executors} \
    --executor-cores 1 \
    --executor-memory 512m \
    --conf spark.executor.memoryOverhead=256m \
    --conf spark.yarn.am.cores=1 \
    --conf spark.yarn.am.memory=256m \
    --conf spark.yarn.am.memoryOverhead=256m \
    --conf spark.scheduler.minRegisteredResourcesRatio=1.0 \
    --conf spark.scheduler.maxRegisteredResourcesWaitingTime=60s \
    --conf spark.pyspark.python=python3 \
    --conf spark.pyspark.driver.python=/opt/tcdm/venv/bin/python \
    /tmp/s4_yarn_job.py"""

print(spark_submit_cmd)
!export HADOOP_CONF_DIR=/opt/bd/hadoop/etc/hadoop && {spark_submit_cmd}
Comprobar las evidencias
Leemos de vuelta los dos resultados que ha escrito el trabajo YARN y
comprobamos la aplicación en la CLI de YARN, la misma que el
ResourceManager (http://localhost:8088) muestra de forma gráfica.
!hdfs dfs -cat /user/luser/s4/yarn-job/business-result/part-*.csv
Ese resultado debe ser el mismo que calculó la sesión local en la sección
de Spark SQL. Lo comprobamos fila a fila, con las filas que guardamos
entonces en sales_by_year_local_rows:
import csv
import io
from decimal import Decimal

yarn_csv: str = subprocess.run(
    ["hdfs", "dfs", "-cat", "/user/luser/s4/yarn-job/business-result/part-*.csv"],
    capture_output=True,
    text=True,
    check=True,
).stdout

yarn_by_year: dict[int, tuple[int, int, Decimal]] = {
    int(row["d_year"]): (
        int(row["pedidos_distintos"]),
        int(row["lineas_de_venta"]),
        Decimal(row["beneficio_neto_total"]),
    )
    for row in csv.DictReader(io.StringIO(yarn_csv))
}
local_by_year: dict[int, tuple[int, int, Decimal]] = {
    row["d_year"]: (row["pedidos_distintos"], row["lineas_de_venta"], row["beneficio_neto_total"])
    for row in sales_by_year_local_rows
}

assert yarn_by_year == local_by_year, "El resultado sobre YARN no coincide con el local"
print(f"Local y YARN coinciden en los {len(local_by_year)} años.")
!hdfs dfs -cat /user/luser/s4/yarn-job/executor-report/part-*.csv
!yarn application -list -appStates ALL
Por último, extraemos del informe de particiones la lista de hosts distintos que han hecho trabajo real y comprobamos que al menos dos DataNodes remotos participan cuando los recursos lo permiten. Si sólo aparece uno, repite el envío: con tan pocos datos el planificador puede concentrar el trabajo en un único nodo.
from subprocess import CompletedProcess

report_result: CompletedProcess[str] = subprocess.run(
    ["bash", "-lc", "hdfs dfs -cat /user/luser/s4/yarn-job/executor-report/part-*.csv"],
    capture_output=True,
    text=True,
    check=True,
)
report_lines: list[str] = [line for line in report_result.stdout.splitlines()[1:] if line.strip()]
executor_hosts: set[str] = {line.split(",")[1] for line in report_lines}

print(f"Hosts que procesaron al menos una partición: {sorted(executor_hosts)}")
print(f"Ejecutores remotos que trabajaron: {len(executor_hosts)}")
assert len(executor_hosts) >= 2, "Se esperan al menos dos hosts remotos distintos"
Si todo ha ido bien, el resultado de negocio es el mismo que ya vimos en
modo local en la sección de Spark SQL —beneficio neto, pedidos distintos y
líneas de venta por año, comparados más arriba con un assert—, sólo que
esta vez
calculado por ejecutores que corren en, al menos, dos DataNodes distintos,
coordinados por un driver que vive en namenode.
Hilo de negocio con TPC-DS
A lo largo de la sesión se ha mantenido la misma disciplina que en S2, sólo que ahora ejecutada por Spark, en local y sobre YARN:
- contar líneas de
web_salesconcount(*)es distinto de contar pedidos concount(DISTINCT ws_order_number), y cada consulta de esta sesión ha dicho explícitamente cuál de las dos calculaba; - las sumas de importes o unidades siempre han indicado qué columna
representa la medida (
ws_net_profit,ws_ext_sales_price,ss_ext_sales_price,ws_net_paid...), en lugar de sumar "lo que hubiera"; web_salesse ha unido condate_dimmediantews_sold_date_sk = d_date_sken todas las agregaciones por año, contime_dimmediantews_sold_time_sk = t_time_sken la distribución horaria, y concustomer/customer_addresssólo cuando la pregunta lo necesitaba;- ningún identificador surrogate (
ws_bill_customer_sk,c_customer_sk,ca_address_sk...) se ha presentado como si fuera el nombre de una persona o una región administrativa real: son claves sintéticas del generador TPC-DS.
La sección de YARN calculó el beneficio neto por año exactamente con la misma métrica y las mismas claves que la sección de Spark SQL calculó en local: el motor de ejecución cambia, pero la respuesta de negocio debería ser la misma consultando el mismo dataset inmutable.
Preguntas para interpretar la experiencia
- ¿Qué diferencia concreta hay entre una transformación y una acción? Da un ejemplo de esta sesión de cada una.
- ¿Por qué
select("*")y una selección de dos columnas producen el mismo resultado filtrado pero planes físicos distintos? ¿Qué cambia realmente entre ambos? - El número de particiones de ejecución de un DataFrame, ¿depende del número de ficheros Parquet, del número de bloques HDFS o del número de ejecutores disponibles? Justifica la respuesta con algo que hayas medido en el notebook.
- ¿Por qué un
joinnormal necesita un shuffle y un broadcast join puede evitarlo? ¿Qué condición debe cumplir la tabla que se distribuye entera? - ¿Qué controla
spark.sql.shuffle.partitionsy en qué se diferencia de las particiones de lectura que vimos condate_dimyweb_sales? - ¿Qué decide Adaptive Query Execution por sí solo, y qué sigue estando bajo el control explícito de quien escribe la consulta (por ejemplo, cuántos ejecutores pedir a YARN)?
- ¿Por qué la sección de YARN no pudo reutilizar la
SparkSessionlocal del resto del notebook? ¿Qué tuvo que crearse aparte y por qué? - En la sección de UDFs, ¿qué información concreta pierde Spark al no poder "mirar dentro" de una función Python, y qué consecuencia tiene eso sobre el rendimiento?
Evidencias para la siguiente sesión
Antes de la siguiente sesión tendrás una reunión individual breve con el profesor para revisar el trabajo de esta sesión. Esa reunión combina una demostración en vivo sobre tu propio ordenador y una memoria escrita breve.
Qué mostrar en el ordenador durante la reunión
Ten preparadas estas evidencias:
- El esquema (
printSchema) y el número de filas dedate_dimoweb_sales, junto con su número de particiones de ejecución. - El plan de
.explain("formatted")de al menos una consulta conjoin(por ejemplo, el broadcast join concustomer_address). - El número de particiones de un DataFrame antes y después de un
repartitiono uncoalesce. - La aplicación YARN completada (
yarn application -list -appStates ALL) y la lista de al menos dos hosts distintos que procesaron alguna partición (de ahí se deduce cuántos ejecutores remotos trabajaron). - El resultado de negocio (beneficio neto por año de
web_sales) obtenido en local con Spark SQL y el mismo resultado obtenido sobre YARN, comprobando que coinciden. - Que sabes explicar, con tus propias palabras, la diferencia entre una partición de ejecución de Spark, una partición Hive y un bloque HDFS.
Memoria escrita (una o dos páginas)
Trae también un documento breve —una o dos páginas, no hace falta más— que
no se limite a pegar capturas de las salidas anteriores: debe explicar con
tus propias palabras qué papel tienen el driver, los ejecutores y el gestor
de recursos, y qué cambia entre local[2] y YARN; la diferencia entre una
transformación y una acción, y qué se lee en un plan de explain; qué es
una partición de ejecución y en qué se distingue de un fichero Parquet, de
un bloque HDFS y de una partición Hive; y por qué el resultado de negocio
es el mismo en local y sobre YARN.
Qué es importante de cara al examen final
El examen no pide recordar la sintaxis exacta de una función. Debes poder explicar:
- qué hacen el driver, los ejecutores y el gestor de recursos, y qué son un job, una stage y una task;
- la evaluación perezosa: qué es una transformación, qué es una acción y por qué Spark construye un plan antes de ejecutar;
- la diferencia entre dependencias estrechas y anchas, qué es un shuffle y qué operaciones lo provocan;
- qué se comprueba en un plan: selección de columnas, filtros empujados a
la lectura y tipo de
join(incluido el broadcast join); - qué controlan
repartition,coalesceyspark.sql.shuffle.partitions, qué decide por sí solo AQE y por qué importan los ficheros pequeños; - cuándo compensa persistir un DataFrame y por qué una UDF de Python es más lenta que una función integrada;
- la diferencia entre contar líneas de venta y contar pedidos distintos.
Siguiente paso
S4 enseña Spark como motor. S5 utilizará ese motor para crear una tabla refinada como colección de Parquet particionados. Todavía se conservará una zona fuente inmutable y no se presentará la salida como una tabla gestionada.