Sesión 2 — Exploración de TPC-DS en Parquet sobre HDFS
En esta sesión se empieza a trabajar con un conjunto de datos de aspecto empresarial. El objetivo es separar tres ideas que a menudo se confunden:
- los datos almacenados físicamente en un sistema distribuido;
- el formato de los ficheros que contienen esos datos;
- el catálogo que permite dar a esos ficheros un nombre de tabla y un esquema.
El conjunto de datos combina TPC-DS SF1, generado de forma determinista,
con la relación oficial de municipios del Instituto Nacional de Estadística
(INE). La instantánea municipal se distribuye comprimida en entorno/data/ine;
en HDFS se conserva como CSV comprimido en
/datalake/raw/ine/municipios y las tablas de negocio adaptadas como Parquet
en /datalake/raw/tpcds. Primero se leerán los ficheros directamente con
WebHDFS, fsspec, PyArrow y Polars. Después se utilizará DuckDB como motor SQL
local que lee esos mismos ficheros. En
una sesión posterior se incorporará Spark y, más adelante, Iceberg,
particiones y optimizaciones.
Objetivos
Al terminar la sesión deberías poder:
- arrancar el clúster Hadoop y los servicios de catálogo que proporcionan los ficheros de ejemplo;
- explicar la diferencia entre un data lake, un data warehouse y un catálogo;
- explicar la función de las capas raw, silver y gold;
- localizar en HDFS las fuentes de TPC-DS y del INE y reconocer sus formatos;
- explicar cómo se normaliza una fuente pública y se cruza con un dataset sintético mediante una regla determinista;
- interpretar un esquema de columnas con tipos numéricos, fechas, cadenas y decimales;
- acceder a HDFS desde Python mediante WebHDFS sin instalar un cliente nativo de Hadoop;
- seleccionar columnas y filtrar filas con PyArrow y Polars;
- lanzar consultas SQL con DuckDB sobre una colección de ficheros remotos;
- distinguir una operación que lee los datos de otra que solo consulta metadatos;
- dejar el entorno preparado para las siguientes sesiones.
Dónde se ejecuta este notebook. A partir de esta sesión, Jupyter se ejecuta directamente dentro del contenedor
namenode, comoluser, con acceso de red directo a HDFS y WebHDFS. El servidor Jupyter se arranca a mano desde una terminal de tu equipo; la sección siguiente, «Antes de empezar: Jupyter ennamenode», explica cómo hacerlo y cómo conectar este notebook. Las celdas ejecutables hablan directamente con el clúster. Las órdenes que necesitan el Docker del host — arrancar o detener contenedores,make, borrados deliberados de datos — se muestran como texto para ejecutarlas en una terminal de tu equipo, no como celdas: el kernel de este notebook no tiene el socket de Docker. Esta misma arquitectura se mantendrá en las sesiones siguientes.
Cómo se evalúa el trabajo de esta sesión. Esta sesión también termina con una sección «Evidencias para la siguiente sesión». En una sesión posterior tendrás una reunión individual de unos 5 minutos con el profesor en la que deberás mostrar en vivo, en tu propio ordenador, el datalake resultante (rutas, ficheros y resultados de las consultas) y entregar una memoria breve (una o dos páginas) que explique lo realizado. Esa misma sección indica también qué conceptos de esta sesión son relevantes para el examen final.
Paquetes de Python de esta sesión. Esta sesión necesita
duckdb,fsspec,polars,pyarrow,requests,trino. Es la primera sesión cuyo kernel se ejecuta dentro denamenode, así que todos son nuevos respecto a S1. Se instalan en el kernel denamenodeen la sección «Preparar Python»: una celda%%writefile requirements.txtcrea el fichero dentro del contenedor —elrequirements.txtde tu copia des2/está en tu equipo ynamenodeno lo ve— y otra ejecuta%pip install -r requirements.txt. La imagen denamenodeya trae estos paquetes en su entorno Python del curso,/opt/tcdm/venv, que es el intérprete del kernel y donde instala%pip; lo normal es que%pipsólo confirme que están; ejecuta esas celdas de todos modos: dejan explícito qué necesita la sesión y reparan el entorno si falta algo.
Antes de empezar: Jupyter en namenode
En S1 el kernel era un Python local que Visual Studio Code arrancaba por su
cuenta y no hizo falta lanzar ningún servidor Jupyter. Desde esta sesión el
kernel se ejecuta dentro del contenedor namenode, como luser, donde
VS Code no puede arrancarlo: hay que lanzar a mano un servidor Jupyter en
namenode y conectar este notebook a él. Es lo primero que se hace. Una vez
conectado puedes
ejecutarlo de arriba abajo —diapositivas, explicación de Trino, arranque del
warehouse y generación de los datos— sin volver a tocar Jupyter. Estos pasos
están al principio para que también puedas leerlos en la versión HTML
publicada, antes de tener ningún kernel conectado.
Dónde se ejecuta cada orden
Desde esta sesión hay tres lugares donde se ejecutan órdenes. Conviene distinguirlos antes de empezar:
| Dónde | Cómo aparece en este notebook | Para qué se usa |
|---|---|---|
| Terminal de tu equipo | Bloques de texto bash marcados «en una terminal de tu equipo» |
make, docker compose, docker exec: arrancar, parar y borrar contenedores |
| Celdas de código de este notebook | Celdas ejecutables; las que empiezan por ! lanzan una orden de shell |
Se ejecutan dentro de namenode como luser: hdfs dfs ..., Python, consultas a Trino |
| Otro contenedor, desde tu equipo | docker exec <contenedor> ... en un bloque de texto |
Entrar en un contenedor concreto, por ejemplo en el cliente de Trino |
A diferencia de S1, aquí !hdfs dfs -ls / funciona sin docker exec: el
kernel ya está dentro de namenode. Al revés, este notebook no puede usar
docker, porque el contenedor no tiene acceso al Docker de tu equipo.
Arrancar el clúster
Abre una terminal de tu equipo (en Windows, la terminal de Ubuntu de WSL2
que preparaste en S1) y sitúate en la raíz de la distribución: el directorio
que contiene s1/, s2/ y entorno/. Actualiza la copia, porque esta sesión
añade s2/ y los ficheros de entorno/ del warehouse, y arranca el clúster
de S1:
cd ~/tcdm-public
git pull
make -C entorno hadoop-up
-C entorno hace que make use entorno/Makefile sin cambiar de
directorio. El objetivo hadoop-up crea la red Docker compartida
hadoop-cluster si todavía no existe y arranca namenode y los tres
DataNodes. Si el clúster de S1 sigue en marcha no hace nada; si lo habías
parado, lo arranca de nuevo con los mismos volúmenes HDFS, de modo que los
datos de S1 se conservan.
El equivalente sin Makefile, también desde la raíz de la distribución, es:
docker network inspect hadoop-cluster >/dev/null 2>&1 || docker network create hadoop-cluster
docker compose -f entorno/compose-hadoop-cluster.yml up -d
Arrancar Jupyter dentro de namenode
La imagen de namenode trae instalados Jupyter Lab, Python, PySpark y las
bibliotecas del curso en el entorno /opt/tcdm/venv, pero el servidor no
arranca solo: hay que entrar en el contenedor y lanzarlo.
Abre otra terminal de tu equipo y entra en el contenedor namenode:
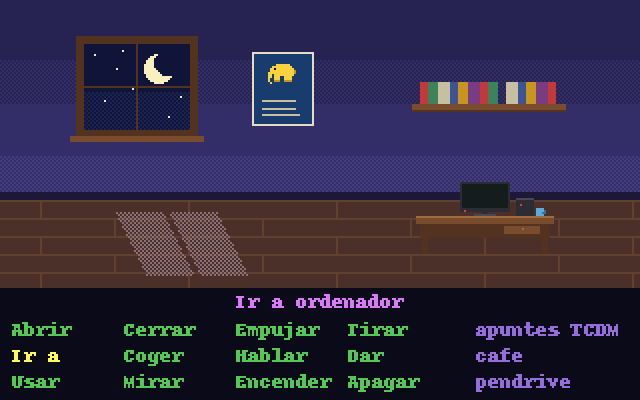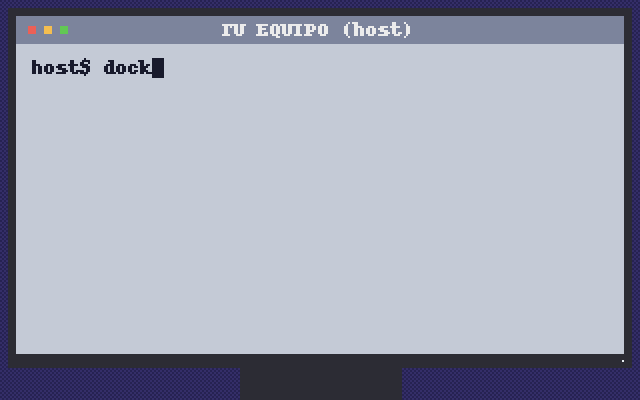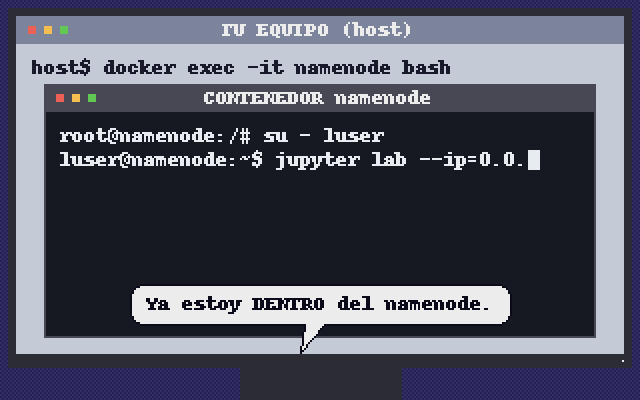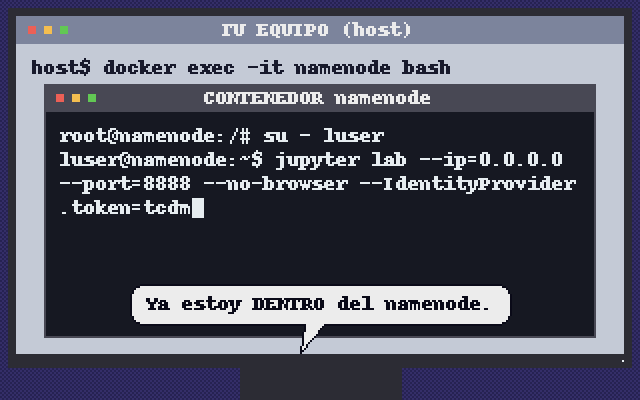
docker exec -it namenode bash
docker exec -it abre una shell interactiva dentro del contenedor: a
partir de aquí esa terminal ya no está en tu equipo, sino en namenode, y el
indicador lo muestra (root@namenode). Ahí dentro, cambia al usuario de
trabajo y arranca Jupyter Lab:
su - luser
jupyter lab --ip=0.0.0.0 --port=8888 --no-browser --IdentityProvider.token=tcdm
su - luser abre una shell de login de luser, que carga
/etc/profile.d/tcdm-python.sh y pone /opt/tcdm/venv/bin al principio del
PATH: por eso jupyter es el del entorno Python del curso, que ya trae
PySpark y las bibliotecas de las sesiones (command -v jupyter lo muestra).
--ip=0.0.0.0 hace que Jupyter escuche en la red del contenedor, y
compose-hadoop-cluster.yml publica su puerto 8888 en 127.0.0.1 de tu
equipo. El token es la contraseña que VS Code envía al servidor al conectarse;
--IdentityProvider.token=tcdm lo fija en tcdm. Sin esa opción Jupyter
genera un token aleatorio distinto en cada arranque y habría que copiarlo de
sus mensajes; con ella la dirección de conexión es siempre la misma. Un token
tan simple es aceptable en este laboratorio porque el puerto
sólo se publica en 127.0.0.1: únicamente se puede llegar a él desde tu
propio equipo.
Jupyter queda en primer plano: deja esa terminal abierta mientras
trabajes. Ctrl+C lo detiene y dos exit te devuelven a tu equipo. El
servidor, el kernel y todas las celdas del notebook se ejecutan así dentro de
namenode; en tu equipo sólo quedan Visual Studio Code y el fichero del
notebook. entorno/Makefile ofrece el atajo make -C entorno jupyter, que
hace lo mismo en una sola orden
(docker exec -it namenode su - luser -c 'jupyter lab ...'), pero conviene
conocer los pasos anteriores para saber dónde se ejecuta cada cosa.
Jupyter muestra también direcciones que usan el nombre namenode: sólo
funcionan dentro de la red Docker. Para conectar desde tu equipo se usa la
que empieza por 127.0.0.1:
http://127.0.0.1:8888/lab?token=tcdm
Conectar este notebook con Jupyter
- En Visual Studio Code, abre este
s2.ipynbdesde tu copia de la distribución (en Windows, dentro de WSL2, como en S1). El fichero sigue en tu equipo; sólo el kernel se ejecuta en el contenedor. - Pulsa Select Kernel → Select Another Kernel → Existing Jupyter
Server, pega la dirección
http://127.0.0.1:8888/lab?token=tcdmy elige el kernel Python 3 (ipykernel). - Ejecuta las celdas de código en orden. La comprobación de la sección
«Preparar Python» confirma que se ejecutan en
namenodecomoluser.
A partir de aquí no hace falta nada más para seguir el notebook: las diapositivas y la explicación de Trino se pueden ejecutar ya, y los servicios del warehouse (PostgreSQL, Hive Metastore y Trino) se arrancan más adelante, en «Arrancar los servicios del warehouse», desde una terminal de tu equipo y con Jupyter ya en marcha.
Dos consecuencias de esta arquitectura:
- El directorio de trabajo del kernel está dentro de
namenode, no en tu carpetas2/. Los ficheros que crea el notebook (requirements.txt, lo que se escribe en/tmp...) quedan en el contenedor, y el notebook no puede leer elentorno/ni els2/de tu equipo: por eso crearequirements.txtcon%%writefiley descarga del repositorio público la instantánea del INE. - Jupyter vive mientras siga en marcha la orden que lo lanzó. Si cierras esa
terminal, pulsas
Ctrl+Co paras los contenedores (make -C entorno stop), el servidor se detiene. Vuelve a arrancarlo como arriba (docker exec -it namenode bash,su - luser,jupyter lab ...) y reconecta el kernel con la misma dirección, porque el token es siempretcdm. Las variables y losimportdel kernel anterior se pierden: vuelve a ejecutar las celdas de las que dependa la sección en la que estés.
Diapositivas de la sesión
Las diapositivas se generan con el paquete jupyter-notebook-slide.
El alias %%diapositiva permite mantener en español los tipos usados en la sesión y produce la misma salida HTML en Jupyter, Colab y la referencia HTML publicada.
En cada sesión encontrarás varios tipos de diapositivas que te ayudarán a seguir el hilo:
- Sección (
titulo): abre la sesión y resume qué vamos a ver y qué haremos. - A continuación (
avance): anuncia el contenido de la parte siguiente, para saber en qué punto del programa estamos. - Recapitulación (
resumen): condensa la parte anterior en puntos clave para recordarlos y revisarlos después. - Pregunta guía (
pregunta): plantea cuestiones que orientan lo que viene a continuación; conviene intentar responderlas antes de seguir. - Evaluación de la sesión (
evaluacion): recuerda cómo se evalúa el trabajo de esta sesión.
%pip install -q "jupyter-notebook-slide @ git+https://github.com/dsevilla/jupyter-notebook-slide.git"
%load_ext notebook_slide

import notebook_slide as jnbs

# Colores de 26-27/teoria/tcdm.css, adaptados al tema de las sesiones.
jnbs.configure(
    background="#eaf2f8",
    foreground="#1f2933",
    border="#c9d6e1",
    heading="#0c304d",
    subheading="#0c304d",
    link="#174f7a",
    code_background="#eaf2f8",
    code_foreground="#0c304d",
    quote_background="#ffffff",
    font_family="Atkinson Hyperlegible, Inter, Aptos, Segoe UI, Helvetica, Arial, sans-serif",
    font_url="https://fonts.googleapis.com/css2?family=Atkinson+Hyperlegible:ital,wght@0,400;0,700;1,400;1,700&display=swap",
)
jnbs.register_slide_type("avance", "A continuación", "#174f7a")
jnbs.register_slide_type("resumen", "Recapitulación", "#a54467")
jnbs.register_slide_type("pregunta", "Pregunta guía", "#0c304d")
jnbs.register_slide_type("evaluacion", "Evaluación de la sesión", "#b3701a")
jnbs.register_slide_type(
    "titulo",
    "Sección",
    "#174f7a",
    layout="title",
    background="linear-gradient(135deg, #0c304d, #174f7a 62%, #a54467)",
    foreground="#ffffff",
    border="transparent",
    heading="#ffffff",
    subheading="#dceaf4",
)
jnbs.register_alias("diapositiva")
Data lakes y arquitectura medallion
Un data warehouse clásico exige definir el esquema antes de cargar datos (schema-on-write): sólo entra lo que ya encaja en tablas relacionales diseñadas de antemano. Un data lake invierte esa exigencia: guarda los ficheros tal como llegan de sus fuentes —Parquet, CSV, JSON, imágenes…— en un sistema de ficheros distribuido barato (aquí HDFS, aunque también veremos que se usa S3 de Amazon Web Services, Azure Data Lake, etc.) y pospone la interpretación del esquema al momento de leer (schema-on-read). Eso permite conservar el dato original, incorporar fuentes muy distintas sin negociar antes un esquema común, y reprocesar el histórico completo si cambia una regla de negocio — algo que un warehouse tradicional no permite, porque ya ha transformado o descartado el original al cargarlo.
Ese margen tiene un coste: sin ninguna disciplina adicional, un data lake puede degenerar en un «data swamp» (pantano de datos), donde nadie sabe qué fichero es fiable, qué esquema tiene o si está duplicado. La arquitectura medallion — descrita por Databricks pero aplicable con cualquier motor, incluido el de este curso — responde a ese problema organizando el lake en capas de calidad creciente, cada una con un contrato claro sobre lo que contiene:
| Capa | Qué guarda | Cómo se llega | Para qué sirve |
|---|---|---|---|
raw (bronze) |
Copia fiel de la fuente, en su formato e idioma original | Ingesta directa: copia o conversión de formato sin reinterpretar el contenido | Reproducibilidad: si cambia una regla de negocio, se reprocesa desde aquí sin volver a pedir el dato a la fuente |
silver |
Datos validados: tipos correctos, duplicados resueltos, claves de negocio unidas entre fuentes | Limpieza y JOIN: validar, tipar, deduplicar, enriquecer |
Base común y reutilizable para varios consumidores, sin repetir la limpieza en cada consulta |
gold |
Agregados y modelos orientados a una pregunta de negocio concreta (por ejemplo, ventas por región y mes) | Agregación y modelado sobre silver, normalmente ya como tabla de hechos/dimensión |
Consumo directo: cuadros de mando, informes, modelos de aprendizaje automático |
Tres ideas quedan sujetas a esta separación:
- Cada capa tiene un único responsable de su contrato. Quien escribe
silverno necesita conocer el origen concreto de cada fuente enraw, sólo su contrato; quien consumegoldno necesita saber qué limpieza produjosilver. - El fallo se aísla. Si una agregación de
goldtiene un error, se corrige y se recalcula sin tocarrawnisilver. Si aparece un dato corrupto ensilver,rawconserva el original para diagnosticarlo. - No es una jerarquía de directorios obligatoria, es un compromiso de
calidad. Nada impide leer directamente
rawpara explorar o depurar — esta misma sesión lo hace —; medallion no lo prohíbe, sólo indica qué garantías puede asumir cada capa antes de construir algo encima de ella.
Esta sesión sólo llega hasta raw: TPC-DS y la instantánea del INE se
materializan tal cual en /datalake/raw/tpcds y
/datalake/raw/ine/municipios, sin deduplicar ni agregar nada todavía. La
sesión 5 construye silver (datos enriquecidos y particionados, por
ejemplo por año y mes de venta) y gold (agregados de negocio) a partir de
estos mismos ficheros. El diagrama de la sección siguiente sitúa estas
capas dentro de /datalake.
Para profundizar
- Armbrust, M., Ghodsi, A., Xin, R. y Zaharia, M. «Lakehouse: A New Generation of Open Platforms that Unify Data Warehousing and Advanced Analytics». CIDR 2021. El artículo académico que sistematiza la arquitectura lakehouse — un data lake con garantías transaccionales y de esquema propias de un warehouse — sobre la que se apoya el patrón medallion; no usa ese término, pero es su fundamento técnico.
- Serra, J. Deciphering Data Architectures: Choosing Between a Modern Data Warehouse, Data Fabric, Data Lakehouse, and Data Mesh. O'Reilly, 2024. Compara warehouse, data lake, lakehouse y data mesh, y sitúa las capas raw/silver/gold dentro de esas decisiones arquitectónicas más amplias.
- Databricks. «What is the medallion lakehouse architecture?». El origen del término y de la definición de las tres capas que sigue este notebook.
- Microsoft. «Implement medallion lakehouse architecture in Fabric». La misma arquitectura aplicada a OneLake y Microsoft Fabric: cada capa como un lakehouse distinto dentro del mismo data lake lógico.
- Google Cloud. «What is medallion data architecture?». La perspectiva de Google Cloud, con BigQuery y Dataplex como motores de cada capa.
- AWS. «Building medallion architecture with Iceberg materialized views in Amazon SageMaker». Un ejemplo de AWS que aplica el patrón sobre tablas Iceberg, el mismo formato de tabla que se introducirá en las sesiones 7–8 de este curso.
Los tres proveedores usan nombres de servicio distintos, pero el mismo contrato de capas: raw/bronze inmutable, silver validado y gold orientado a consumo. Esta sesión aplica el mismo patrón sin atarlo a un proveedor concreto: HDFS y Trino cumplen aquí el papel que en la nube ocupan S3/Glue, OneLake/Fabric o Cloud Storage/BigQuery.
Qué es Trino
Trino (antes PrestoSQL) es un motor de consultas SQL
distribuido para federar datos: no almacena sus propias tablas, sino que
se conecta a orígenes heterogéneos a través de conectores — HDFS/Hive,
Iceberg, PostgreSQL, Kafka, un generador sintético como TPC-DS, entre
muchos otros — y los expone
bajo el mismo dialecto SQL ANSI. Una sola consulta puede combinar en el
mismo JOIN tablas que viven en conectores distintos, algo que ni HDFS ni
Hive Metastore permiten por separado.
Internamente separa dos roles: un coordinator que analiza y planifica cada consulta, y uno o varios workers que ejecutan las tareas en paralelo (arquitectura MPP, massively parallel processing). Esta sesión despliega un único contenedor que asume ambos roles, suficiente para SF1; en un despliegue de producción coordinator y workers suelen escalar por separado.
Esta sesión usa dos de sus conectores:
tpcds: no lee ningún fichero, genera bajo demanda filas deterministas del benchmark TPC-DS en la escala solicitada (tiny,sf1,sf10…). Es el origen de los datos de negocio.hive: permite crear tablas externas sobre HDFS (aquí, en formato Parquet) y registrar su definición en Hive Metastore, el almacén de metadatos de Hive. La sesión lo usa para escribir en HDFS el resultado de cruzartpcdscon el CSV del INE.
Cada conector se activa con un fichero de propiedades bajo
entorno/trino-hdfs/etc/catalog/:
# tpcds.properties
connector.name=tpcds

# hive.properties
connector.name=hive
hive.metastore=thrift
hive.metastore.uri=thrift://hive-metastore:9083
hive.metastore.authentication.type=NONE
hive.metastore.thrift.impersonation.enabled=false
hive.hdfs.authentication.type=NONE
hive.hdfs.impersonation.enabled=false
hive.non-managed-table-creates-enabled=true
hive.non-managed-table-writes-enabled=true
hive.storage-format=PARQUET
hive.compression-codec=ZSTD
fs.hadoop.enabled=true
Las propiedades *.authentication.type=NONE y *.impersonation.enabled=false
desactivan Kerberos y la suplantación de usuario: todos los accesos —desde
Trino, y más adelante desde Spark— usan la identidad luser directamente,
sin un usuario intermedio que autentique en su nombre. Las dos propiedades
hive.non-managed-table-*-enabled=true son las que permiten crear y escribir
tablas externas (no administradas por Hive) con CREATE TABLE ... AS SELECT;
sin ellas, el CREATE TABLE ... WITH (external_location = ...) que usa esta
sesión fallaría.
Trino se despliega como un servicio Docker más, definido en
entorno/compose-warehouse-hdfs.yml:
trino-hdfs:
  image: trinodb/trino:${TRINO_VERSION:-483}
  depends_on:
    hive-metastore:
      condition: service_healthy
  volumes:
    - ./trino-hdfs/etc:/etc/trino:ro
  networks:
    hadoop-cluster:
El volumen monta ese directorio de catálogos como /etc/trino dentro del
contenedor; depends_on obliga a esperar a que Hive Metastore responda
antes de arrancar, porque el conector hive lo necesita para resolver
esquemas y tablas. La sección «Arrancar los servicios del warehouse» muestra cómo se
levanta junto con el resto de servicios del laboratorio.
TPC-DS y la escala SF1
TPC-DS es un benchmark de apoyo a sistemas analíticos. Modela una empresa de venta minorista que vende productos a través de tiendas físicas, catálogos y una web. Incluye tablas de dimensiones, como clientes, productos, fechas y tiendas, y tablas de hechos, como ventas y devoluciones. Las tablas de hechos contienen muchas filas y se relacionan con las dimensiones mediante claves surrogadas.
La escala que se utilizará es TPC-DS SF1, donde sf significa scale
factor. El servicio Trino incorpora un conector que genera las
tablas virtuales de TPC-DS, y la sesión las materializa después en
Parquet.
El factor de escala expresa aproximadamente gigabytes de datos sin
comprimir generados, no el tamaño final de los ficheros Parquet. El
conector TPC-DS de Trino
ofrece tiny (SF 0,01), sf1, sf10, sf100, sf300, sf1000,
sf3000, sf10000, sf30000 y sf100000. En resultados oficiales del
benchmark, la especificación TPC-DS
4.0.0
define como escalas publicables SF1000, SF3000, SF10000, SF30000 y
SF100000; las menores son muy útiles para desarrollo y docencia.
A partir de los 261 MiB medidos en este entorno, una extrapolación lineal orientativa da los siguientes tamaños. No es una garantía: algunas dimensiones no crecen linealmente y la compresión puede cambiar con la cardinalidad y la distribución de los ficheros.
| Esquema de Trino | Volumen nominal sin comprimir | Parquet estimado | Con tres réplicas HDFS |
|---|---|---|---|
tiny |
0,01 GB | no extrapolable con fiabilidad | no extrapolable |
sf1 |
1 GB | 261 MiB medidos | 783 MiB medidos |
sf10 |
10 GB | 2,5 GiB | 7,6 GiB |
sf100 |
100 GB | 25 GiB | 76 GiB |
sf300 |
300 GB | 76 GiB | 229 GiB |
sf1000 |
1 TB | 255 GiB | 765 GiB |
sf3000 |
3 TB | 0,75 TiB | 2,2 TiB |
sf10000 |
10 TB | 2,5 TiB | 7,5 TiB |
sf30000 |
30 TB | 7,5 TiB | 22 TiB |
sf100000 |
100 TB | 25 TiB | 75 TiB |
SF1 es suficientemente grande para que se aprecien las ventajas del formato columnar y de la lectura selectiva, pero permite trabajar en un ordenador docente razonable. En la ejecución de referencia se obtuvieron los siguientes volúmenes lógicos:
| Tabla | Filas aproximadas en SF1 | Papel | Descripción breve |
|---|---|---|---|
call_center |
6 | dimensión | Centros de atención telefónica y su organización. |
catalog_page |
11.718 | dimensión | Páginas de los catálogos comerciales. |
catalog_returns |
144.067 | hecho | Devoluciones de compras realizadas mediante catálogo. |
catalog_sales |
1.441.548 | hecho | Líneas de pedidos realizados mediante catálogo. |
customer |
100.000 | dimensión | Clientes y referencias a sus datos asociados. |
customer_address |
50.000 | dimensión | Domicilios sintéticos de los clientes. |
customer_demographics |
1.920.800 | dimensión | Características demográficas de los clientes. |
date_dim |
73.049 | dimensión | Calendario con fechas y atributos temporales. |
household_demographics |
7.200 | dimensión | Datos agregados del hogar y potencial de compra. |
income_band |
20 | dimensión | Límites de los tramos de ingresos. |
inventory |
11.745.000 | hecho de inventario | Existencias diarias por producto y almacén. |
item |
18.000 | dimensión | Productos, precios, marcas y categorías. |
promotion |
300 | dimensión | Promociones, descuentos y canales publicitarios. |
reason |
75 | dimensión | Motivos utilizados en las devoluciones. |
ship_mode |
20 | dimensión | Modos de transporte y sus operadores. |
store |
12 | dimensión | Tiendas físicas, localización y organización. |
store_returns |
287.514 | hecho | Devoluciones realizadas en tiendas. |
store_sales |
2.880.404 | hecho | Líneas de ventas realizadas en tiendas. |
time_dim |
86.400 | dimensión | Instantes del día y clasificación horaria. |
warehouse |
5 | dimensión | Almacenes de distribución y localización. |
web_page |
60 | dimensión | Páginas de los sitios web comerciales. |
web_returns |
71.763 | hecho | Devoluciones de compras realizadas por web. |
web_sales |
719.384 | hecho | Líneas de pedidos realizados por web. |
web_site |
30 | dimensión | Sitios web, empresas y localización. |
Estos valores sirven como comprobación aproximada. Las filas son deterministas para una misma versión del generador y una misma escala, pero el número de ficheros, el tamaño exacto de cada fichero y la distribución de los bloques pueden cambiar si cambia Trino, Hadoop o el paralelismo usado durante la escritura.
La ejecución de referencia ocupó aproximadamente 261 MiB en Parquet ya comprimido —el tamaño lógico que muestra HDFS— y 783 MiB contando tres réplicas. Aunque ocupa poco en disco, reúne unas 19,6 millones de filas entre las 24 tablas.
El esquema completo de columnas, tipos y claves de estas 24 tablas se reproduce íntegro en el apéndice final de esta sesión.
Arquitectura de la sesión
La ruta de datos es:
TPC-DS virtual de Trino          Excel anual del INE
          │                              │
          │                     normalización a CSV UTF-8
          │                              ▼
          │                 raw/ine/municipios/municipios-2026.csv.gz
          │                              │
          └──────── JOIN determinista ───┘
                         │
                         │ CTAS en formato PARQUET
                         ▼
HDFS /datalake/
          ├── raw/ine/municipios/       ← fuente pública versionada
          ├── raw/tpcds/<tabla>/        ← datos de negocio adaptados
          ├── silver/tpcds/<tabla>/     ← datos refinados en Sesión 5
          └── gold/tpcds/<producto>/    ← datos preparados para consumo

HDFS /datalake/raw/tpcds/<tabla>/
          │
          ├── lectura directa con WebHDFS + fsspec + PyArrow
          ├── lectura directa con WebHDFS + fsspec + Polars
          └── lectura SQL con DuckDB
tpcds identifica la fuente principal y contiene un directorio por tabla.
ine/municipios conserva por separado la segunda fuente empleada para
adaptar la geografía. El notebook fija esas ubicaciones; Trino escribe
los fragmentos, pero no impone los nombres de las capas.
La capa y la partición son niveles distintos. Una futura versión refinada
de web_sales podrá escribirse, por ejemplo, como:
/datalake/silver/tpcds/web_sales/
└── sold_year=2000/
    └── sold_month=1/
        └── part-....parquet
El notebook utiliza Trino como lector, motor del JOIN y escritor.
Registra temporalmente el CSV del INE, crea una tabla externa para
cada Parquet mediante CREATE TABLE AS SELECT y elimina después esas
definiciones. Los ficheros quedan en HDFS, pero todavía no existe un catálogo
permanente para ellos.
Trino no guarda esquemas ni ubicaciones por su cuenta: para resolver
hive.tpcds_bootstrap.customer necesita un catálogo externo que le diga
qué columnas tiene esa tabla y en qué ruta de HDFS están sus ficheros. Ese
catálogo es Hive Metastore: un servicio que sólo guarda esos metadatos
—nombre, esquema, formato y ubicación— en PostgreSQL; nunca copia ni lee
los datos. "Externa" significa que la tabla es sólo esa entrada de
catálogo apuntando a ficheros que ya existían: borrarla borra la
definición, no los Parquet de HDFS. Por eso esta sesión puede crear y
eliminar tablas libremente sin arriesgar los datos.
Más adelante se usará el mismo Hive Metastore para registrar tablas
administradas en /warehouse, donde sí es el catálogo quien controla el
ciclo de vida de los ficheros; Iceberg añadirá snapshots y evolución sobre
ese mismo esquema. Cómo se organiza y consulta ese catálogo en detalle es
tema de una sesión posterior: aquí basta con reconocer para qué sirve
cada vez que aparezca.
La sección «Data lakes y arquitectura medallion» explica por qué se
organiza el data lake en capas raw → silver → gold; aquí el diagrama
sólo muestra su aplicación concreta en esta sesión.
La instantánea tiene extensión .gz también en HDFS. Hadoop y Trino
reconocen la compresión por la extensión del fichero; cuando se lee
el flujo desde Python hay que abrirlo con gzip.
Arrancar los servicios del warehouse
Con Jupyter conectado, falta añadir al clúster los servicios que alimentan
esta sesión: PostgreSQL, Hive Metastore y Trino. Este notebook no puede
arrancarlos —el contenedor no tiene acceso al Docker de tu equipo—, así que se
arrancan desde una terminal de tu equipo, en la raíz de la distribución.
Usa la terminal de git pull y hadoop-up, no la que ejecuta Jupyter, que
debe seguir abierta:
make -C entorno warehouse-up
El objetivo warehouse-up realiza dos acciones: ejecuta hadoop-up, para
asegurarse de que namenode y los tres DataNodes están arrancados (si ya lo
están, no los toca), y arranca PostgreSQL, Hive Metastore y Trino. Los
servicios adicionales no son nodos YARN ni almacenan bloques HDFS; son
clientes y servicios de catálogo conectados a la red hadoop-cluster. La
primera vez construye la imagen del metastore y descarga las de PostgreSQL y
Trino, así que puede tardar varios minutos.
Se puede repetir en cualquier momento mientras el clúster esté en marcha:
Docker Compose sólo crea o arranca lo que falta o ha cambiado, y el Compose del
clúster es el mismo desde S1, así que namenode, los DataNodes y Jupyter
siguen como están. Tampoco genera datos, sólo arranca servicios: los Parquet
los escriben más adelante las celdas de este notebook mediante Trino.
El equivalente sin Makefile, también desde la raíz de la distribución, es:
docker network inspect hadoop-cluster >/dev/null 2>&1 || docker network create hadoop-cluster
docker compose -f entorno/compose-hadoop-cluster.yml up -d
docker compose -f entorno/compose-warehouse-hdfs.yml up -d --build
Comprueba que los contenedores están arrancados:
make -C entorno status
En la salida deben aparecer namenode, datanode1, datanode2,
datanode3, postgresql-metastore, hive-metastore y trino-hdfs. El
contenedor catalog-init es una tarea corta y puede aparecer como
terminado correctamente; no debe confundirse con un servicio que tenga que
permanecer ejecutándose. Si tu copia incluye ya la sesión 3, status muestra
además una tabla vacía para su Compose: es normal, esos servicios se
arrancan en esa sesión.
Generar los Parquet de TPC-DS
A partir de aquí la preparación ocurre dentro del propio notebook. Primero
instalaremos sus dependencias y prepararemos en HDFS la instantánea
comprimida del INE que ya se entrega en entorno/data/ine. Después
enviaremos a Trino las consultas
que materializan las 24 tablas de negocio de tpcds.sf1 como Parquet.
El proceso completo, que ocupan las siguientes subsecciones, es:
- Preparar Python: crear
requirements.txt, instalar con%piplas dependencias de la sesión, incluido el cliente Trino, y comprobar que el kernel se ejecuta ennamenode. - Publicar el INE en HDFS: subir la instantánea CSV comprimida a
raw/ine/municipios. - Conectar con Trino: abrir la conexión y esperar a que el servicio responda.
- Almacenar temporalmente el CSV en Hive Metastore: registrar el CSV del INE como tabla externa Hive y crear una vista con una posición estable por municipio.
- Construir las consultas de localización: generar, para las cinco
dimensiones geográficas, el
SELECTque sustituye ciudad, condado, estado y país por el municipio español correspondiente. - Materializar las 24 tablas: ejecutar un
CREATE TABLE … AS SELECT(CTAS) por tabla detpcds.sf1; Trino lee el conectortpcdsy escribe el resultado como Parquet en/datalake/raw/tpcds/<tabla>a través del conectorhive. - Validar y retirar los metadatos temporales: comprobar los
marcadores
_SUCCESSy eliminar la vista, la tabla CSV y el esquema temporal de Hive Metastore; los Parquet permanecen en HDFS.
Todo este proceso también está automatizado como make -C entorno tpcds-init
desde la raíz de la distribución (misma lógica, por línea de órdenes); aquí se hace paso a paso,
con cada consulta visible, para explicar qué construye cada una.
La tabla técnica dbgen_version se excluye: describe el generador y no es
parte del modelo de negocio. La generación puede tardar varios minutos. Los
marcadores _SUCCESS permiten volver a ejecutar el notebook sin reescribir
las tablas ya terminadas. Al finalizar, /datalake/raw/tpcds y
/datalake/raw/ine/municipios quedan preparados para las sesiones
posteriores.
Preparar Python
requirements.txt es la lista única de dependencias de S2: los lectores
Parquet (PyArrow, Polars, DuckDB y fsspec) y el cliente Python de Trino que
utilizaremos para crear los datos en HDFS. El notebook no supone que ese
fichero esté dentro del contenedor —tu copia de s2/requirements.txt está en
tu equipo y namenode no la ve—, así que la celda siguiente lo crea con
%%writefile en el directorio de trabajo del kernel, dentro de namenode.
Después, %pip install -r requirements.txt instala esas dependencias en el
mismo intérprete que ejecuta el kernel: el del entorno virtual del curso,
/opt/tcdm/venv, que la imagen de namenode incluye (ver S1, «Entorno
Python del curso»). Todos los %pip install de las sesiones acaban en ese
entorno. La imagen ya trae estas dependencias, por lo que lo normal es ver
sólo que están satisfechas; la celda deja
explícito qué necesita la sesión y repara el entorno si falta algo.
La última celda del grupo muestra dónde se ejecuta el kernel, qué intérprete
usa (sys.executable debe estar en /opt/tcdm/venv/bin) y las versiones
instaladas. Si falla alguna de sus dos comprobaciones, el notebook no está
conectado al Jupyter de namenode arrancado como se indica en «Antes de
empezar: Jupyter en namenode».
%%writefile requirements.txt
# Dependencias comunes de los lectores Parquet de la sesión 2.
# WebHDFS de fsspec utiliza requests para sus peticiones HTTP.
duckdb
# DuckDB consulta modified() al registrar WebHDFS como filesystem.
fsspec>=2026.2.0
polars
pyarrow
requests
# Cliente de Trino; se fija la serie mayor, igual que en S6-S8.
trino>=0.330,<1
%pip install -q -r requirements.txt
import getpass
import os
import socket
import sys
from importlib.metadata import version

print(f"Host: {socket.gethostname()}    usuario: {getpass.getuser()}")
print(f"Directorio de trabajo: {os.getcwd()}")
print(f"Intérprete: {sys.executable}")
for package in ("duckdb", "fsspec", "polars", "pyarrow", "requests", "trino"):
    print(f"{package:>10} {version(package)}")

assert socket.gethostname() == "namenode", "El kernel no se ejecuta dentro de namenode"
assert sys.executable.startswith("/opt/tcdm/venv/"), "El kernel no usa /opt/tcdm/venv"
Incorporar la relación de municipios del INE
Las localizaciones originales de TPC-DS son sintéticas y sus estados usan códigos estadounidenses de dos caracteres. El curso incorpora una segunda fuente: la Relación de municipios y códigos a 1 de enero de 2026 publicada por el Instituto Nacional de Estadística.
El libro contiene una hoja por provincia. Antes de distribuirlo se normaliza
a un único CSV UTF-8 y se entrega comprimido como
entorno/data/ine/municipios-2026.csv.gz. Ese mismo fichero se publica
en HDFS. Hadoop y Trino detectan gzip por la extensión; los lectores
Python descomprimen el flujo antes de pasarlo a Polars.
| Columna | Significado |
|---|---|
municipio_id |
Código INE de cinco dígitos. |
provincia_id |
Sus dos primeros dígitos; identifica la provincia. |
codigo_municipio |
Código dentro de la provincia. |
digito_control |
Permite detectar errores de escritura. |
municipio |
Denominación oficial. |
provincia |
Denominación de la provincia en el libro del INE. |
La relación puede cambiar si el INE publica una nueva edición. Por eso el
notebook no recalcula la relación: descarga la instantánea comprimida que
ya está versionada en entorno/data/ine. El contenedor namenode, donde
se ejecuta este notebook, no monta ese directorio, así que la celda la
obtiene del repositorio en lugar de leer una ruta local. El proceso de mantenimiento de esa instantánea se explica más adelante en
esta misma sección, después del flujo ejecutable, como referencia.
Una celda posterior comprueba esa instantánea y la copia comprimida a
/datalake/raw/ine/municipios. Trino la registra como tabla externa
temporal: el dato continúa siendo un fichero CSV gzip en HDFS y la
definición desaparece al terminar.
import gzip
from pathlib import Path
from urllib.request import Request, urlopen

# El notebook se ejecuta dentro del contenedor namenode, que no monta el
# directorio entorno/ de la distribución del alumnado: la instantánea se
# descarga del repositorio en vez de asumir una ruta local.
ine_url: str = (
    "https://raw.githubusercontent.com/dsevilla/tcdm-public/26-27/"
    "entorno/data/ine/municipios-2026.csv.gz"
)
compressed_csv: Path = Path("/tmp/ine/municipios-2026.csv.gz")
compressed_csv.parent.mkdir(parents=True, exist_ok=True)

request: Request = Request(ine_url, headers={"User-Agent": "Mozilla/5.0"})
with urlopen(request, timeout=30) as response:
    compressed_csv.write_bytes(response.read())

expected_header: str = (
    "municipio_id;provincia_id;codigo_municipio;" "digito_control;municipio;provincia"
)

# gzip.open descomprime mientras leemos; el CSV no se materializa en disco.
with gzip.open(compressed_csv, "rt", encoding="utf-8", newline="") as source:
    header: str = source.readline().rstrip("\n")
    municipality_count: int = sum(1 for _ in source)

assert header == expected_header
assert municipality_count == 8_132
print(f"Instantánea gzip descargada en {compressed_csv}: " f"{municipality_count:,} municipios")
Publicar la fuente del INE en HDFS
La celda anterior ha descargado la instantánea comprimida desde el
repositorio dsevilla/tcdm-public (rama 26-27,
entorno/data/ine/municipios-2026.csv.gz) a /tmp/ine dentro del
contenedor namenode: el notebook se ejecuta ahí y ese contenedor no
monta el directorio entorno de la distribución del alumnado. Después ha
leído la cabecera y ha recorrido el flujo para detectar una compresión
truncada y confirmar los 8.132 registros. No ha creado un CSV
descomprimido.
La orden siguiente conserva los bytes gzip en HDFS. Primero, -mkdir -p
crea el directorio raw/ine/municipios si aún no existe; después,
-put -f copia el fichero y permite repetir la celda sobrescribiendo la
misma instantánea; -ls -h muestra el nombre y el tamaño almacenado. La extensión .gz permite que Hadoop y
Trino descompriman el contenido al leerlo, de modo que no hace falta una
segunda copia sin comprimir. Este fichero es pequeño (8.132 filas), así
que el hecho de que gzip no sea divisible en varios bloques de lectura no
supone un problema; para grandes volúmenes conviene usar Parquet u otro
formato/codec que permita dividir el trabajo.
!hdfs dfs -mkdir -p /datalake/raw/ine/municipios
!hdfs dfs -put -f /tmp/ine/municipios-2026.csv.gz /datalake/raw/ine/municipios/municipios-2026.csv.gz
!hdfs dfs -ls -h /datalake/raw/ine/municipios
Conectar con Trino desde el notebook
Como se explicó en «Qué es Trino», el conector hive permite declarar una
tabla directamente sobre ficheros de un sistema de ficheros distribuido
(HDFS, S3…) indicando su ubicación y formato: es lo que haremos con el CSV
del INE y los Parquet de TPC-DS. Trino no copia esos ficheros; la definición
de cada tabla la guarda Hive Metastore, que a su vez la almacena en
PostgreSQL.
Trino expone TPC-DS como tablas virtuales deterministas. El cliente Python
envía SQL al servicio trino-hdfs; Hive Metastore sólo mantiene durante
la generación las definiciones externas necesarias para que Trino escriba
Parquet. La función siguiente muestra cada orden importante y devuelve sus
filas cuando se trata de una consulta. Si la celda agota los dos minutos de
espera sin que Trino responda, ve a «Solución de problemas», al final de
este notebook.
from time import sleep

from trino.dbapi import Connection, Cursor, connect

trino_connection: Connection = connect(host="trino-hdfs", port=8080, user="luser")


def trino_sql(sql: str, *, show: bool = True) -> list[list[object]]:
    if show:
        print(f"SQL> {sql}")
    cursor: Cursor = trino_connection.cursor()
    cursor.execute(sql)
    rows: list[list[object]] = cursor.fetchall()
    if show and rows:
        print(*rows[:10], sep="\n")
        if len(rows) > 10:
            print(f"… {len(rows) - 10} filas más")
    return rows


last_error: Exception | None = None
for attempt in range(1, 61):
    try:
        healthcheck: list[list[object]] = trino_sql("SELECT 1", show=False)
        assert len(healthcheck) == 1 and healthcheck[0][0] == 1
        print(f"Trino preparado después de {attempt} intento(s)")
        break
    except Exception as error:
        last_error = error
        sleep(2)
else:
    raise RuntimeError("Trino no respondió durante dos minutos") from last_error
Almacenado temporal del CSV en Hive Metastore
Un fichero en HDFS no es todavía una tabla. Creamos una definición Hive
externa sobre el CSV y una vista que asigna a cada municipio una posición
estable. Ambas definiciones se borrarán al terminar; el CSV permanecerá en
raw.
Antes hay que declarar dónde viven esas definiciones. tpcds_bootstrap es
un esquema (schema/database de Hive) de usar y tirar: sólo existe
mientras dura la generación de esta sesión y no es el catálogo permanente
que se construirá en una sesión posterior. Por convención de Hive, cada
esquema tiene un directorio por defecto bajo /warehouse con su nombre y
el sufijo .db —aquí /warehouse/tpcds_bootstrap.db— donde irían sus
tablas administradas si las tuviera; esta sesión sólo usa tablas externas,
así que ese directorio queda vacío. La celda siguiente lo crea
explícitamente por HDFS antes de CREATE SCHEMA, en vez de depender de
que el motor lo cree de forma implícita: es la misma orden que ya usa
entorno/init/initialize-catalogs.sh para el esquema tcdm al arrancar
el entorno.
!hdfs dfs -mkdir -p /warehouse/tpcds_bootstrap.db

trino_sql("CREATE SCHEMA IF NOT EXISTS hive.tpcds_bootstrap")
trino_sql("DROP VIEW IF EXISTS hive.tpcds_bootstrap.ine_municipios_ordenados")
trino_sql("DROP TABLE IF EXISTS hive.tpcds_bootstrap.ine_municipios")
trino_sql("""
CREATE TABLE hive.tpcds_bootstrap.ine_municipios (
    municipio_id varchar,
    provincia_id varchar,
    codigo_municipio varchar,
    digito_control varchar,
    municipio varchar,
    provincia varchar
) WITH (
    format = 'CSV',
    csv_separator = ';',
    skip_header_line_count = 1,
    external_location = 'hdfs://namenode:9000/datalake/raw/ine/municipios'
)
""")

# trino_sql() devuelve list[list[object]] porque una fila puede mezclar
# tipos de columna; aquí se sabe que la cuenta es un entero y se
# convierte explícitamente con int() en lugar de dejar un valor object.
municipality_count: int = int(
    trino_sql("SELECT count(*) FROM hive.tpcds_bootstrap.ine_municipios", show=False)[0][0]
)
assert municipality_count == 8_132
print(f"Trino lee {municipality_count:,} municipios")

trino_sql("""
CREATE VIEW hive.tpcds_bootstrap.ine_municipios_ordenados AS
SELECT
    row_number() OVER (ORDER BY municipio_id) AS posicion,
    count(*) OVER () AS total_municipios,
    municipio_id, provincia_id, municipio, provincia
FROM hive.tpcds_bootstrap.ine_municipios
""")
Unir las dos fuentes de forma determinista
Los 8.132 municipios se ordenan por municipio_id y reciben una posición
estable. Para cada pareja original ciudad–estado de TPC-DS se calcula
crc32(...); el resto de dividir por 8.132 selecciona siempre la misma fila:
JOIN ine_municipios_ordenados AS m
  ON m.posicion = 1 + mod(
      crc32(to_utf8(concat(
          coalesce(CAST(trim(a.ca_city) AS varchar), ''),
          '|',
          coalesce(CAST(trim(a.ca_state) AS varchar), '')
      ))),
      m.total_municipios
  )
El coalesce(..., '') importa: algunas localizaciones de TPC-DS traen
ca_city o ca_state vacíos, y concat con un valor NULL de por medio
devuelve NULL en vez de una cadena parcial. Sin el coalesce, esas filas
perderían el JOIN con el INE y su municipio quedaría sin asignar.
No se utiliza random(). La misma localización TPC-DS recibe el mismo
municipio aunque cambien el orden de lectura o los fragmentos Parquet. Las
claves ca_address_sk tampoco cambian, por lo que las ventas siguen
enlazando con la misma dirección.
En customer_address, store, warehouse, call_center y web_site se
asignan *_city al municipio, *_county a la provincia, *_state al código
provincial de dos dígitos y *_country a España.
El catálogo utilizado no aporta calles, códigos postales ni husos horarios. Esas columnas conservan valores sintéticos de TPC-DS y no describen una dirección postal española real. Al integrar fuentes sólo se pueden atribuir al dato externo los campos que realmente suministra.
Construir las consultas de localización
Sólo cinco dimensiones contienen direcciones. Para no reescribir a mano
más de cien columnas, pedimos su esquema a Trino y sustituimos ciudad,
provincia, código provincial y país en la lista SELECT. Las demás
columnas conservan su nombre, tipo y orden originales. La unión utiliza
el mismo CRC32 estable explicado arriba.
TPCDS_SCALE: str = "sf1"
TPCDS_ROOT: str = "/datalake/raw/tpcds"
LOCALIZED_COLUMNS: dict[str, tuple[str, str, str, str]] = {
    "customer_address": ("ca_city", "ca_county", "ca_state", "ca_country"),
    "store": ("s_city", "s_county", "s_state", "s_country"),
    "warehouse": ("w_city", "w_county", "w_state", "w_country"),
    "call_center": ("cc_city", "cc_county", "cc_state", "cc_country"),
    "web_site": ("web_city", "web_county", "web_state", "web_country"),
}


def localized_select(table_name: str) -> str:
    city, county, state, country = LOCALIZED_COLUMNS[table_name]
    described: list[list[object]] = trino_sql(
        f"DESCRIBE tpcds.{TPCDS_SCALE}.{table_name}", show=False
    )
    column_types: dict[object, object] = {row[0]: row[1] for row in described}
    replacements: dict[str, str] = {
        city: f"CAST(m.municipio AS {column_types[city]}) AS {city}",
        county: f"CAST(m.provincia AS {column_types[county]}) AS {county}",
        state: f"CAST(m.provincia_id AS {column_types[state]}) AS {state}",
        country: f"CAST('España' AS {column_types[country]}) AS {country}",
    }
    projection: str = ",\n    ".join(
        replacements.get(column, f"a.{column}") for column, *_ in described
    )
    return f"""
SELECT
    {projection}
FROM tpcds.{TPCDS_SCALE}.{table_name} AS a
JOIN hive.tpcds_bootstrap.ine_municipios_ordenados AS m
  ON m.posicion = 1 + mod(
      crc32(to_utf8(concat(
          coalesce(CAST(trim(a.{city}) AS varchar), ''),
          '|',
          coalesce(CAST(trim(a.{state}) AS varchar), '')
      ))),
      m.total_municipios
  )
""".strip()


print(localized_select("customer_address"))
Materializar las 24 tablas
Las celdas siguientes obtienen de Trino la lista de tablas, excluyen
dbgen_version y ejecutan un CTAS externo por tabla. Todo el SQL y toda la
decisión permanecen visibles aquí; el propio CREATE TABLE ... AS SELECT
hace que Trino lea, cruce y escriba los Parquet en HDFS.
hdfs es un envoltorio mínimo sobre subprocess.run que invoca el
cliente nativo hdfs dfs ya instalado en el contenedor. No es la vía que
se usará más adelante para leer datos (WebHDFS + fsspec, PyArrow,
Polars, DuckDB): aquí sólo hace falta consultar y escribir un fichero
diminuto —el marcador _SUCCESS—, así que basta con la CLI en vez de
montar un cliente HTTP para tan poco.
from subprocess import DEVNULL, PIPE, CompletedProcess, run


def hdfs(*arguments: str, check: bool = True, capture: bool = False) -> CompletedProcess[str]:
    return run(
        ["hdfs", "dfs", *arguments],
        check=check,
        text=True,
        stdout=PIPE if capture else None,
        stderr=None if check else DEVNULL,
    )
Trino conoce las 24 tablas de negocio de tpcds.sf1; excluimos
dbgen_version porque describe el generador, no el modelo de negocio.
# trino_sql() devuelve list[list[object]]; aquí se sabe que la primera
# columna es un nombre de tabla y se convierte explícitamente con str()
# en lugar de dejar un valor de tipo object.
table_names: list[str] = sorted(
    str(row[0])
    for row in trino_sql(f"SHOW TABLES FROM tpcds.{TPCDS_SCALE}", show=False)
    if row[0] != "dbgen_version"
)
assert len(table_names) == 24, table_names
El bucle usa el marcador _SUCCESS para poder repetirse sin rehacer
trabajo ni perder el cruce con el INE. Por ejemplo, para customer_address
(una de las cinco dimensiones localizadas):
hdfs dfs -test -e /datalake/raw/tpcds/customer_address/_SUCCESScomprueba si ya hay un marcador.-test -eno imprime nada: el resultado va en el código de salida, por eso basta conhdfs(...).returncodey no hace faltacapture=True.- Si existe,
hdfs dfs -cat .../_SUCCESSlee su contenido. En las dimensiones localizadas debe ser exactamenteINE-2026; en el resto, una cadena vacía. Si coincide con lo esperado, la tabla ya está materializada con la geografía correcta y se reutiliza sin tocar HDFS ni Trino. - Si el marcador falta o no coincide —por ejemplo, quedó de una
ejecución con otra fuente geográfica, o interrumpida a medias—,
hdfs dfs -rm -r -f .../customer_addressretira cualquier resto antes de que Trino vuelva a escribir conCREATE TABLE ... AS SELECT. - Al terminar el CTAS se escribe el marcador esperado en un fichero
local y
hdfs dfs -put -f /tmp/tpcds-success-marker .../_SUCCESSlo sube. Sólo entonces la tabla cuenta como materializada con esa geografía.
Comprobar el contenido del marcador, no sólo su existencia, es lo que distingue una tabla ya cruzada con el INE de una generada sin esa localización.
Por cada tabla verás una línea [=] tabla: ya está materializada o
[*] tabla: generando Parquet, según si reutiliza o reescribe. Al final
de la generación completa se imprime Materializadas ahora: 24; reutilizadas: 0; si vuelves a ejecutar esta celda sin haber borrado
nada, debería salir Materializadas ahora: 0; reutilizadas: 24, porque
todos los marcadores ya coinciden con lo esperado.
materialized: list[str] = []
already_available: list[str] = []
success_file: Path = Path("/tmp/tpcds-success-marker")

for table_name in table_names:
    table_path: str = f"{TPCDS_ROOT}/{table_name}"
    marker_path: str = f"{table_path}/_SUCCESS"
    expected_marker: str = "INE-2026" if table_name in LOCALIZED_COLUMNS else ""
    marker_exists: bool = hdfs("-test", "-e", marker_path, check=False).returncode == 0
    if marker_exists:
        marker: str = hdfs("-cat", marker_path, capture=True).stdout
        if marker == expected_marker:
            # Una ejecución interrumpida pudo dejar metadatos temporales
            # aunque los Parquet y su marcador ya estuvieran completos.
            trino_sql(f"DROP TABLE IF EXISTS hive.tpcds_bootstrap.{table_name}", show=False)
            already_available.append(table_name)
            print(f"[=] {table_name}: ya está materializada")
            continue

    print(f"[*] {table_name}: generando Parquet")
    trino_sql(f"DROP TABLE IF EXISTS hive.tpcds_bootstrap.{table_name}", show=False)
    hdfs("-rm", "-r", "-f", table_path, check=False)
    select_query: str = (
        localized_select(table_name)
        if table_name in LOCALIZED_COLUMNS
        else f"SELECT * FROM tpcds.{TPCDS_SCALE}.{table_name}"
    )
    trino_sql(
        f"""
CREATE TABLE hive.tpcds_bootstrap.{table_name}
WITH (
    format = 'PARQUET',
    external_location = 'hdfs://namenode:9000{table_path}'
) AS
{select_query}
""",
        show=False,
    )
    success_file.write_text(expected_marker, encoding="utf-8")
    hdfs("-put", "-f", str(success_file), marker_path)
    trino_sql(f"DROP TABLE hive.tpcds_bootstrap.{table_name}", show=False)
    materialized.append(table_name)

print(f"Materializadas ahora: {len(materialized)}; reutilizadas: {len(already_available)}")
Punto de comprobación. En una primera ejecución completa deberías ver
24 líneas [*] tabla: generando Parquet y Materializadas ahora: 24; reutilizadas: 0. Si repites esta celda sin haber borrado
/datalake/raw/tpcds ni cambiado la fuente geográfica, debería salir
Materializadas ahora: 0; reutilizadas: 24: es la señal de que el marcador
_SUCCESS de las 24 tablas ya coincide con lo esperado y el bucle no ha
vuelto a escribir nada. Un valor intermedio (por ejemplo, reutilizadas: 19)
indica una ejecución previa interrumpida a medias.
Validar y retirar sólo los metadatos temporales
Comprobamos que las 24 tablas tienen marcador y que las cinco dimensiones
geográficas indican INE-2026. Después eliminamos la vista, la tabla CSV y
el esquema temporal. Al ser tablas externas, sus ficheros permanecen en
HDFS para ésta y las siguientes sesiones.
for table_name in table_names:
    marker_path: str = f"{TPCDS_ROOT}/{table_name}/_SUCCESS"
    assert hdfs("-test", "-e", marker_path, check=False).returncode == 0
    if table_name in LOCALIZED_COLUMNS:
        assert hdfs("-cat", marker_path, capture=True).stdout == "INE-2026"

trino_sql("DROP VIEW hive.tpcds_bootstrap.ine_municipios_ordenados", show=False)
trino_sql("DROP TABLE hive.tpcds_bootstrap.ine_municipios", show=False)
trino_sql("DROP SCHEMA IF EXISTS hive.tpcds_bootstrap", show=False)

print("Dataset preparado: 24 tablas TPC-DS y fuente municipal del INE en HDFS")
!hdfs dfs -du -h -s /datalake/raw/tpcds
!hdfs dfs -ls -h /datalake/raw/ine/municipios
!hdfs dfs -text /datalake/raw/ine/municipios/municipios-2026.csv.gz | sed -n '1,6p'
Descargar, limpiar y convertir la fuente (referencia)
Las celdas anteriores ya han descargado la instantánea versionada en
entorno/data/ine/municipios-2026.csv.gz desde dsevilla/tcdm-public
(rama 26-27) y la han publicado en HDFS. El alumnado siempre recibe esa
instantánea ya preparada: nunca hace falta regenerarla para seguir esta
sesión.
Las celdas Markdown que siguen muestran, solo como referencia de mantenimiento, cómo se descargaría una nueva edición del Excel del INE, cómo se leerían y limpiarían sus hojas y cómo se convertiría a CSV gzip. No se ejecutan en este notebook y no se comparan con la instantánea ya descargada: la lista puede cambiar cuando el INE publique otra edición.
Descargar la publicación
Este paso sólo se ejecutaría al mantener el material cuando el INE publique una nueva edición. El alumnado ya recibe una instantánea revisada, por lo que la celda se conserva como documentación y no como una descarga automática.
ine_urlidentifica la publicación oficial que se quiere revisar.Pathfija un fichero temporal fuera del material distribuido; el XLSX no se guarda en Git.Requestañade unUser-Agentdescriptivo.urlopenrealiza la petición ytimeout=30evita que un servidor que no responde deje el notebook esperando indefinidamente.write_bytesguarda la respuesta binaria completa: un XLSX es un ZIP, no un fichero de texto que se pueda abrir conopen(..., encoding="utf-8").
El resultado de este paso es /tmp/26codmun.xlsx. No se calcula una huella
esperada ni se compara con la instantánea: el contenido de una edición nueva
puede cambiar legítimamente.
from pathlib import Path
from urllib.request import Request, urlopen

ine_url = "https://www.ine.es/daco/daco42/codmun/26codmun.xlsx"
ine_excel = Path("/tmp/26codmun.xlsx")

request = Request(ine_url, headers={"User-Agent": "Mozilla/5.0"})
with urlopen(request, timeout=30) as response:
    ine_excel.write_bytes(response.read())

print(f"Descargados {ine_excel.stat().st_size:,} bytes")
Este bloque es ilustrativo: no se ejecuta al trabajar con la
instantánea que ya proporciona entorno/data/ine.
Leer las hojas con Polars
Polars ofrece polars.read_excel para cargar archivos Excel:
sheet_id=0devuelve un diccionario con las 52 hojas provinciales, ya convertidas enDataFrame, en el mismo orden en que aparecen en el libro.has_header=Falselee cada hoja como una rejilla sin cabecera: las tres primeras filas de cada hoja no son datos. La fila 0 es el título del libro, la fila 1 es el nombre de la provincia (columnaA) y la fila 2 es la cabecera real (CPRO,CMUN,DC,NOMBRE); los municipios empiezan en la fila 3.- El motor por defecto,
calamine(paquetefastexcel), lee el tipo de cada celda tal como lo guarda el XLSX: los códigos llegan como texto y conservan sus ceros iniciales sin ningún tratamiento adicional.
import polars as pl

sheets = pl.read_excel(ine_excel, sheet_id=0, has_header=False)
first_sheet = next(iter(sheets.values()))

print(f"{len(sheets)} hojas provinciales")
first_sheet.head()
Este bloque es ilustrativo: no se ejecuta al trabajar con la
instantánea que ya proporciona entorno/data/ine.
Normalizar los municipios
expected_headercomprueba que las cuatro columnas de datos siguen siendoCPRO,CMUN,DCyNOMBREen cada hoja.- La provincia se toma de la fila 1 de cada hoja y se añade a todos sus municipios; así no dependemos de que cada fila repita ese nombre.
- Las filas con algún valor vacío se descartan porque no pueden formar una clave fiable.
- La concatenación de
province_idymunicipality_codeconserva ceros iniciales y forma el identificador INE de cinco dígitos. - El resultado se ordena por
municipio_idpara que la instantánea sea estable aunque cambie el orden de lectura de las hojas.
expected_header = ["CPRO", "CMUN", "DC", "NOMBRE"]
municipalities: list[tuple[str, ...]] = []

for frame in sheets.values():
    header = [str(value) for value in frame.row(2)[:4]]
    assert header == expected_header
    province = str(frame.row(1)[0])
    for row in frame[3:].iter_rows():
        province_id, municipality_code, check_digit, municipality = (
            "" if value is None else str(value) for value in row[:4]
        )
        if not all((province_id, municipality_code, check_digit, municipality)):
            continue
        municipality_id = f"{province_id}{municipality_code}"
        municipalities.append(
            (municipality_id, province_id, municipality_code, check_digit, municipality, province)
        )

municipalities.sort(key=lambda row: row[0])
municipalities[:5]
El código completo —descarga, lectura, comprobación y reescritura de la
instantánea— vive en s2/regenerate_ine_municipios.py; --check compara su
resultado contra la instantánea ya versionada sin escribirla, que es como se
comprobó que esta lectura con polars reproduce exactamente entorno/data/ine.
Este bloque es ilustrativo: no se ejecuta al trabajar con la
instantánea que ya proporciona entorno/data/ine.
Validar la relación
Las tres comprobaciones protegen el contrato que utilizarán los cruces de TPC-DS:
len(municipalities)comprueba el tamaño de la edición que estamos procesando.- La comparación con
set(municipality_ids)detecta identificadores repetidos; un duplicado haría ambiguo cualquierJOINposterior. - El conjunto de provincias exige exactamente los códigos
01a52, con dos dígitos.
El número 8.132 describe la edición 2026 que se distribuye. Si el INE publica otra edición con otro número, se revisa ese valor durante el mantenimiento; no se usa esta comprobación para comparar automáticamente una descarga con la copia del curso.
municipality_ids = [row[0] for row in municipalities]
province_ids = {row[1] for row in municipalities}

assert len(municipalities) == 8_132
assert len(set(municipality_ids)) == len(municipality_ids)
assert province_ids == {f"{code:02d}" for code in range(1, 53)}
print("8.132 municipios únicos y códigos provinciales 01–52")
Este bloque es ilustrativo: no se ejecuta al trabajar con la
instantánea que ya proporciona entorno/data/ine.
Convertir y comprimir
Aquí se materializa el formato que recibe el curso:
csv.writerescribe UTF-8, usa;como separador y termina cada registro con un salto de línea Unix. La cabecera fija los nombres y el orden que esperan Trino y Polars.writer.writerowsescribe las tuplas ya ordenadas; el resultado intermedio es/tmp/municipios-2026.csv.gzip.GzipFilecrea/tmp/municipios-2026.csv.gz.compresslevel=9usa la máxima compresión,mtime=0evita guardar la hora de ejecución yfilename=""evita incrustar una ruta local en la cabecera gzip; así el artefacto es reproducible.shutil.copyfileobjcopia el contenido sin cargarlo entero en otra estructura de Python.
El fichero .gz es el que se coloca en entorno/data/ine. El código se muestra
para documentar el mantenimiento, pero no se ejecuta como parte de S2.
import csv
import gzip
import shutil
from pathlib import Path

regenerated_csv = Path("/tmp/municipios-2026.csv")
with regenerated_csv.open("w", encoding="utf-8", newline="") as output:
    writer = csv.writer(output, delimiter=";", lineterminator="\n")
    writer.writerow(
        (
            "municipio_id",
            "provincia_id",
            "codigo_municipio",
            "digito_control",
            "municipio",
            "provincia",
        )
    )
    writer.writerows(municipalities)

regenerated_gzip = Path("/tmp/municipios-2026.csv.gz")
with regenerated_csv.open("rb") as source, regenerated_gzip.open("wb") as raw_output:
    with gzip.GzipFile(
        filename="",
        mode="wb",
        fileobj=raw_output,
        compresslevel=9,
        mtime=0,
    ) as destination:
        shutil.copyfileobj(source, destination)
Este bloque es ilustrativo: no se ejecuta al trabajar con la
instantánea que ya proporciona entorno/data/ine.
Dónde están físicamente los datos
Los datos están repartidos como bloques entre los DataNode y el NameNode
conserva sus metadatos. Como el notebook se ejecuta dentro de namenode,
las órdenes hdfs dfs son celdas normales. Empezamos listando las dos
fuentes de la capa raw:
!hdfs dfs -ls -h /datalake/raw
Cada directorio de tabla puede contener varios ficheros de datos y el
marcador _SUCCESS. En las dimensiones localizadas contiene la versión
INE-2026; en las demás puede estar vacío. Miremos una tabla concreta,
date_dim, tanto su listado como el espacio que ocupa:
!hdfs dfs -ls -h /datalake/raw/tpcds/date_dim
!hdfs dfs -du -h /datalake/raw/tpcds/date_dim
Los ficheros de datos pueden no terminar en .parquet, porque Trino no
necesita esa extensión al escribir una tabla externa. El formato se
reconoce por la firma binaria PAR1 al principio y al final del fichero,
no por su nombre. Puedes comprobarlo sin descargar el fichero al host: se pide
primero el nombre de un fragmento real con hdfs dfs -ls (evitando
_SUCCESS, que es un marcador de finalización y no contiene filas Parquet) y
después inspeccionamos sus primeros bytes. od -N 4 deja de leer tras cuatro
bytes y cierra la tubería; hdfs dfs -cat, que seguía enviando el fichero,
protestaría entonces con cat: Unable to write to output stream. Es un
aviso inofensivo, y 2>/dev/null lo oculta:
!hdfs dfs -cat $(hdfs dfs -ls /datalake/raw/tpcds/date_dim \
  | awk '$NF ~ /date_dim\// && $NF !~ /_SUCCESS$/ { print $NF; exit }') 2>/dev/null \
  | od -An -c -N 4
En la salida debe aparecer la firma inicial P A R 1. Las celdas de generación muestran también el tamaño de cada
directorio de tabla y un resumen del dataset completo con
hdfs dfs -du -h. Su salida tiene dos tamaños: el primero es el tamaño
lógico de los datos y el segundo es el espacio consumido en HDFS después de
aplicar las réplicas — con el factor de replicación tres, un fichero
lógico de 1 MB puede ocupar aproximadamente 3 MB de espacio HDFS. También
podemos pedir el detalle de todas las tablas materializadas en
/datalake/raw/tpcds y el total agregado:
!hdfs dfs -du -h /datalake/raw/tpcds
!hdfs dfs -du -h -s /datalake/raw/tpcds
La primera orden permite comparar el tamaño de las tablas y la segunda
resume todo el contenido de /datalake/raw/tpcds. Estas cifras son una estimación útil del espacio que
ocupará el dataset en el clúster de cada alumno; pueden variar ligeramente
si la escritura genera un número distinto de ficheros, pero no cambia el
volumen lógico esperado del dataset.
HDFS permite además observar los bloques y sus réplicas, algo que un simple
ls no muestra:
!hdfs fsck /datalake/raw/tpcds/date_dim -files -blocks -locations
La salida relaciona cada fichero con sus bloques y muestra en qué
DataNodes se han colocado. Esto es distinto de listar el directorio:
ls muestra la estructura lógica, mientras que fsck permite observar
parte de la distribución física y de la replicación.
En S1 esta orden se lanzó como hdadmin. Aquí basta luser: fsck sobre
una ruta es una consulta de sólo lectura que se ejecuta con los permisos de
quien la lanza, y luser puede leer /datalake. Sólo algunas de sus
opciones, como -blockId, exigen ser superusuario.
Qué tablas contiene TPC-DS
Las columnas siguen una convención de prefijos: ss_ pertenece a
store_sales, cs_ a catalog_sales, ws_ a web_sales, y así
sucesivamente. Las columnas terminadas en _sk suelen ser claves
sustitutas ("surrogate keys") que enlazan una tabla de hechos con una
dimensión. Las fechas se suelen enlazar mediante una clave numérica a
date_dim, en lugar de guardar una fecha completa en cada fila de hechos.
PK identifica una clave primaria, FK una clave ajena y BK una clave de
negocio útil para reconocer el mismo objeto fuera del almacén. En las tablas
de hechos la clave primaria es compuesta y sus componentes se indican como
(1/2), (2/2), (1/3), etc.
Las relaciones son lógicas: Parquet no impone claves ajenas y TPC-DS deja
opcional la integridad referencial. Por eso se marcan aquí para que puedan
comprobarse mediante JOIN o anti-JOIN — más adelante en esta sesión se
declarará una copia relacional con restricciones en DuckDB. Fuente:
TPC-DS v4.0.0.
El esquema completo de las 24 tablas de negocio es largo —TPC-DS especifica más de 400 columnas en total—, así que el flujo principal de esta sesión presenta de cada tabla sólo las columnas que usa cada ejemplo. El catálogo completo, organizado igual que la especificación (dimensiones y tablas de hechos), está en el apéndice final para consulta, sin que interrumpa el hilo práctico.
Ese catálogo no hay que memorizarlo. Más adelante, la sección «Las tablas con datos delante» resume qué conviene recordar de las tablas que más se usan y las muestra con filas reales.
Otras formas de acceder a HDFS
Esta sesión lee los Parquet de /datalake/raw/tpcds mediante WebHDFS,
la interfaz HTTP de HDFS, a través de fsspec. No es la única forma de
hacerlo, y conviene situarla entre las demás:
- la interfaz de línea de órdenes (
hdfs dfs), ya usada en S1, resuelve operaciones puntuales pero no es cómoda para leer datos desde un programa; - la API Java (
org.apache.hadoop.fs.FileSystem) es la interfaz nativa de Hadoop, la que usan internamentehdfs dfsy los propios demonios; pyarrow.fs.HadoopFileSystemofrece un cliente nativo desde Python, que habla el mismo protocolo RPC que la API Java en vez de HTTP; necesita las bibliotecas de Hadoop disponibles en el classpath del proceso;- WebHDFS expone HDFS como una API REST sobre HTTP, servida por el NameNode y los DataNodes. HttpFS ofrece esa misma API, con lectura y escritura, desde un servidor que actúa de pasarela: el cliente sólo necesita llegar a él y no a cada DataNode, lo que resulta útil cuando el clúster está detrás de un cortafuegos. Ninguna de las dos requiere las bibliotecas nativas, así que son adecuadas para clientes ligeros o para lenguajes sin un cliente Hadoop propio.
Elegir WebHDFS en esta sesión es una decisión pedagógica, no la única
válida: permite usar fsspec con PyArrow, Polars y DuckDB sin instalar
dependencias nativas de Hadoop en el entorno donde se ejecuta este notebook.
Acceso con WebHDFS y fsspec
WebHDFS es una API HTTP que ofrece el NameNode para operaciones de lectura
y escritura sobre HDFS. Cuando se solicita un fichero, el NameNode puede
redirigir la transferencia al DataNode que contiene el bloque; por eso es
importante que el cliente pueda resolver los nombres de los DataNodes
dentro de la red Docker (algo que, al ejecutarse este notebook dentro de
namenode, ya se cumple automáticamente).
Abrimos una sesión con fsspec y listamos los ficheros de date_dim. La
expresión glob también encuentra _SUCCESS, por lo que se filtra de
forma explícita — el mismo cuidado será necesario más adelante con Polars y
DuckDB:
import fsspec
from fsspec.spec import AbstractFileSystem

webhdfs: AbstractFileSystem = fsspec.filesystem(
    "webhdfs",
    host="namenode",
    port=9870,
    user="luser",
    use_https=False,
)

table_path: str = "/datalake/raw/tpcds/date_dim"
files: list[str] = sorted(
    path for path in webhdfs.glob(f"{table_path}/*") if not path.endswith("/_SUCCESS")
)

print(f"Ficheros de datos: {len(files)}")
print(files[:3])
Si files está vacío, no es un resultado de la consulta: significa que la
tabla no se ha generado, que se ha utilizado otra escala, o que WebHDFS no
está accesible — hay que volver a la sección de generación y comprobar que
las celdas de materialización terminaron correctamente; «Solución de
problemas», al final del notebook, recoge los casos habituales. También podemos comprobar el
tamaño y los metadatos de un fichero sin leer todavía ninguna columna
Parquet:
from typing import Any

info: dict[str, Any] = webhdfs.info(files[0])
print(info["name"])
print(info["size"], "bytes")
Leer la misma tabla con tres bibliotecas
Comparamos ahora cómo leen exactamente los mismos Parquet remotos PyArrow,
Polars y DuckDB. Las tres se apoyan en la misma conexión fsspec a
WebHDFS que acabamos de abrir; lo único que cambia es el adaptador que
traduce esa conexión a la API de cada biblioteca.
Empezamos por date_dim, la dimensión de calendario: una fila por día, con
la fecha y sus atributos (año, mes, trimestre, día de la semana, festivo…).
De sus 28 columnas, en esta parte se usan cuatro:
| Columna | Tipo | Qué es |
|---|---|---|
d_date_sk |
bigint |
Clave de la fecha; es la que referencian las tablas de hechos |
d_date |
date |
La fecha del calendario |
d_year |
integer |
El año |
d_holiday |
char(1) |
Indicador de día festivo |
El esquema completo está en el apéndice.
PyArrow tiene un lector Parquet muy completo, pero su API espera un
sistema de ficheros compatible con Arrow, no un filesystem de fsspec
directamente. pyarrow.fs.PyFileSystem junto con FSSpecHandler adaptan
cualquier filesystem de fsspec — en este caso webhdfs — a esa interfaz,
así que read_table puede leer los fragmentos de files como si fueran
locales. De paso calculamos un pequeño resumen de consistencia sobre la
clave d_date_sk: número de filas, valores no nulos, mínimo, máximo y
suma:
import pyarrow as pa
import pyarrow.compute as pc
import pyarrow.parquet as pq

arrow_fs: pa.fs.FileSystem = pa.fs.PyFileSystem(pa.fs.FSSpecHandler(webhdfs))
arrow_table: pa.Table = pq.read_table(files, filesystem=arrow_fs)

key_values: pa.ChunkedArray = arrow_table["d_date_sk"]
print(arrow_table.schema)
summary = (
    arrow_table.num_rows,
    pc.count(key_values).as_py(),
    pc.min(key_values).as_py(),
    pc.max(key_values).as_py(),
    pc.sum(key_values).as_py(),
)
print(summary)
print("TCDM_SUMMARY\tpyarrow\tdate_dim\t" + "\t".join(map(str, summary)))
Polars no necesita un adaptador de filesystem: abre cada fichero como un
flujo binario con webhdfs.open(path, "rb") — el propio objeto que
fsspec expone para leer bytes remotos — y se lo entrega a
pl.read_parquet. Como cada tabla TPC-DS puede estar partida en varios
fragmentos Parquet, hay que leer uno por uno y concatenar los DataFrames
resultantes:
import polars as pl

fragments: list[pl.DataFrame] = [pl.read_parquet(webhdfs.open(path, "rb")) for path in files]
polars_table: pl.DataFrame = pl.concat(fragments, how="vertical")

key_values: pl.Series = polars_table.get_column("d_date_sk")
print(polars_table.schema)
summary = (
    polars_table.height,
    key_values.len() - key_values.null_count(),
    key_values.min(),
    key_values.max(),
    key_values.sum(),
)
print(summary)
print("TCDM_SUMMARY\tpolars\tdate_dim\t" + "\t".join(map(str, summary)))
DuckDB se conecta de una tercera forma: register_filesystem registra
el filesystem de fsspec bajo el esquema de URL webhdfs://, y a partir
de ahí read_parquet recibe una lista de esas URLs y se comporta como una
tabla virtual dentro de cualquier consulta SQL. El resumen de consistencia
se calcula aquí como una agregación SQL, no con una función de Python:
import duckdb

connection: duckdb.DuckDBPyConnection = duckdb.connect()
duckdb.register_filesystem(webhdfs, connection=connection)
urls: list[str] = [f"webhdfs://{path}" for path in files]

description: list[tuple[object, ...]] = connection.execute(
    "DESCRIBE SELECT * FROM read_parquet(?)", [urls]
).fetchall()
print(description)

summary: tuple[object, ...] | None = connection.execute(
    """
    SELECT count(*), count(d_date_sk), min(d_date_sk), max(d_date_sk), sum(d_date_sk)
    FROM read_parquet(?)
    """,
    [urls],
).fetchone()
print(summary)
print("TCDM_SUMMARY\tduckdb\tdate_dim\t" + "\t".join(map(str, summary)))
No hace falta que las tres formas de leer produzcan la misma salida
textual: PyArrow imprime un esquema Arrow, Polars un esquema y un
DataFrame, y DuckDB muestra el resultado de DESCRIBE y de una consulta
de agregación. Lo que sí debe coincidir son las cinco cifras del resumen:
filas, valores no nulos, mínimo, máximo y suma de d_date_sk. Esa
coincidencia confirma que las tres bibliotecas han leído exactamente los
mismos Parquet, aunque cada una presente el resultado a su manera.
Explorar con PyArrow
Repetimos la lectura de date_dim, pero ahora seleccionando solo tres
columnas, para que sea visible que PyArrow no necesita cargar todo el
esquema físico. El número de filas debe seguir siendo el mismo que leímos
antes para toda la tabla: 73.049. Comprobarlo así es una forma sencilla de
detectar si se ha apuntado a otra escala o a una generación incompleta.
Reutilizamos el mismo arrow_fs (PyFileSystem + FSSpecHandler) de
antes, ahora con columns=[...]:
import pyarrow as pa
import pyarrow.compute as pc
import pyarrow.parquet as pq

arrow_fs: pa.fs.FileSystem = pa.fs.PyFileSystem(pa.fs.FSSpecHandler(webhdfs))

arrow_table: pa.Table = pq.read_table(
    files,
    filesystem=arrow_fs,
    columns=["d_date", "d_year", "d_holiday"],
)

print(arrow_table)
print(arrow_table.num_rows)
La lista files permite leer todos los fragmentos de la tabla como una
sola tabla Arrow. La opción columns es importante: Parquet es un formato
columnar y el lector puede evitar leer las columnas que no se necesitan.
Para consultar solo los años recientes:
recent_dates: pa.Table = arrow_table.filter(
    pc.greater_equal(
        arrow_table["d_year"],
        1998,
    )
)
print(recent_dates)
En este ejemplo el filtro se aplica después de leer las tres columnas seleccionadas. Todavía no estamos aprovechando todo el predicate pushdown de un motor de consulta, pero ya se observa la selección de columnas. DuckDB permitirá estudiar el plan SQL y sus filtros de forma más directa. Para inspeccionar el esquema inferido por el lector:
print(arrow_table.schema)
Se deben reconocer una columna de fecha (d_date), un entero (d_year) y
una cadena de un carácter (d_holiday). Los nombres y tipos vienen de los metadatos de los Parquet; no se
han inventado en el código Python.
Explorar con Polars
Leemos ahora los mismos ficheros y con la misma selección de columnas, pero con Polars:
import polars as pl

columns: list[str] = ["d_date", "d_year", "d_holiday"]
fragments: list[pl.DataFrame] = [
    pl.read_parquet(webhdfs.open(path, "rb"), columns=columns) for path in files
]
selected_dates: pl.DataFrame = pl.concat(fragments, how="vertical")

print(selected_dates.schema)
print(selected_dates.height)
El código anterior abre cada fichero con webhdfs.open(..., "rb") y
entrega el stream binario a pl.read_parquet, seleccionando solo las
columnas indicadas; al final concatena los fragmentos. El resultado no es
una lectura de una copia local: cada apertura solicita los bytes a través
de WebHDFS, y si el directorio contiene más de un fragmento el número de
filas final debe seguir siendo el mismo.
Polars también puede convertir directamente una tabla Arrow que ya tengamos en memoria, sin volver a pedir los bytes a WebHDFS:
import polars as pl

dates: pl.DataFrame = pl.from_arrow(arrow_table)
print(dates)
print(dates.schema)
Una expresión Polars equivalente al filtro anterior es:
recent_dates: pl.DataFrame = dates.filter(pl.col("d_year") >= 1998).select(
    ["d_date", "d_year", "d_holiday"]
)
print(recent_dates)
También se puede leer directamente un fragmento Parquet desde un objeto
abierto por fsspec, sin pasar por Arrow:
with webhdfs.open(files[0], "rb") as source:
    first_fragment: pl.DataFrame = pl.read_parquet(
        source,
        columns=["d_date", "d_year"],
    )

print(first_fragment.shape)
Este último ejemplo enseña la diferencia entre leer un fichero individual y leer todos los fragmentos de una tabla. Para procesar la tabla completa se puede leer cada fichero y concatenar los resultados, aunque para tablas grandes conviene utilizar una lectura por lotes o un motor que planifique el trabajo sin acumularlo todo en memoria:
fragments: list[pl.DataFrame] = []
for path in files:
    with webhdfs.open(path, "rb") as source:
        fragments.append(pl.read_parquet(source, columns=["d_date", "d_year"]))

all_dates: pl.DataFrame = pl.concat(fragments)
print(all_dates.shape)
La lista fragments es didáctica. En tablas como inventory no conviene
mantener todos los DataFrames intermedios en memoria si el ordenador está
ajustado de recursos.
Explorar con DuckDB
Por último, consultamos los mismos ficheros con SQL a través de DuckDB. La ruta de lectura es WebHDFS → fsspec → DuckDB: PyArrow y Polars llegan al mismo filesystem mediante sus propios adaptadores, pero DuckDB lo hace registrándolo bajo un esquema de URL.
DuckDB puede ejecutar SQL sobre Parquet sin levantar ningún servidor.
Reutilizamos la conexión connection, en la que ya registramos el
filesystem de fsspec: read_parquet recibe una lista de URLs webhdfs://
y se comporta como una tabla virtual dentro de cualquier consulta:
webhdfs_files: list[str] = sorted(
    path
    for path in webhdfs.glob("/datalake/raw/tpcds/date_dim/*")
    if not path.endswith("/_SUCCESS")
)
urls: list[str] = [f"webhdfs://{path}" for path in webhdfs_files]

result: list[tuple[object, ...]] = connection.execute(
    "SELECT count(*) AS rows FROM read_parquet(?)",
    [urls],
).fetchall()
print(result)
La consulta debe devolver 73.049 filas. Se utiliza una
lista explícita de ficheros porque un patrón que incluya todo el
directorio también puede seleccionar _SUCCESS, que no es un Parquet y
produciría un error de fichero demasiado pequeño. Una consulta que lee solo
algunas columnas y filtra por año:
result: list[tuple[object, ...]] = connection.execute(
    """
    SELECT d_year, d_holiday, count(*) AS days
    FROM read_parquet(?)
    WHERE d_year BETWEEN 1998 AND 2000
    GROUP BY d_year, d_holiday
    ORDER BY d_year, d_holiday
    """,
    [urls],
).fetchall()

print(result)
DuckDB permite recuperar el resultado como tuplas con fetchall o como una
tabla Arrow que Polars puede convertir directamente en un DataFrame:
arrow_result: pa.Table = connection.execute(
    "SELECT d_year, count(*) AS days FROM read_parquet(?) GROUP BY d_year",
    [urls],
).fetch_arrow_table()
print(pl.from_arrow(arrow_result))
En esta sesión no se exige memorizar qué biblioteca se utiliza internamente para cada conversión. Lo importante es observar que DuckDB puede ser un motor SQL local sobre ficheros distribuidos, mientras que HDFS continúa siendo el almacenamiento remoto.
Ver la tabla resultante y comprobar relaciones
read_parquet no crea una tabla persistente: es una tabla virtual que
DuckDB construye al leer los ficheros. Aun así podemos inspeccionar su
esquema y mostrar algunas filas como si fuera una tabla relacional. Para
esto usaremos web_sales, la tabla de hechos de ventas web, y customer,
la dimensión de clientes.
web_sales tiene una fila por línea de pedido. De sus 34 columnas, las 17
primeras son claves hacia dimensiones (fechas, cliente, domicilio, producto,
página, almacén, promoción…); después vienen el número de pedido y 16
cantidades e importes. customer tiene una fila por cliente, con sus datos
personales sintéticos y las claves de su domicilio y de su perfil
demográfico. Las columnas que intervienen aquí son:
| Columna | Tabla | Qué es |
|---|---|---|
ws_item_sk |
web_sales |
Producto vendido; con ws_order_number forma la clave primaria |
ws_order_number |
web_sales |
Número de pedido |
ws_bill_customer_sk |
web_sales |
Cliente al que se factura; apunta a customer.c_customer_sk |
c_customer_sk |
customer |
Clave del cliente |
Los esquemas completos de las dos tablas están en el apéndice.
El siguiente bloque reutiliza el webhdfs creado antes: lista primero los
ficheros que se van a leer, describe sus columnas y muestra una pequeña
muestra del resultado.
import polars as pl
import pyarrow as pa

duckdb_web_sales_files: list[str] = sorted(
    path
    for path in webhdfs.glob("/datalake/raw/tpcds/web_sales/*")
    if not path.endswith("/_SUCCESS")
)
duckdb_web_sales_urls: list[str] = [f"webhdfs://{path}" for path in duckdb_web_sales_files]

print("Orden: listar los ficheros Parquet de web_sales")
print(*duckdb_web_sales_files, sep="\n")
print("Orden: describir la tabla virtual creada por read_parquet")
schema_rows: list[tuple[object, ...]] = connection.execute(
    "DESCRIBE SELECT * FROM read_parquet(?)",
    [duckdb_web_sales_urls],
).fetchall()
print(*schema_rows, sep="\n")
print("Orden: leer cinco filas de web_sales")
sample: pa.Table = connection.execute(
    "SELECT * FROM read_parquet(?) LIMIT 5",
    [duckdb_web_sales_urls],
).fetch_arrow_table()
print(sample)
print("La misma muestra convertida a un DataFrame Polars:")
sample_polars: pl.DataFrame = pl.from_arrow(sample)
print(sample_polars)
La primera salida permite comprobar el esquema que DuckDB ha inferido del
Parquet; la segunda permite ver valores reales y detectar, por ejemplo, si
una columna que esperábamos numérica contiene nulos o si las claves tienen
el tipo adecuado. fetch_arrow_table() devuelve una tabla Arrow, y la
conversión a Polars sirve para comparar los tres niveles que estamos
utilizando: fichero Parquet, tabla Arrow y DataFrame.
Las marcas FK del apéndice describen relaciones lógicas. Podemos
comprobar una de ellas mediante un anti-JOIN: buscamos ventas cuyo
cliente de facturación no aparece en customer. Un JOIN normal ocultaría
esas filas porque solo conservaría las coincidencias; el anti-JOIN las
hace visibles.
duckdb_customer_files: list[str] = sorted(
    path
    for path in webhdfs.glob("/datalake/raw/tpcds/customer/*")
    if not path.endswith("/_SUCCESS")
)
duckdb_customer_urls: list[str] = [f"webhdfs://{path}" for path in duckdb_customer_files]

print("Orden: comprobar la FK web_sales.ws_bill_customer_sk")
orphan_customer_count: int = int(
    connection.execute(
        """
    SELECT count(*)
    FROM read_parquet(?) AS sales
    LEFT JOIN read_parquet(?) AS customers
      ON sales.ws_bill_customer_sk = customers.c_customer_sk
    WHERE sales.ws_bill_customer_sk IS NOT NULL
      AND customers.c_customer_sk IS NULL
    """,
        [duckdb_web_sales_urls, duckdb_customer_urls],
    ).fetchone()[0]
)
print(f"Filas de web_sales sin cliente correspondiente: {orphan_customer_count}")
En un dataset TPC-DS correcto esperamos obtener cero. Esta consulta no añade una restricción al Parquet: solo audita la integridad de los valores que ya están almacenados. Conviene distinguir tres cosas: el esquema de columnas, la relación documentada por TPC-DS y la restricción que un motor relacional puede hacer cumplir al insertar datos.
Declarar una copia con clave ajena en DuckDB
Para ver la diferencia, podemos cargar una muestra en tablas temporales de
DuckDB y declarar allí la relación. La tabla demo_customer declara su
clave primaria; demo_web_sales declara que ws_bill_customer_sk debe
existir en ella. La restricción se comprueba al insertar las filas, pero
solo afecta a estas copias temporales: no modifica los ficheros de HDFS.
connection.execute("DROP TABLE IF EXISTS demo_web_sales")
connection.execute("DROP TABLE IF EXISTS demo_customer")

print("Orden: crear la tabla temporal de clientes con PK")
connection.execute("""
    CREATE TEMPORARY TABLE demo_customer (
        c_customer_sk BIGINT PRIMARY KEY
    )
    """)
connection.execute(
    """
    INSERT INTO demo_customer
    SELECT c_customer_sk
    FROM read_parquet(?)
    """,
    [duckdb_customer_urls],
)
print("Orden: crear la tabla temporal de ventas con FK")
connection.execute("""
    CREATE TEMPORARY TABLE demo_web_sales (
        ws_item_sk BIGINT,
        ws_order_number BIGINT,
        ws_bill_customer_sk BIGINT,
        FOREIGN KEY (ws_bill_customer_sk)
            REFERENCES demo_customer (c_customer_sk)
    )
    """)
connection.execute(
    """
    INSERT INTO demo_web_sales
    SELECT ws_item_sk, ws_order_number, ws_bill_customer_sk
    FROM read_parquet(?)
    WHERE ws_bill_customer_sk IS NOT NULL
    LIMIT 1000
    """,
    [duckdb_web_sales_urls],
)
print("Orden: consultar las restricciones declaradas")
constraint_rows: list[tuple[object, ...]] = connection.execute("""
    SELECT table_name, constraint_type, constraint_name
    FROM information_schema.table_constraints
    WHERE table_name IN ('demo_customer', 'demo_web_sales')
    ORDER BY table_name, constraint_type
    """).fetchall()
print(*constraint_rows, sep="\n")
Probamos ahora a insertar una línea de venta cuyo cliente no existe en
demo_customer:
try:
    connection.execute("INSERT INTO demo_web_sales VALUES (1, 1, -1)")
except duckdb.ConstraintException as error:
    print(f"DuckDB rechaza la fila: {error}")
else:
    raise AssertionError("La clave ajena debería haber rechazado la inserción")
DuckDB ha rechazado la operación por violar la clave ajena: el cliente -1
no existe en demo_customer. Esta es una buena
demostración de integridad referencial, pero no convierte automáticamente
los Parquet en tablas con restricciones. En DuckDB las restricciones se
declaran al crear una tabla relacional; la lectura directa mediante
read_parquet y una operación CREATE TABLE AS SELECT no las añade. Para
el data lake, la estrategia habitual es conservar las relaciones en el
catálogo o en la documentación y ejecutar comprobaciones como el
anti-JOIN anterior durante la ingesta y las pruebas de calidad.
Las tablas con datos delante
El esquema de 24 tablas no hay que memorizarlo: el apéndice lo recoge completo. Lo que sí conviene es reconocer las tablas con las que se trabaja y recordar unas pocas columnas de cada una, y eso se consigue antes viendo filas que leyendo descripciones. Tres pistas ayudan a orientarse:
- el prefijo de una columna dice a qué tabla pertenece;
- las columnas terminadas en
_skson claves: la propia de la tabla o la que apunta a otra; - en una tabla de hechos casi todo son claves hacia dimensiones, seguidas de cantidades e importes.
| Tabla | Prefijo | Una fila es… | Columnas para recordar |
|---|---|---|---|
customer |
c_ |
un cliente | c_customer_sk, c_first_name, c_last_name, c_current_addr_sk |
customer_address |
ca_ |
un domicilio | ca_address_sk, ca_city (municipio), ca_county (provincia), ca_state (código de provincia) |
item |
i_ |
un producto | i_item_sk, i_product_name, i_category, i_current_price |
date_dim |
d_ |
un día del calendario | d_date_sk, d_date, d_year, d_moy |
time_dim |
t_ |
un segundo del día | t_time_sk, t_hour, t_minute |
store |
s_ |
una tienda física | s_store_sk, s_store_name, s_city |
web_sales |
ws_ |
una línea de un pedido web | ws_order_number, ws_item_sk, ws_bill_customer_sk, ws_sold_date_sk, ws_net_profit |
store_sales |
ss_ |
una línea de un ticket de tienda | ss_ticket_number, ss_item_sk, ss_customer_sk, ss_store_sk, ss_net_profit |
Las dos funciones siguientes localizan los ficheros de una tabla y muestran
unas pocas filas de las columnas que se pidan. Ocultan sólo esa
localización, que ya hemos repetido varias veces; la consulta sigue siendo
un SELECT ... LIMIT. Se quitan los espacios de relleno de las columnas
char(n) para que la salida sea legible.
def table_urls(table: str) -> list[str]:
    return [
        f"webhdfs://{path}"
        for path in sorted(webhdfs.glob(f"/datalake/raw/tpcds/{table}/*"))
        if not path.endswith("/_SUCCESS")
    ]


def table_sample(table: str, columns: list[str], rows: int = 5) -> pl.DataFrame:
    selection: str = ", ".join(columns)
    sample_rows: pa.Table = connection.execute(
        f"SELECT {selection} FROM read_parquet(?) LIMIT {rows}",
        [table_urls(table)],
    ).fetch_arrow_table()
    return pl.from_arrow(sample_rows).with_columns(pl.col(pl.String).str.strip_chars())
Personas y lugares. c_current_addr_sk es la clave que lleva de un cliente
a su domicilio; en customer_address, el municipio y la provincia son los
que se asignaron desde el INE:
print(
    table_sample(
        "customer",
        ["c_customer_sk", "c_first_name", "c_last_name", "c_birth_year", "c_current_addr_sk"],
    )
)
print(
    table_sample(
        "customer_address",
        ["ca_address_sk", "ca_street_name", "ca_city", "ca_county", "ca_state"],
    )
)
Productos, fechas, horas y tiendas. Fíjate en que date_dim y time_dim
no guardan ventas: sólo describen cada día y cada segundo, y los hechos
apuntan a ellas con una clave:
print(
    table_sample(
        "item", ["i_item_sk", "i_product_name", "i_category", "i_brand", "i_current_price"]
    )
)
print(table_sample("date_dim", ["d_date_sk", "d_date", "d_year", "d_moy", "d_day_name"]))
print(table_sample("time_dim", ["t_time_sk", "t_hour", "t_minute", "t_am_pm", "t_shift"]))
print(table_sample("store", ["s_store_sk", "s_store_name", "s_city", "s_county"]))
Y los hechos. Casi todas sus columnas son claves hacia las tablas anteriores; por sí solas no dicen quién compró ni qué:
print(
    table_sample(
        "web_sales",
        [
            "ws_order_number",
            "ws_item_sk",
            "ws_bill_customer_sk",
            "ws_bill_addr_sk",
            "ws_sold_date_sk",
            "ws_quantity",
            "ws_net_profit",
        ],
    )
)
print(
    table_sample(
        "store_sales",
        [
            "ss_ticket_number",
            "ss_item_sk",
            "ss_customer_sk",
            "ss_store_sk",
            "ss_quantity",
            "ss_net_profit",
        ],
    )
)
Para leer una línea de venta hay que seguir sus claves. La consulta
siguiente sustituye cuatro claves de web_sales por lo que significan: el
producto, el cliente, el municipio de facturación y la fecha. Es el patrón
de todas las consultas de negocio que vienen a continuación: un hecho y un
JOIN por cada dimensión que haga falta.
readable_sales: pa.Table = connection.execute(
    """
    SELECT
        s.ws_order_number,
        trim(i.i_product_name) AS producto,
        trim(c.c_first_name) || ' ' || trim(c.c_last_name) AS cliente,
        trim(a.ca_city) AS municipio,
        d.d_date AS fecha,
        s.ws_quantity,
        s.ws_net_profit
    FROM read_parquet(?) AS s
    JOIN read_parquet(?) AS i ON s.ws_item_sk = i.i_item_sk
    JOIN read_parquet(?) AS c ON s.ws_bill_customer_sk = c.c_customer_sk
    JOIN read_parquet(?) AS a ON s.ws_bill_addr_sk = a.ca_address_sk
    JOIN read_parquet(?) AS d ON s.ws_sold_date_sk = d.d_date_sk
    LIMIT 5
    """,
    [
        table_urls("web_sales"),
        table_urls("item"),
        table_urls("customer"),
        table_urls("customer_address"),
        table_urls("date_dim"),
    ],
).fetch_arrow_table()
print(pl.from_arrow(readable_sales))
Antes de seguir, intenta responder sin mirar el apéndice: ¿qué columna de
web_sales usarías para llegar al nombre del cliente? ¿Y a la provincia? ¿Y
a la hora de la venta? Si las tres respuestas te salen, ya tienes el mapa
que necesitan las preguntas de negocio.
Preguntas sencillas de negocio sobre las ventas web
Hasta ahora hemos leído columnas y hemos calculado estadísticas para comprobar que los ficheros son coherentes. El siguiente paso es formular preguntas que se parecen a las que haría una persona analista. No necesitamos todavía un catálogo Iceberg ni Spark: las tablas son directorios de Parquet y las relaciones se expresan mediante las claves que aparecen en el esquema.
En estos ejemplos trabajaremos con web_sales, porque contiene las ventas
realizadas a través de la web. Usaremos también dos dimensiones que ya
aparecieron en «Las tablas con datos delante»:
customer_addresstiene una fila por domicilio y su clave esca_address_sk. Sus columnasca_city,ca_countyyca_statecontienen el municipio, la provincia y el código de provincia asignados desde el INE;time_dimtiene una fila por cada segundo del día y su clave est_time_sk;t_hourda la hora.
Sus esquemas completos están en el apéndice.
Las tres preguntas que vamos a responder son:
| Pregunta | Hecho | Dimensión | Clave de unión | Resultado que se estudia |
|---|---|---|---|---|
| ¿Qué cliente ha realizado más pedidos? | web_sales |
customer |
ws_bill_customer_sk = c_customer_sk |
Pedidos distintos por cliente |
| ¿De qué provincia proceden más compras? | web_sales |
customer_address |
ws_bill_addr_sk = ca_address_sk |
Pedidos distintos por provincia (ca_county) |
| ¿Cómo se distribuyen las compras por hora? | web_sales |
time_dim |
ws_sold_time_sk = t_time_sk |
Pedidos distintos por t_hour |
Hay dos detalles importantes antes de consultar:
- Una fila de
web_salesrepresenta una línea de venta, no necesariamente un pedido completo. Por eso usaremoscount(DISTINCT ws_order_number)cuando queramos contar pedidos; si usamoscount(*), estaremos contando líneas. ca_city,ca_countyyca_stateproceden del cruce con el INE; los clientes, las ventas y el resto de la dirección siguen siendo sintéticos.t_hourrepresenta la hora del día, no una fecha concreta.
Localizamos los fragmentos y preparamos las URL que DuckDB necesita. La
exclusión de _SUCCESS sigue siendo obligatoria:
web_sales_root: str = "/datalake/raw/tpcds/web_sales"
customer_root: str = "/datalake/raw/tpcds/customer"
address_root: str = "/datalake/raw/tpcds/customer_address"
time_root: str = "/datalake/raw/tpcds/time_dim"

web_sales_files: list[str] = sorted(
    path for path in webhdfs.glob(f"{web_sales_root}/*") if not path.endswith("/_SUCCESS")
)
customer_files: list[str] = sorted(
    path for path in webhdfs.glob(f"{customer_root}/*") if not path.endswith("/_SUCCESS")
)
address_files: list[str] = sorted(
    path for path in webhdfs.glob(f"{address_root}/*") if not path.endswith("/_SUCCESS")
)
time_files: list[str] = sorted(
    path for path in webhdfs.glob(f"{time_root}/*") if not path.endswith("/_SUCCESS")
)

web_sales_urls: list[str] = [f"webhdfs://{path}" for path in web_sales_files]
customer_urls: list[str] = [f"webhdfs://{path}" for path in customer_files]
time_urls: list[str] = [f"webhdfs://{path}" for path in time_files]

print(len(web_sales_files), "ficheros de web_sales")
print(len(customer_files), "ficheros de customer")
print(len(address_files), "ficheros de customer_address")
print(len(time_files), "ficheros de time_dim")
Comprueba las listas anteriores antes de continuar. Si alguna está vacía, no se trata de un resultado de la consulta: significa que la tabla no se ha generado, que se ha utilizado otra escala o que WebHDFS no está accesible desde el NameNode.
Cliente con más pedidos: PyArrow
Comenzamos sin unir todavía la dimensión customer. El identificador
ws_bill_customer_sk basta para encontrar los clientes con más pedidos y
permite concentrarnos en la agregación. Seleccionamos solo las dos columnas
necesarias de web_sales.
sales_for_customer: pa.Table = pq.read_table(
    web_sales_files,
    filesystem=arrow_fs,
    columns=["ws_bill_customer_sk", "ws_order_number"],
)
sales_for_customer = sales_for_customer.filter(
    pc.is_valid(sales_for_customer["ws_bill_customer_sk"])
)

top_customer_keys: pa.Table = (
    sales_for_customer.group_by("ws_bill_customer_sk")
    .aggregate([("ws_order_number", "count_distinct")])
    .rename_columns(["ws_bill_customer_sk", "orders"])
    .sort_by([("orders", "descending")])
    .slice(0, 10)
)

print(top_customer_keys)
La primera fila contiene la clave surrogate del cliente que tiene más
pedidos distintos en web_sales. El valor no es todavía c_customer_id,
que es el identificador de negocio de la dimensión customer; obtenerlo
mediante una unión es una ampliación útil, que haremos más abajo con
DuckDB. La agregación se hace en el proceso Python de este notebook, de
modo que este ejemplo enseña lectura y análisis local de Parquet, no
ejecución distribuida.
Provincia con más compras: Polars
Ahora añadimos la dirección de facturación. Como estamos leyendo objetos remotos de WebHDFS, abrimos cada fragmento y seleccionamos solo las columnas necesarias. Esta forma explícita permite ver que una tabla lógica puede estar formada por varios ficheros físicos.
sales_parts: list[pl.DataFrame] = []
for path in web_sales_files:
    with webhdfs.open(path, "rb") as source:
        sales_parts.append(
            pl.read_parquet(
                source,
                columns=[
                    "ws_bill_addr_sk",
                    "ws_order_number",
                    "ws_ext_sales_price",
                ],
            )
        )
sales_for_province: pl.DataFrame = pl.concat(sales_parts, how="vertical")

address_parts: list[pl.DataFrame] = []
for path in address_files:
    with webhdfs.open(path, "rb") as source:
        address_parts.append(
            pl.read_parquet(
                source,
                columns=["ca_address_sk", "ca_city", "ca_county", "ca_state"],
            )
        )
addresses: pl.DataFrame = pl.concat(address_parts, how="vertical")

province_summary: pl.DataFrame = (
    sales_for_province.join(
        addresses,
        left_on="ws_bill_addr_sk",
        right_on="ca_address_sk",
        how="left",
    )
    .filter(pl.col("ca_county").is_not_null())
    .group_by(["ca_state", "ca_county"])
    .agg(
        pl.col("ws_order_number").n_unique().alias("orders"),
        pl.col("ws_ext_sales_price").sum().alias("sales"),
    )
    .sort(["orders", "ca_state"], descending=[True, False])
    .head(10)
)

print(province_summary)
La salida ordena provincias por número de pedidos distintos y añade el
importe extendido como segunda medida. ca_county contiene la denominación
oficial y ca_state su código INE de dos caracteres. El JOIN de negocio
sigue haciéndose por la clave de dirección, no por textos geográficos: los
nombres sirven para describir y agrupar el resultado.
Comprobar la procedencia de los lugares
Leemos también el CSV gzip del INE desde HDFS y hacemos un segundo JOIN.
El flujo se abre con gzip.GzipFile porque WebHDFS entrega los bytes
comprimidos; Polars recibe el texto descomprimido. Esta comprobación no
genera direcciones: verifica que cada municipio y provincia materializados
en customer_address existen en la fuente pública.
import gzip

ine_path: str = "/datalake/raw/ine/municipios/municipios-2026.csv.gz"
with webhdfs.open(ine_path, "rb") as source, gzip.GzipFile(fileobj=source) as decompressed:
    ine_municipalities: pl.DataFrame = pl.read_csv(
        decompressed,
        separator=";",
        schema_overrides={
            "municipio_id": pl.String,
            "provincia_id": pl.String,
            "codigo_municipio": pl.String,
            "digito_control": pl.String,
        },
    )

address_places: pl.DataFrame = addresses.select(
    pl.col("ca_city").str.strip_chars().alias("municipio"),
    pl.col("ca_county").str.strip_chars().alias("provincia"),
    pl.col("ca_state").str.strip_chars().alias("provincia_id"),
).unique()

unknown_places: pl.DataFrame = address_places.join(
    ine_municipalities.select("municipio", "provincia", "provincia_id"),
    on=["municipio", "provincia", "provincia_id"],
    how="anti",
)

print(f"Municipios del catálogo INE: {ine_municipalities.height}")
print(f"Lugares distintos usados en customer_address: {address_places.height}")
print(f"Lugares sin correspondencia en el INE: {unknown_places.height}")
assert ine_municipalities.height == 8_132
assert unknown_places.is_empty()
Distribución horaria de las compras: DuckDB
DuckDB permite expresar la misma relación con SQL mientras mantiene los Parquet en HDFS. Usamos la misma conexión y las listas de URL preparadas anteriormente. La consulta devuelve una fila por hora del día.
from decimal import Decimal

hourly_sales: list[tuple[int, int, Decimal | None]] = connection.execute(
    """
    SELECT
        t.t_hour,
        count(DISTINCT s.ws_order_number) AS orders,
        sum(s.ws_ext_sales_price) AS sales
    FROM read_parquet(?) AS s
    JOIN read_parquet(?) AS t
        ON s.ws_sold_time_sk = t.t_time_sk
    GROUP BY t.t_hour
    ORDER BY t.t_hour
    """,
    [web_sales_urls, time_urls],
).fetchall()

for hour, orders, sales in hourly_sales:
    print(f"hora={hour:02d} pedidos={orders} ventas={sales}")
El JOIN traduce la clave ws_sold_time_sk del hecho a la hora legible
t_hour de la dimensión. No se debe unir por t_time, porque esa columna
es la representación numérica de la hora completa y no la clave que
utiliza web_sales. El resultado permite observar si las compras están
concentradas en determinadas horas y comparar el número de pedidos con el
importe total.
Recuperar el identificador del cliente con DuckDB
La versión PyArrow mostraba la clave surrogate. Con DuckDB podemos añadir
la dimensión customer y devolver c_customer_id, que es un identificador
estable dentro del dataset sintético. Esta consulta responde directamente a
la pregunta de negocio "¿qué cliente ha realizado más pedidos?":
top_customers: list[tuple[str, int, Decimal | None]] = connection.execute(
    """
    SELECT
        c.c_customer_id,
        count(DISTINCT s.ws_order_number) AS orders,
        sum(s.ws_ext_sales_price) AS sales
    FROM read_parquet(?) AS s
    JOIN read_parquet(?) AS c
        ON s.ws_bill_customer_sk = c.c_customer_sk
    GROUP BY c.c_customer_id
    ORDER BY orders DESC, c.c_customer_id
    LIMIT 10
    """,
    [web_sales_urls, customer_urls],
).fetchall()

for customer_id, orders, sales in top_customers:
    print(f"cliente={customer_id} pedidos={orders} ventas={sales}")
El resultado es determinista para la misma versión del generador y la
misma escala, pero los identificadores representan clientes sintéticos. No
se debe interpretar que se ha identificado a una persona real, ni que el
cliente con más líneas sea necesariamente el que tiene más pedidos:
comprueba ambas métricas cambiando count(DISTINCT s.ws_order_number) por
count(*).
Actividades de los casos de uso
- Ejecuta las tres consultas y guarda la primera fila de cada resultado.
- Repite la consulta del cliente contando líneas en vez de pedidos distintos. Explica por qué el orden de los clientes puede cambiar.
- Cambia el nivel geográfico de provincia (
ca_county) a municipio (ca_city). Compara el número de grupos. - Comprueba en el CSV del INE que el código
ca_statecoincide con la provincia de tres municipios del resultado. - Explica por qué
ca_zipyca_gmt_offsetno se pueden atribuir al INE con la fuente utilizada. - En la distribución horaria añade
t_am_pm,t_shiftot_meal_timealGROUP BY. Explica qué información aporta cada dimensión. - Reescribe una de las consultas usando otra biblioteca. Compara qué parte es lectura de Parquet, qué parte es unión y qué parte es agregación.
- Comprueba que seleccionar solo las columnas necesarias reduce el esquema que se transporta y evita leer datos que la pregunta no utiliza.
Una consulta que combina varias tablas
La utilidad de un modelo dimensional aparece al combinar un hecho con sus
dimensiones. El siguiente ejemplo consulta ventas de tienda y las
relaciona con fechas y productos: store_sales, el hecho de las ventas en
tienda, y item, la dimensión de productos.
store_sales tiene una fila por línea de ticket y la misma forma que
web_sales: claves hacia las dimensiones, seguidas de cantidades e
importes. item tiene una fila por producto. La consulta usa estas
columnas:
| Columna | Tabla | Qué es |
|---|---|---|
ss_sold_date_sk |
store_sales |
Fecha de la venta; apunta a date_dim.d_date_sk |
ss_item_sk |
store_sales |
Producto vendido; apunta a item.i_item_sk |
ss_ext_sales_price |
store_sales |
Importe de la línea de venta |
i_category |
item |
Categoría del producto |
d_year |
date_dim |
Año de la fecha |
Los esquemas completos están en el apéndice.
Primero se preparan las listas de ficheros, sin incluir los marcadores
_SUCCESS. La función data_files es adecuada aquí porque oculta solo una
operación repetitiva de localización de ficheros; la estructura de la
consulta permanece visible:
def data_files(table: str) -> list[str]:
    root: str = f"/datalake/raw/tpcds/{table}"
    return sorted(path for path in webhdfs.glob(f"{root}/*") if not path.endswith("/_SUCCESS"))


sales_urls: list[str] = [f"webhdfs://{path}" for path in data_files("store_sales")]
date_urls: list[str] = [f"webhdfs://{path}" for path in data_files("date_dim")]
item_urls: list[str] = [f"webhdfs://{path}" for path in data_files("item")]
query: str = """
SELECT
    d.d_year,
    i.i_category,
    sum(s.ss_ext_sales_price) AS sales
FROM read_parquet(?) AS s
JOIN read_parquet(?) AS d
    ON s.ss_sold_date_sk = d.d_date_sk
JOIN read_parquet(?) AS i
    ON s.ss_item_sk = i.i_item_sk
WHERE d.d_year BETWEEN 1998 AND 2000
GROUP BY d.d_year, i.i_category
ORDER BY d.d_year, sales DESC
"""

sales_by_category: list[tuple[object, ...]] = connection.execute(
    query,
    [sales_urls, date_urls, item_urls],
).fetchall()
print(sales_by_category[:10])
La consulta muestra tres aspectos que se retomarán con Spark e Iceberg:
- se lee una tabla de hechos grande y solo se proyectan algunas columnas;
- se filtra una dimensión temporal antes de producir el resultado;
- se combinan claves numéricas entre tablas con roles distintos.
En esta fase DuckDB planifica la consulta desde el cliente. No hay
ejecutores YARN y no se está ejecutando Spark. La transferencia y el
cálculo ocurren según el plan del proceso DuckDB que se ejecuta dentro de
namenode, por lo que no debe confundirse este ejercicio con
procesamiento distribuido.
Las primeras preguntas ante un dataset de ventas
Con un hecho y sus dimensiones delante, las primeras preguntas que se hace
cualquiera son casi siempre las mismas: cuánto se vende, qué se vende más,
cuándo, dónde y a quién. Todas siguen el patrón de la consulta anterior —un
hecho, un JOIN por cada dimensión que haga falta y un GROUP BY— y sólo
cambian la dimensión por la que se agrupa y la medida que se suma.
| Pregunta | Dimensiones | Clave de unión | Se agrupa por |
|---|---|---|---|
| ¿Cuánto se vende en cada canal? | ninguna | — | el propio hecho: tienda, catálogo o web |
| ¿Qué categorías y qué productos se venden más? | item |
ss_item_sk = i_item_sk |
i_category; después i_item_sk |
| ¿Cómo se reparten las ventas por mes? | date_dim |
ss_sold_date_sk = d_date_sk |
d_moy |
| ¿Qué producto se vende más cada mes? | date_dim, item |
las dos anteriores | d_moy y producto |
| ¿Qué producto se vende más en cada provincia? | customer_address, item |
ss_addr_sk = ca_address_sk |
ca_county y producto |
| ¿Dónde viven los clientes? | customer_address, desde customer |
c_current_addr_sk = ca_address_sk |
ca_county |
| ¿Dónde se concentran las ventas? | customer, customer_address |
ss_customer_sk = c_customer_sk |
ca_county |
Antes de consultar conviene fijar tres decisiones, porque cambian el resultado:
- El canal. Se usa
store_sales, el hecho con más filas. Las mismas preguntas valen paraweb_salesycatalog_salescambiando el prefijo de las columnas (ws_,cs_). - La medida. «Venderse más» puede significar más unidades
(
ss_quantity) o más importe (ss_ext_sales_price, el importe de la línea). No dan la misma clasificación, así que cada consulta dice cuál ordena. - La región. Es la provincia del domicilio,
ca_county, con su código enca_state. Desde una venta se llega a ella porss_addr_sk; desde un cliente, porc_current_addr_sk.
Cada pregunta empieza situando los datos: en qué tabla están, qué es una fila y qué columnas intervienen. Cuando la tabla o la columna todavía no se han visto, una consulta pequeña las muestra antes de agregar nada.
table_urls es la función definida en «Las tablas con datos delante».
Las listas item_urls, date_urls, customer_urls y web_sales_urls ya
existen de las secciones anteriores; faltan estas tres:
store_sales_urls: list[str] = table_urls("store_sales")
catalog_sales_urls: list[str] = table_urls("catalog_sales")
address_urls: list[str] = table_urls("customer_address")

print(len(store_sales_urls), "ficheros de store_sales")
print(len(catalog_sales_urls), "ficheros de catalog_sales")
print(len(address_urls), "ficheros de customer_address")
Cuánto se vende en cada canal
TPC-DS no tiene una tabla de canales ni una columna que diga por qué canal se hizo una venta. La empresa vende por tres vías y cada una tiene su propia tabla de hechos: el canal de una venta es, sencillamente, la tabla en la que está.
| Canal | Hecho | Prefijo | Identifica la venta | Dimensiones propias del canal |
|---|---|---|---|---|
| Tienda física | store_sales |
ss_ |
ss_ticket_number |
store (ss_store_sk) |
| Catálogo | catalog_sales |
cs_ |
cs_order_number |
call_center (cs_call_center_sk) y catalog_page (cs_catalog_page_sk) |
| Web | web_sales |
ws_ |
ws_order_number |
web_site (ws_web_site_sk) y web_page (ws_web_page_sk) |
Los tres hechos comparten las dimensiones comunes —producto, cliente,
fecha— y las mismas medidas con su prefijo: *_quantity, las unidades, y
*_ext_sales_price, el importe de la línea. Cada canal tiene además su
tabla de devoluciones (store_returns, catalog_returns y
web_returns), que aquí no se usa.
catalog_sales es el único de los tres que todavía no hemos visto con
datos delante:
print(
    table_sample(
        "catalog_sales",
        [
            "cs_order_number",
            "cs_item_sk",
            "cs_call_center_sk",
            "cs_catalog_page_sk",
            "cs_quantity",
            "cs_ext_sales_price",
        ],
    )
)
Tiene la misma forma que web_sales y store_sales: claves hacia las
dimensiones, seguidas de cantidades e importes. Como el canal no es una
dimensión, la pregunta no necesita ningún JOIN: basta contar y sumar
cada hecho. UNION ALL apila los tres resultados en una sola tabla y el
nombre del canal se escribe como una constante.
sales_by_channel: pa.Table = connection.execute(
    """
    SELECT
        'tienda' AS canal,
        count(*) AS lineas,
        sum(ss_quantity) AS unidades,
        sum(ss_ext_sales_price) AS ventas
    FROM read_parquet(?)
    UNION ALL
    SELECT 'catálogo', count(*), sum(cs_quantity), sum(cs_ext_sales_price)
    FROM read_parquet(?)
    UNION ALL
    SELECT 'web', count(*), sum(ws_quantity), sum(ws_ext_sales_price)
    FROM read_parquet(?)
    ORDER BY ventas DESC
    """,
    [store_sales_urls, catalog_sales_urls, web_sales_urls],
).fetch_arrow_table()
print(pl.from_arrow(sales_by_channel))
La columna lineas debe coincidir con el número de filas de cada hecho
que aparece en la tabla de «TPC-DS y la escala SF1». Es una comprobación
barata de que se están leyendo todos los fragmentos de cada tabla.
Qué categorías y qué productos se venden más
El «qué» de una venta está en item, a la que apuntan ss_item_sk,
cs_item_sk y ws_item_sk. Cada fila describe un producto y lo clasifica
en tres niveles, de más general a más concreto: categoría (i_category),
clase (i_class) y marca (i_brand). i_product_name es su nombre e
i_current_price su precio actual.
Antes de agregar ventas conviene saber cuántos valores distintos tiene
cada nivel, porque ese es el número de filas que devolverá cada
GROUP BY:
item_levels: pa.Table = connection.execute(
    """
    SELECT
        count(*) AS filas,
        count(DISTINCT i_item_id) AS identificadores,
        count(DISTINCT i_category) AS categorias,
        count(DISTINCT i_class) AS clases,
        count(DISTINCT i_brand) AS marcas
    FROM read_parquet(?)
    """,
    [item_urls],
).fetch_arrow_table()
print(pl.from_arrow(item_levels))
Si hay más filas que identificadores es porque item conserva las
versiones sucesivas de un mismo producto: comparten el identificador de
negocio i_item_id y cada versión tiene su propia i_item_sk, que es la
clave que guardan las ventas.
Empezamos por la categoría, el nivel con menos valores, porque su resultado se lee de un vistazo:
sales_by_item_category: list[tuple[str | None, int, Decimal]] = connection.execute(
    """
    SELECT
        trim(i.i_category) AS categoria,
        sum(s.ss_quantity) AS unidades,
        sum(s.ss_ext_sales_price) AS ventas
    FROM read_parquet(?) AS s
    JOIN read_parquet(?) AS i
        ON s.ss_item_sk = i.i_item_sk
    GROUP BY categoria
    ORDER BY ventas DESC
    """,
    [store_sales_urls, item_urls],
).fetchall()

for category, units, sales in sales_by_item_category:
    print(f"categoria={category} unidades={units} ventas={sales}")
Si aparece una fila con categoría None, no es un error de la consulta:
i_category es nulo en algunos productos y GROUP BY reúne todos los
nulos en un grupo propio. Fíjate también en lo poco que se diferencian las
categorías entre sí; es una primera señal de que los datos son sintéticos.
Para bajar al producto se agrupa por su clave, i_item_sk, y no por el
nombre: i_product_name sólo describe el resultado, y dos productos
distintos pueden llamarse igual. Los nombres son palabras generadas, sin
significado.
top_items: pa.Table = connection.execute(
    """
    SELECT
        i.i_item_sk,
        trim(i.i_product_name) AS producto,
        trim(i.i_category) AS categoria,
        sum(s.ss_quantity) AS unidades,
        sum(s.ss_ext_sales_price) AS ventas
    FROM read_parquet(?) AS s
    JOIN read_parquet(?) AS i
        ON s.ss_item_sk = i.i_item_sk
    GROUP BY i.i_item_sk, i.i_product_name, i.i_category
    ORDER BY unidades DESC, i.i_item_sk
    LIMIT 10
    """,
    [store_sales_urls, item_urls],
).fetch_arrow_table()
print(pl.from_arrow(top_items))
La clasificación está ordenada por unidades. Compara las columnas
unidades y ventas: el producto del que más unidades se venden no tiene
por qué ser el que más ingresa. i.i_item_sk aparece al final del
ORDER BY para que los empates se resuelvan siempre igual y el resultado
sea repetible.
Cómo se reparten las ventas por mes
El «cuándo» no está en el hecho como una fecha: ss_sold_date_sk es una
clave hacia date_dim. Esa dimensión tiene una fila por día y trae ya
calculado lo que se suele necesitar para agrupar: año (d_year), mes
(d_moy, month of year), trimestre (d_qoy), día de la semana
(d_day_name) y si es fin de semana (d_weekend) o festivo
(d_holiday). Así no hay que extraer el mes de una fecha en cada
consulta.
El calendario abarca muchos más años que la actividad de la empresa, de modo que lo primero es ver qué periodo cubren realmente las ventas:
from datetime import date

sales_period: list[tuple[int, int, date, date]] = connection.execute(
    """
    SELECT
        d.d_year,
        count(*) AS lineas,
        min(d.d_date) AS primera,
        max(d.d_date) AS ultima
    FROM read_parquet(?) AS s
    JOIN read_parquet(?) AS d
        ON s.ss_sold_date_sk = d.d_date_sk
    GROUP BY d.d_year
    ORDER BY d.d_year
    """,
    [store_sales_urls, date_urls],
).fetchall()

for year, sale_lines, first_day, last_day in sales_period:
    print(f"año={year} lineas={sale_lines} desde={first_day} hasta={last_day}")
Fíjate en el último año: sólo tiene ventas de sus primeros días. Si se
agrupara por mes sin más, esas líneas se sumarían a enero. Por eso la
consulta siguiente se limita a 1998–2002, los años completos, y agrupa
sólo por d_moy para ver la estacionalidad. Las líneas sin fecha
(ss_sold_date_sk nulo) no aparecen en ningún año: el JOIN las descarta.
monthly_sales: list[tuple[int, int, int, Decimal]] = connection.execute(
    """
    SELECT
        d.d_moy AS mes,
        count(DISTINCT s.ss_ticket_number) AS tickets,
        sum(s.ss_quantity) AS unidades,
        sum(s.ss_ext_sales_price) AS ventas
    FROM read_parquet(?) AS s
    JOIN read_parquet(?) AS d
        ON s.ss_sold_date_sk = d.d_date_sk
    WHERE d.d_year BETWEEN 1998 AND 2002
    GROUP BY d.d_moy
    ORDER BY d.d_moy
    """,
    [store_sales_urls, date_urls],
).fetchall()

for month, tickets, units, sales in monthly_sales:
    print(f"mes={month:02d} tickets={tickets} unidades={units} ventas={sales}")
Compara los meses de enero a julio con los de agosto a octubre y con
noviembre y diciembre: ¿se reparten las ventas por igual a lo largo del
año? Como en las ventas web, se cuentan tickets distintos
(ss_ticket_number) y no filas, porque cada fila es una línea de ticket.
Qué producto se vende más cada mes
«El más vendido de cada grupo» no se resuelve con un GROUP BY y un
LIMIT: el LIMIT cortaría el resultado completo, no cada mes. Se hace
en tres pasos, uno por bloque de la consulta:
unidades_por_mesagrega las unidades de cada producto en cada mes;clasificadosnumera los productos dentro de cada mes con la función de ventanarow_number() OVER (PARTITION BY mes ORDER BY unidades DESC);- la consulta final se queda con la posición 1 de cada mes.
top_item_by_month: list[tuple[int, str, str | None, int]] = connection.execute(
    """
    WITH unidades_por_mes AS (
        SELECT
            d.d_moy AS mes,
            i.i_item_sk,
            trim(i.i_product_name) AS producto,
            trim(i.i_category) AS categoria,
            sum(s.ss_quantity) AS unidades
        FROM read_parquet(?) AS s
        JOIN read_parquet(?) AS d
            ON s.ss_sold_date_sk = d.d_date_sk
        JOIN read_parquet(?) AS i
            ON s.ss_item_sk = i.i_item_sk
        WHERE d.d_year BETWEEN 1998 AND 2002
        GROUP BY d.d_moy, i.i_item_sk, i.i_product_name, i.i_category
    ),
    clasificados AS (
        SELECT
            *,
            row_number() OVER (
                PARTITION BY mes
                ORDER BY unidades DESC, i_item_sk
            ) AS posicion
        FROM unidades_por_mes
    )
    SELECT mes, producto, categoria, unidades
    FROM clasificados
    WHERE posicion = 1
    ORDER BY mes
    """,
    [store_sales_urls, date_urls, item_urls],
).fetchall()

for month, product, category, units in top_item_by_month:
    print(f"mes={month:02d} producto={product} categoria={category} unidades={units}")
Sale una fila por mes. El filtro posicion = 1 va en una consulta
exterior porque WHERE se evalúa antes que las funciones de ventana: en
el mismo SELECT que calcula posicion todavía no se puede filtrar por
ella.
Qué producto se vende más en cada provincia
El «dónde» admite dos lecturas en store_sales, y son columnas distintas:
ss_store_skapunta astore: la provincia de la tienda en la que se compró (s_county). TPC-DS SF1 sólo tiene 12 tiendas, así que daría muy pocos grupos;ss_addr_skapunta acustomer_address: la provincia del domicilio del comprador (ca_county). Es la que se usa aquí.
customer_address tiene una fila por domicilio, con el municipio en
ca_city, la provincia en ca_county y su código en ca_state. Las dos
consultas siguientes miden esa dimensión y cuántas líneas de venta llevan
dirección. Los municipios se cuentan como parejas provincia–municipio
porque hay nombres que se repiten en provincias distintas.
address_levels: pa.Table = connection.execute(
    """
    SELECT
        count(*) AS domicilios,
        count(DISTINCT ca_state) AS provincias,
        count(DISTINCT (ca_state, ca_city)) AS municipios
    FROM read_parquet(?)
    """,
    [address_urls],
).fetch_arrow_table()
print(pl.from_arrow(address_levels))

lines_with_address: pa.Table = connection.execute(
    """
    SELECT
        count(*) AS lineas,
        count(ss_addr_sk) AS con_direccion
    FROM read_parquet(?)
    """,
    [store_sales_urls],
).fetch_arrow_table()
print(pl.from_arrow(lines_with_address))
count(columna) no cuenta los nulos: la diferencia entre lineas y
con_direccion son las ventas sin dirección. Un JOIN interior las deja
fuera; es correcto para esta pregunta, pero significa que la suma por
provincias no llega al total del canal.
La consulta es la del producto más vendido de cada mes cambiando la
partición: en lugar del mes, la provincia. Se muestran las diez provincias
cuyo producto estrella acumula más unidades; quita el LIMIT para ver una
fila por provincia.
top_item_by_province: pa.Table = connection.execute(
    """
    WITH unidades_por_provincia AS (
        SELECT
            trim(a.ca_county) AS provincia,
            i.i_item_sk,
            trim(i.i_product_name) AS producto,
            trim(i.i_category) AS categoria,
            sum(s.ss_quantity) AS unidades
        FROM read_parquet(?) AS s
        JOIN read_parquet(?) AS a
            ON s.ss_addr_sk = a.ca_address_sk
        JOIN read_parquet(?) AS i
            ON s.ss_item_sk = i.i_item_sk
        GROUP BY a.ca_county, i.i_item_sk, i.i_product_name, i.i_category
    ),
    clasificados AS (
        SELECT
            *,
            row_number() OVER (
                PARTITION BY provincia
                ORDER BY unidades DESC, i_item_sk
            ) AS posicion
        FROM unidades_por_provincia
    )
    SELECT provincia, producto, categoria, unidades
    FROM clasificados
    WHERE posicion = 1
    ORDER BY unidades DESC, provincia
    LIMIT 10
    """,
    [store_sales_urls, address_urls, item_urls],
).fetch_arrow_table()
print(pl.from_arrow(top_item_by_province))
Dónde viven los clientes
Para contar clientes no hace falta ningún hecho. customer tiene una fila
por cliente, identificada por c_customer_sk, y guarda en
c_current_addr_sk la clave de su domicilio actual en
customer_address. Según la tabla de «TPC-DS y la escala SF1» hay
100.000 clientes y 50.000 domicilios: varios clientes comparten
domicilio, así que hay que contar filas de customer, no de
customer_address.
La consulta cuenta clientes por provincia y añade qué porcentaje del total
representan. sum(count(*)) OVER () es una ventana sin partición: suma
los recuentos de todas las provincias y permite calcular el porcentaje sin
una segunda consulta.
customers_by_province: pa.Table = connection.execute(
    """
    SELECT
        trim(a.ca_county) AS provincia,
        count(*) AS clientes,
        count(DISTINCT a.ca_city) AS municipios_con_clientes,
        round(100.0 * count(*) / sum(count(*)) OVER (), 2) AS pct_clientes
    FROM read_parquet(?) AS c
    JOIN read_parquet(?) AS a
        ON c.c_current_addr_sk = a.ca_address_sk
    GROUP BY a.ca_county
    ORDER BY clientes DESC, provincia
    LIMIT 10
    """,
    [customer_urls, address_urls],
).fetch_arrow_table()
print(pl.from_arrow(customers_by_province))
Dónde se concentran las ventas
Ahora se comparan dos repartos: el de clientes y el de ventas. Para que
sean comparables, los dos usan la misma geografía, la provincia del
domicilio actual del cliente. Por eso aquí la venta llega a la provincia
pasando por el cliente (ss_customer_sk, que apunta a
customer.c_customer_sk) y no por ss_addr_sk.
Antes de dividir ventas entre clientes conviene saber cuántos clientes compran realmente en este canal:
store_buyers: pa.Table = connection.execute(
    """
    SELECT
        count(DISTINCT ss_customer_sk) AS clientes_con_compras,
        count(*) - count(ss_customer_sk) AS lineas_sin_cliente
    FROM read_parquet(?)
    """,
    [store_sales_urls],
).fetch_arrow_table()
print(pl.from_arrow(store_buyers))
Compara clientes_con_compras con los 100.000 clientes de customer: la
diferencia son clientes que nunca han comprado en tienda. La columna
ventas_por_cliente de la consulta siguiente divide entre todos los
clientes de la provincia, compren o no en este canal.
Cada reparto se calcula en su propio bloque y después se unen por el
código de provincia. Si se hiciera todo en un único JOIN de ventas,
clientes y direcciones, cada cliente aparecería repetido una vez por línea
de venta y el recuento de clientes sería incorrecto.
sales_density: pa.Table = connection.execute(
    """
    WITH clientes AS (
        SELECT
            a.ca_state AS provincia_id,
            a.ca_county AS provincia,
            count(*) AS clientes
        FROM read_parquet(?) AS c
        JOIN read_parquet(?) AS a
            ON c.c_current_addr_sk = a.ca_address_sk
        GROUP BY a.ca_state, a.ca_county
    ),
    ventas AS (
        SELECT
            a.ca_state AS provincia_id,
            count(DISTINCT s.ss_ticket_number) AS tickets,
            sum(s.ss_ext_sales_price) AS ventas
        FROM read_parquet(?) AS s
        JOIN read_parquet(?) AS c
            ON s.ss_customer_sk = c.c_customer_sk
        JOIN read_parquet(?) AS a
            ON c.c_current_addr_sk = a.ca_address_sk
        GROUP BY a.ca_state
    )
    SELECT
        trim(c.provincia) AS provincia,
        c.clientes,
        v.tickets,
        round(100.0 * c.clientes / sum(c.clientes) OVER (), 2) AS pct_clientes,
        round(100.0 * v.ventas / sum(v.ventas) OVER (), 2) AS pct_ventas,
        round(v.ventas / c.clientes, 2) AS ventas_por_cliente
    FROM clientes AS c
    JOIN ventas AS v
        ON c.provincia_id = v.provincia_id
    ORDER BY v.ventas DESC, provincia
    LIMIT 10
    """,
    [customer_urls, address_urls, store_sales_urls, customer_urls, address_urls],
).fetch_arrow_table()
print(pl.from_arrow(sales_density))
Compara pct_clientes con pct_ventas. Si una provincia tuviera el 3 % de
los clientes y el 6 % de las ventas, sus clientes comprarían el doble que
la media; ventas_por_cliente resume esa misma idea en una cifra. ¿Hay
provincias que destaquen, o las ventas siguen de cerca a los clientes?
Qué significa «densidad» en estos datos
Los resultados anteriores son recuentos por provincia, no una densidad por habitante ni por kilómetro cuadrado: el catálogo del INE que se ha incorporado sólo trae la relación de municipios, sin población ni superficie. Para calcular esas densidades habría que añadir otra fuente.
Lo que sí permite el catálogo es contar cuántos municipios tiene cada
provincia y compararlo con sus clientes. ine_municipalities es el
DataFrame de Polars leído en «Comprobar la procedencia de los lugares»;
connection.register lo expone a DuckDB como una tabla más, sin copiarlo
a disco.
connection.register("ine_municipios", ine_municipalities)

customers_per_municipality: pa.Table = connection.execute(
    """
    WITH clientes AS (
        SELECT
            trim(a.ca_state) AS provincia_id,
            count(*) AS clientes
        FROM read_parquet(?) AS c
        JOIN read_parquet(?) AS a
            ON c.c_current_addr_sk = a.ca_address_sk
        GROUP BY trim(a.ca_state)
    ),
    catalogo AS (
        SELECT provincia_id, provincia, count(*) AS municipios
        FROM ine_municipios
        GROUP BY provincia_id, provincia
    )
    SELECT
        m.provincia,
        m.municipios,
        c.clientes,
        round(c.clientes / m.municipios, 1) AS clientes_por_municipio
    FROM catalogo AS m
    JOIN clientes AS c
        ON m.provincia_id = c.provincia_id
    ORDER BY c.clientes DESC, m.provincia
    LIMIT 10
    """,
    [customer_urls, address_urls],
).fetch_arrow_table()
print(pl.from_arrow(customers_per_municipality))
Fíjate en qué provincias encabezan la lista y en su columna municipios.
El reparto de clientes sigue al número de municipios del catálogo, no a la
población real: al generar los datos, cada localidad de TPC-DS se asignó a
un municipio del INE, de modo que una provincia con muchos municipios
recibe muchas direcciones aunque sean pueblos pequeños. Los nombres de los
lugares son reales; cuánta gente vive en cada uno, no.
Es la precaución que hay que tener con cualquier dato derivado: antes de interpretar un resultado conviene saber cómo se construyó la columna por la que se agrupa.
Actividades de las primeras preguntas
- Ordena la clasificación de productos por
ventasen lugar de porunidades. ¿Cuántos de los diez primeros se mantienen? - Repite la clasificación de categorías con
web_sales(ws_item_sk,ws_quantity,ws_ext_sales_price). ¿Cambia el orden respecto a la tienda? - Añade
d_yearalGROUP BYde las ventas por mes y quita el filtro de años. Localiza la fila de 2003 y explica por qué se había excluido. - Cambia
posicion = 1porposicion <= 3para obtener los tres productos más vendidos de cada mes. - En la consulta por provincia, sustituye el producto por la categoría. ¿Hay una categoría que domine en casi todas las provincias?
- Baja el reparto de clientes de provincia (
ca_county) a municipio (ca_city). ¿Cuántos clientes tiene el municipio con más clientes? - Explica qué fuente habría que añadir al data lake para calcular clientes por cada mil habitantes y por qué clave se uniría.
Observar el plan y el efecto de seleccionar columnas
DuckDB puede mostrar un plan de ejecución. Es útil comparar una consulta
que selecciona pocas columnas con otra que utiliza SELECT *:
plan: list[tuple[object, ...]] = connection.execute(
    """
    EXPLAIN
    SELECT d_year, d_holiday
    FROM read_parquet(?)
    WHERE d_year = 2000
    """,
    [date_urls],
).fetchall()
print(plan)
plan_select_all: list[tuple[object, ...]] = connection.execute(
    """
    EXPLAIN
    SELECT *
    FROM read_parquet(?)
    WHERE d_year = 2000
    """,
    [date_urls],
).fetchall()
print(plan_select_all)
El formato concreto del plan puede cambiar con la versión de DuckDB. Busca
en cada plan el operador de lectura Parquet y compara las columnas que
proyecta: en el primero, sólo las dos pedidas más el filtro por d_year; en
el segundo, todas las de date_dim. En una tabla columnar, la proyección y el predicado pueden
reducir la cantidad de datos transferidos y descomprimidos. La mejora real
debe medirse: no se deduce únicamente del nombre del operador.
Comprobar el esquema con Trino
Sección informativa, sin celdas ejecutables. Trino permite confirmar el
esquema generado. Su cliente necesita una terminal interactiva (-it) y el
binario trino no está instalado dentro de namenode, así que esto se
ejecuta desde una terminal de tu equipo, no desde este notebook:
docker exec -it trino-hdfs trino --server http://trino-hdfs:8080 --user luser
En la consola se pueden ejecutar:
SHOW SCHEMAS FROM tpcds;
SHOW TABLES FROM tpcds.sf1;
DESCRIBE tpcds.sf1.date_dim;
DESCRIBE tpcds.sf1.store_sales;
SELECT count(*) FROM tpcds.sf1.date_dim;
Para salir de la consola, escribe quit o pulsa Ctrl+D.
Estas tablas pertenecen al conjunto TPC-DS que ofrece el conector de Trino
y sirven para contrastar el esquema y el número de filas. En esta sesión,
los lectores Python trabajan directamente con las copias Parquet escritas
en /datalake, de modo que se pueda observar su ruta física, esquema y
metadatos.
Actividades propuestas
Reconocer la organización HDFS
- Lista
/datalake,/datalake/rawy/datalake/raw/tpcds. Explica qué representa cada nivel. - Compara el tamaño de
date_dim,store_saleseinventory. - Usa
hdfs fsckpara observar bloques y ubicaciones de una tabla pequeña y de una tabla grande. - Comprueba que
_SUCCESSno es un fichero Parquet.
Reconocer el modelo TPC-DS
- Elige una tabla de hechos y enumera las dimensiones a las que apunta.
- Explica qué diferencia hay entre
ss_sold_date_skyd_date. - Busca una consulta que agregue una medida monetaria y otra que agregue cantidades.
- Compara el resultado de consultar tiendas, catálogo y web por separado.
Comparar lectores
- Lee
date_dimcon PyArrow seleccionando tres columnas y después todas las columnas. Compara el esquema y el tiempo. - Repite el filtro por año con Polars.
- Ejecuta la consulta equivalente con DuckDB y explica qué parte es SQL y qué parte es acceso a HDFS.
- Escribe una consulta DuckDB que lea
store_salespero devuelva solo año, categoría y suma de ventas. - Comprueba qué ocurre si se incluye accidentalmente
_SUCCESSen la lista de entrada y explica el mensaje de error.
Solución de problemas
Los fallos comunes a todas las sesiones —kernel equivocado, Jupyter parado,
servicios sin arrancar, falta de red o de memoria— están en
entorno/README.md, sección «Solución de problemas». Aquí van los propios
de esta sesión.
No aparece ningún fichero
Comprueba que el clúster y Trino están arrancados desde una terminal de tu equipo, en la raíz de la distribución:
make -C entorno status
Si algún servicio termina con error, consulta su salida:
docker compose -f entorno/compose-warehouse-hdfs.yml ps -a
docker compose -f entorno/compose-warehouse-hdfs.yml logs trino-hdfs hive-metastore
Después vuelve a la primera celda que falló: sus excepciones distinguen un problema de instantánea, HDFS, esquema o consulta Trino.
WebHDFS no responde desde Python
Esto sí se puede diagnosticar desde este notebook, porque solo necesita
resolver el nombre namenode y hablar HTTP con él — algo que ya funciona
al ejecutarse este kernel dentro del propio contenedor:
!curl --fail "http://namenode:9870/webhdfs/v1/datalake?op=GETFILESTATUS&user.name=luser"
Si esta orden falla, el problema es del clúster HDFS en sí (o de que
namenode no está arrancado), no de la parte Python de esta sesión.
Si en cambio la orden anterior funciona pero Python sigue fallando, revisa
que la conexión fsspec se haya abierto con user="luser" y que se haya
excluido _SUCCESS de la lista de ficheros.
DuckDB dice que un fichero es demasiado pequeño
La causa habitual es haber utilizado un patrón que incluye _SUCCESS.
Lista los nombres con webhdfs.glob y filtra el marcador antes de
construir las URL webhdfs://.
Falta memoria
No cargues simultáneamente varias tablas grandes en listas de DataFrames.
Empieza con date_dim o item, selecciona pocas columnas y procesa los
fragmentos por separado. El NameNode tiene recursos para lanzar clientes y
trabajos, pero no se pretende que un único proceso local mantenga todo SF1
descomprimido en memoria.
Parar, regenerar y borrar
Estas órdenes necesitan el Docker del host o son destructivas para los datos de las siguientes sesiones, así que se muestran como texto para ejecutarlas en una terminal de tu equipo — nunca como celdas de este notebook, para que un "ejecutar todo" no pueda borrar nada por accidente. Todas se escriben desde la raíz de la distribución.
entorno/Makefile ofrece cuatro órdenes, de menos a más destructiva. Las
dos primeras conservan todos los datos; las dos últimas borran volúmenes:
| Orden | Qué hace | Qué se conserva | Qué se pierde |
|---|---|---|---|
make -C entorno stop |
Para los contenedores sin eliminarlos (docker compose stop) |
Todo: HDFS, los metadatos del Hive Metastore y también el interior de cada contenedor (ficheros del directorio de trabajo del kernel, /tmp de namenode, histórico del Timeline Server) |
Sólo los procesos en marcha: Jupyter y las variables de los kernels |
make -C entorno down |
Elimina los contenedores (docker compose down) |
Los volúmenes Docker: HDFS (/datalake, /warehouse, /user) y los metadatos del Hive Metastore |
Lo que vivía dentro de los contenedores: ficheros locales de namenode e histórico del Timeline Server |
make -C entorno clean |
down y, además, borra el volumen de PostgreSQL (Hive Metastore) y el del almacenamiento de objetos de la sesión 3 |
Todo HDFS: el dataset TPC-DS/INE de esta sesión sigue disponible | Las definiciones de tablas del metastore y los objetos de la sesión 3 |
make -C entorno clean-hdfs |
clean y, además, borra los volúmenes HDFS de namenode y de los tres DataNodes |
Sólo las imágenes ya descargadas | Todos los datos, incluido el trabajo de la Sesión 1: el siguiente arranque parte de un HDFS recién formateado |
Para el uso normal entre sesiones basta stop. down sirve para recrear los
contenedores sin perder datos, por ejemplo si alguno ha quedado en mal
estado. clean y clean-hdfs son deliberadamente destructivas y se
ejecutan por separado para que borrar el HDFS sea siempre una decisión
explícita.
Después de cualquiera de las cuatro, el laboratorio se arranca con la misma orden:
make -C entorno warehouse-up
Tras stop reanuda los mismos contenedores; tras down, clean o
clean-hdfs los crea de nuevo sobre los volúmenes que queden. En todos los
casos Jupyter, que vive en namenode, se ha detenido: relánzalo como en
«Antes de empezar: Jupyter en namenode» y reconecta el kernel.
make -C entorno status muestra en cada momento qué contenedores están en
marcha y cuáles parados.
Los Parquet y el resto del HDFS sobreviven a down y a clean porque
compose-hadoop-cluster.yml declara un volumen Docker con nombre para
dfs.namenode.name.dir y otro por cada dfs.datanode.data.dir (ver la
Sesión 1): un volumen con nombre no desaparece con los contenedores.
Si sólo quieres regenerar TPC-DS sin perder el resto del HDFS (por ejemplo,
/user o los datos de otras sesiones), con el clúster arrancado puedes quitar
solo esa ruta (orden destructiva para todos los Parquet de SF1). Desde una
terminal de tu equipo:
docker exec namenode su - luser -c 'hdfs dfs -rm -r -skipTrash /datalake/raw/tpcds'
Es la misma orden que, escrita como !hdfs dfs -rm -r -skipTrash /datalake/raw/tpcds, funcionaría en una celda de este notebook; se deja
fuera de las celdas para que no se ejecute por accidente.
Después se vuelve a ejecutar desde la comprobación de la instantánea gzip hasta la validación de la materialización. No hace falta descargar otra edición ni salir del notebook.
No es necesario borrar el clúster para repetir una consulta ni para volver
a leer los ficheros. Se debe reservar make -C entorno clean-hdfs y el borrado de
/datalake/raw/tpcds para una regeneración intencionada.
Preguntas para interpretar la experiencia
- ¿Qué información falta para que un usuario pueda referirse a una ruta de
/datalakecomo si fuera una tabla con nombre? - ¿Qué diferencia habría entre registrar estos Parquet como tabla externa y
copiarlos a
/warehousecomo tabla administrada? - ¿Qué ventajas aportaría conservar snapshots y metadatos de Iceberg frente a esta lectura directa de ficheros?
- ¿Qué columnas elegirías para particionar las ventas y cuáles podrían producir demasiados directorios?
- ¿Por qué PyArrow, Polars y DuckDB pueden dar exactamente el mismo
resumen
TCDM_SUMMARYusando tres caminos de acceso distintos? - En las preguntas de negocio, ¿qué cambiaría en el resultado si se contaran líneas de venta en lugar de pedidos distintos?
Evidencias para la siguiente sesión
Antes de la siguiente sesión tendrás una reunión individual de unos 5 minutos con el profesor para revisar el trabajo de esta sesión. Esa reunión combina una demostración en vivo sobre tu propio ordenador y una memoria escrita breve. Mantén el datalake de esta sesión disponible hasta entonces.
Qué mostrar en el ordenador durante la reunión
Ten preparado y a mano, funcionando en tu propio equipo:
- La salida de
hdfs dfs -du -h -s /datalake/raw/tpcdscon el tamaño lógico y replicado del dataset completo. - Las tres líneas
TCDM_SUMMARY(PyArrow, Polars, DuckDB) de la lectura dedate_dim, mostrando que coinciden en filas, mínimo, máximo y suma ded_date_sk. - El resultado del anti-
JOINdeweb_salescontracustomer(debería ser cero filas huérfanas). - La primera fila de cada una de las tres preguntas de negocio: cliente con más pedidos, provincia con más compras y hora con más pedidos.
- El plan de
EXPLAINde la consulta filtrada por año sobredate_dim. - Que sabes explicar qué se observa al leer Parquet por su ruta física y qué información aportará después un catálogo de tablas.
Memoria escrita (una o dos páginas)
Trae también un documento breve —una o dos páginas, no hace falta más— que no se limite a pegar capturas de las órdenes anteriores: debe explicar con tus propias palabras la diferencia entre un data lake, un data warehouse y un catálogo, el papel de las capas raw, silver y gold, y por qué PyArrow, Polars y DuckDB obtienen el mismo resultado leyendo los mismos ficheros por caminos distintos.
Qué es importante de cara al examen final
El examen no pide recordar la sintaxis exacta de una orden. Debes poder explicar:
- para qué sirve cada herramienta usada en esta sesión —WebHDFS/
fsspeccomo acceso remoto sin cliente nativo, PyArrow como formato y esquema columnar, Polars como motor de DataFrames en memoria, DuckDB como motor SQL local sobre ficheros remotos, Trino como motor SQL distribuido que cruzó las fuentes y escribió los Parquet— y cómo se conectan entre sí; - qué es un data lake, qué es un data warehouse y qué añade un catálogo de tablas sobre unos simples ficheros;
- qué distingue las capas raw, silver y gold, y en qué capa está el dataset de esta sesión;
- la diferencia entre una operación que lee datos y otra que sólo consulta metadatos (esquema, tamaño, número de filas).
Continuación del curso
El flujo de las siguientes sesiones será:
- copiar estos mismos Parquet a un almacenamiento de objetos compatible con S3 y leerlos desde allí con las mismas tres bibliotecas (sesión 3);
- incorporar Spark como motor distribuido y comprobar qué ejecutores trabajan en los DataNodes;
- registrar o crear tablas mediante Hive Metastore e Iceberg;
- comparar tablas externas de Parquet con tablas administradas en
/warehouse; - estudiar particiones, selección de columnas, predicate pushdown y estadísticas;
- estudiar snapshots, evolución de esquema, ordenación y otras optimizaciones de Iceberg.
Esta sesión se centra en la ubicación, el esquema y los metadatos físicos de los Parquet. Esa base permitirá observar después qué información añade un catálogo y cómo la utilizan el metastore e Iceberg.
Apéndice: esquema completo de TPC-DS SF1
Lectura de referencia, sin celdas ejecutables. Este apéndice reproduce el esquema de columnas de las 24 tablas de negocio de TPC-DS SF1, organizado igual que la especificación: primero las dimensiones y tablas auxiliares, después las tablas de hechos. El flujo principal de la sesión sólo presenta las columnas que usa cada ejemplo; aquí están las 24 tablas completas, para consulta puntual.
PK identifica una clave primaria, FK una clave ajena y BK una clave de
negocio útil para reconocer el mismo objeto fuera del almacén. En las tablas
de hechos la clave primaria es compuesta y sus componentes se indican como
(1/2), (2/2), (1/3), etc.
Las relaciones son lógicas: Parquet no impone claves ajenas y TPC-DS deja
opcional la integridad referencial. Por eso se marcan aquí para que puedan
comprobarse mediante JOIN o anti-JOIN — más adelante en esta sesión se
declarará una copia relacional con restricciones en DuckDB. Fuente:
TPC-DS v4.0.0.
Diagramas de referencia del esquema
Los tres diagramas siguientes resumen visualmente las 24 tablas descritas en
el resto de este apéndice: qué tablas son dimensiones y cuáles son hechos, cuál
es la clave primaria de cada una y cómo se relacionan mediante claves ajenas.
Se generan con s2/generate_tpcds_diagrams.py (Graphviz dot + matplotlib) a
partir de los mismos datos que las tablas Markdown de abajo, y las imágenes
PNG se publican en las páginas del curso, que es de donde las toma este
notebook; también puedes abrirlas sueltas o a mayor resolución.
Diagrama entidad-relación
Una arista va de la tabla que contiene la clave ajena a la tabla que
contiene la clave primaria referenciada. Las tablas de hechos aparecen en
naranja y las dimensiones en azul; varias dimensiones muy referenciadas
(date_dim, item, customer, customer_address...) quedan en el centro
del dibujo porque son las que más tablas conectan.
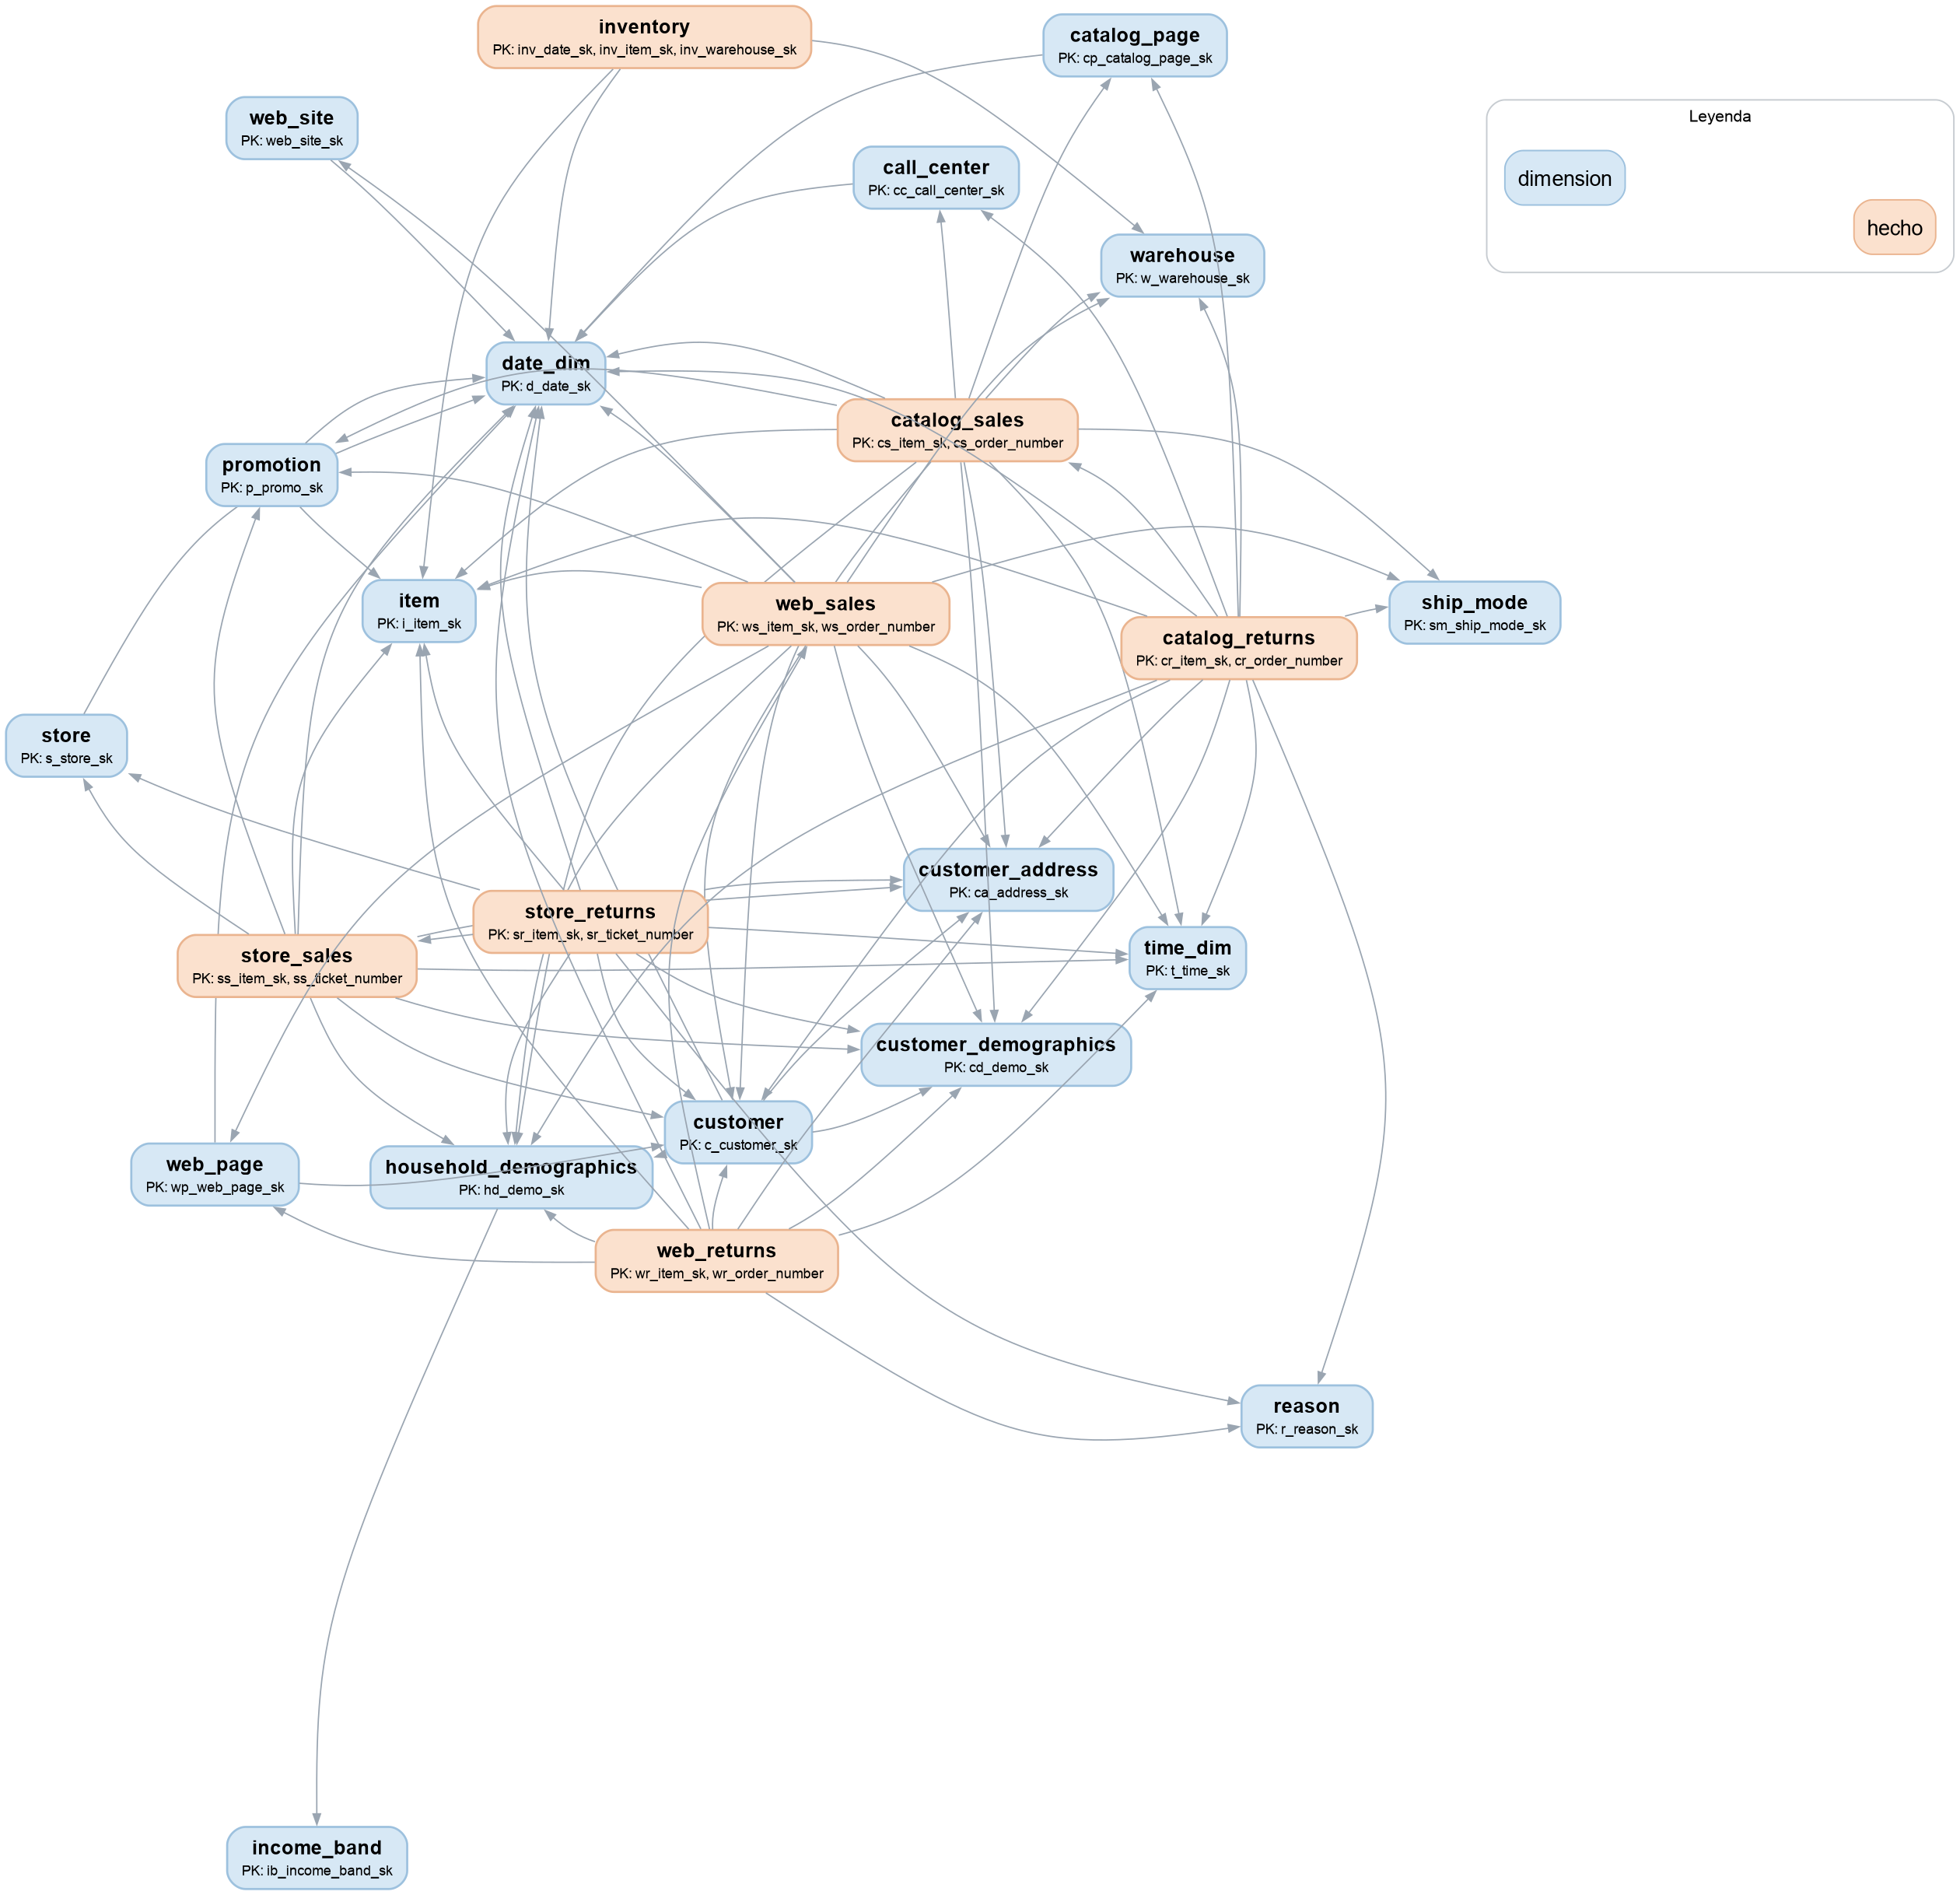
Ficha de referencia: dimensiones
Para cada tabla de dimensión, su clave primaria (PK), su clave de negocio
(BK) si la tiene, y sus claves ajenas con la tabla y columna a la que
apuntan.
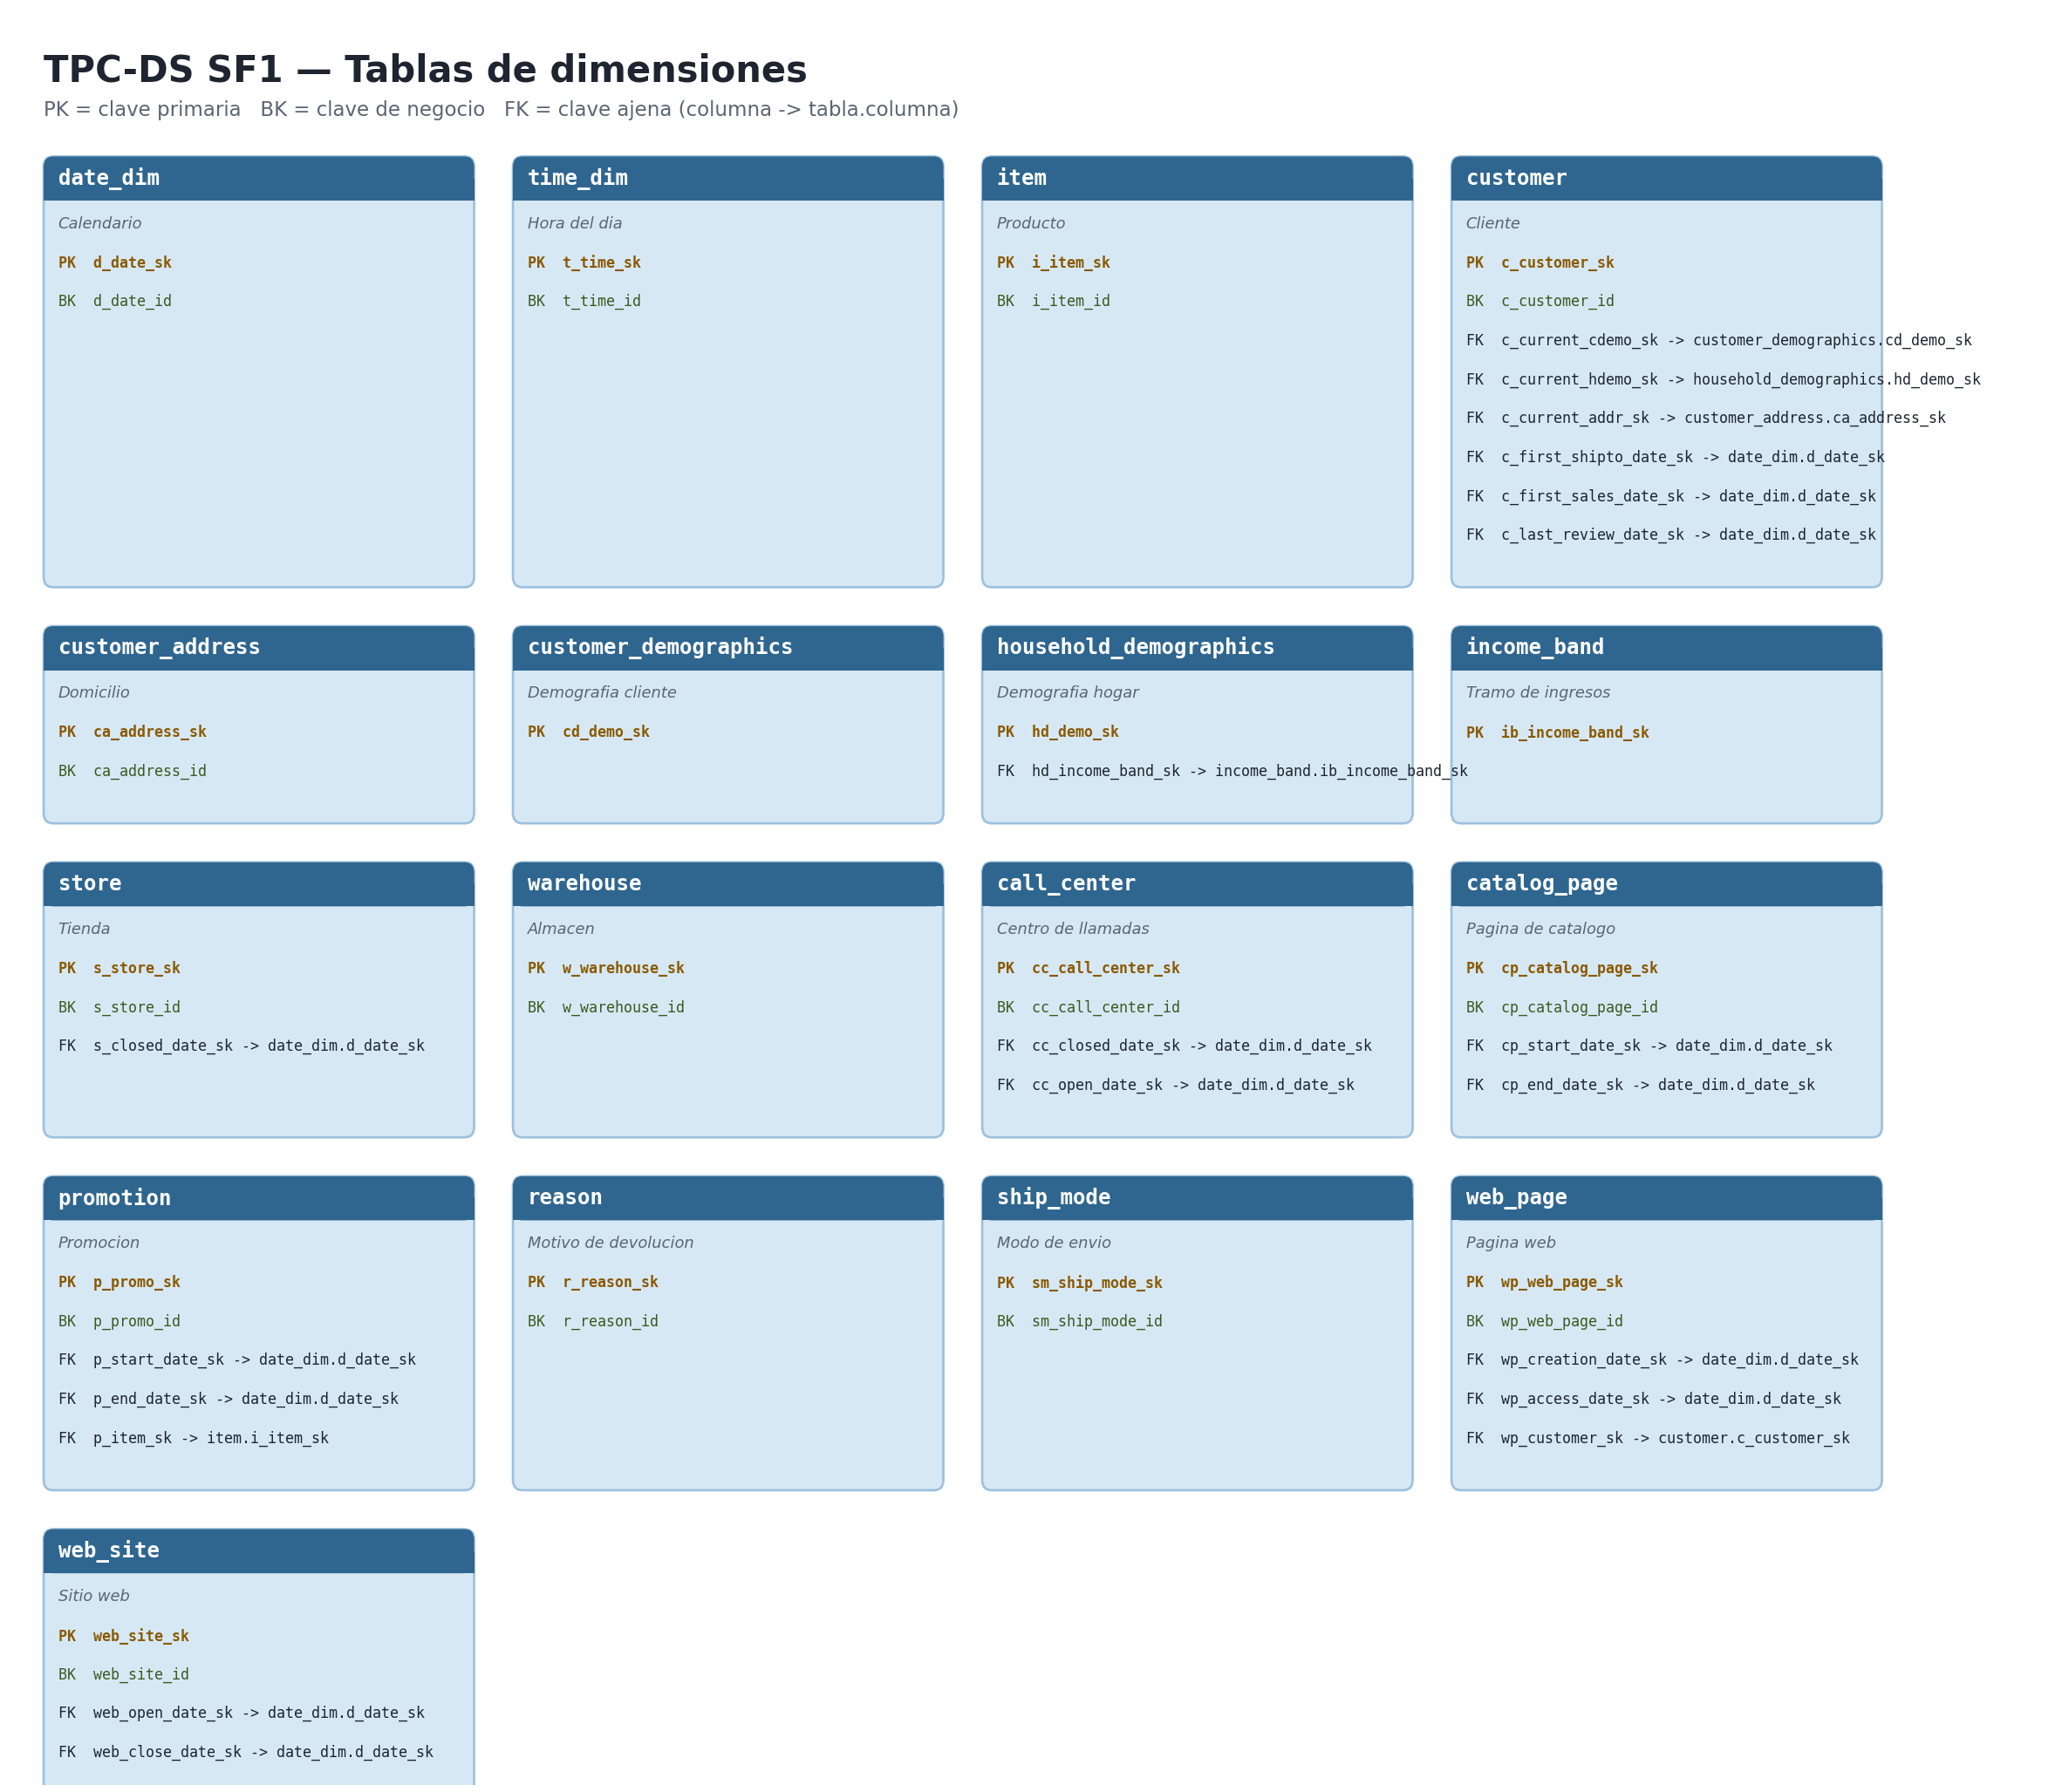
Ficha de referencia: hechos
Las siete tablas de hechos tienen clave primaria compuesta (marcada como
PK sobre varias columnas) y muchas más claves ajenas que las dimensiones,
porque cada fila enlaza con casi todas las dimensiones del modelo.
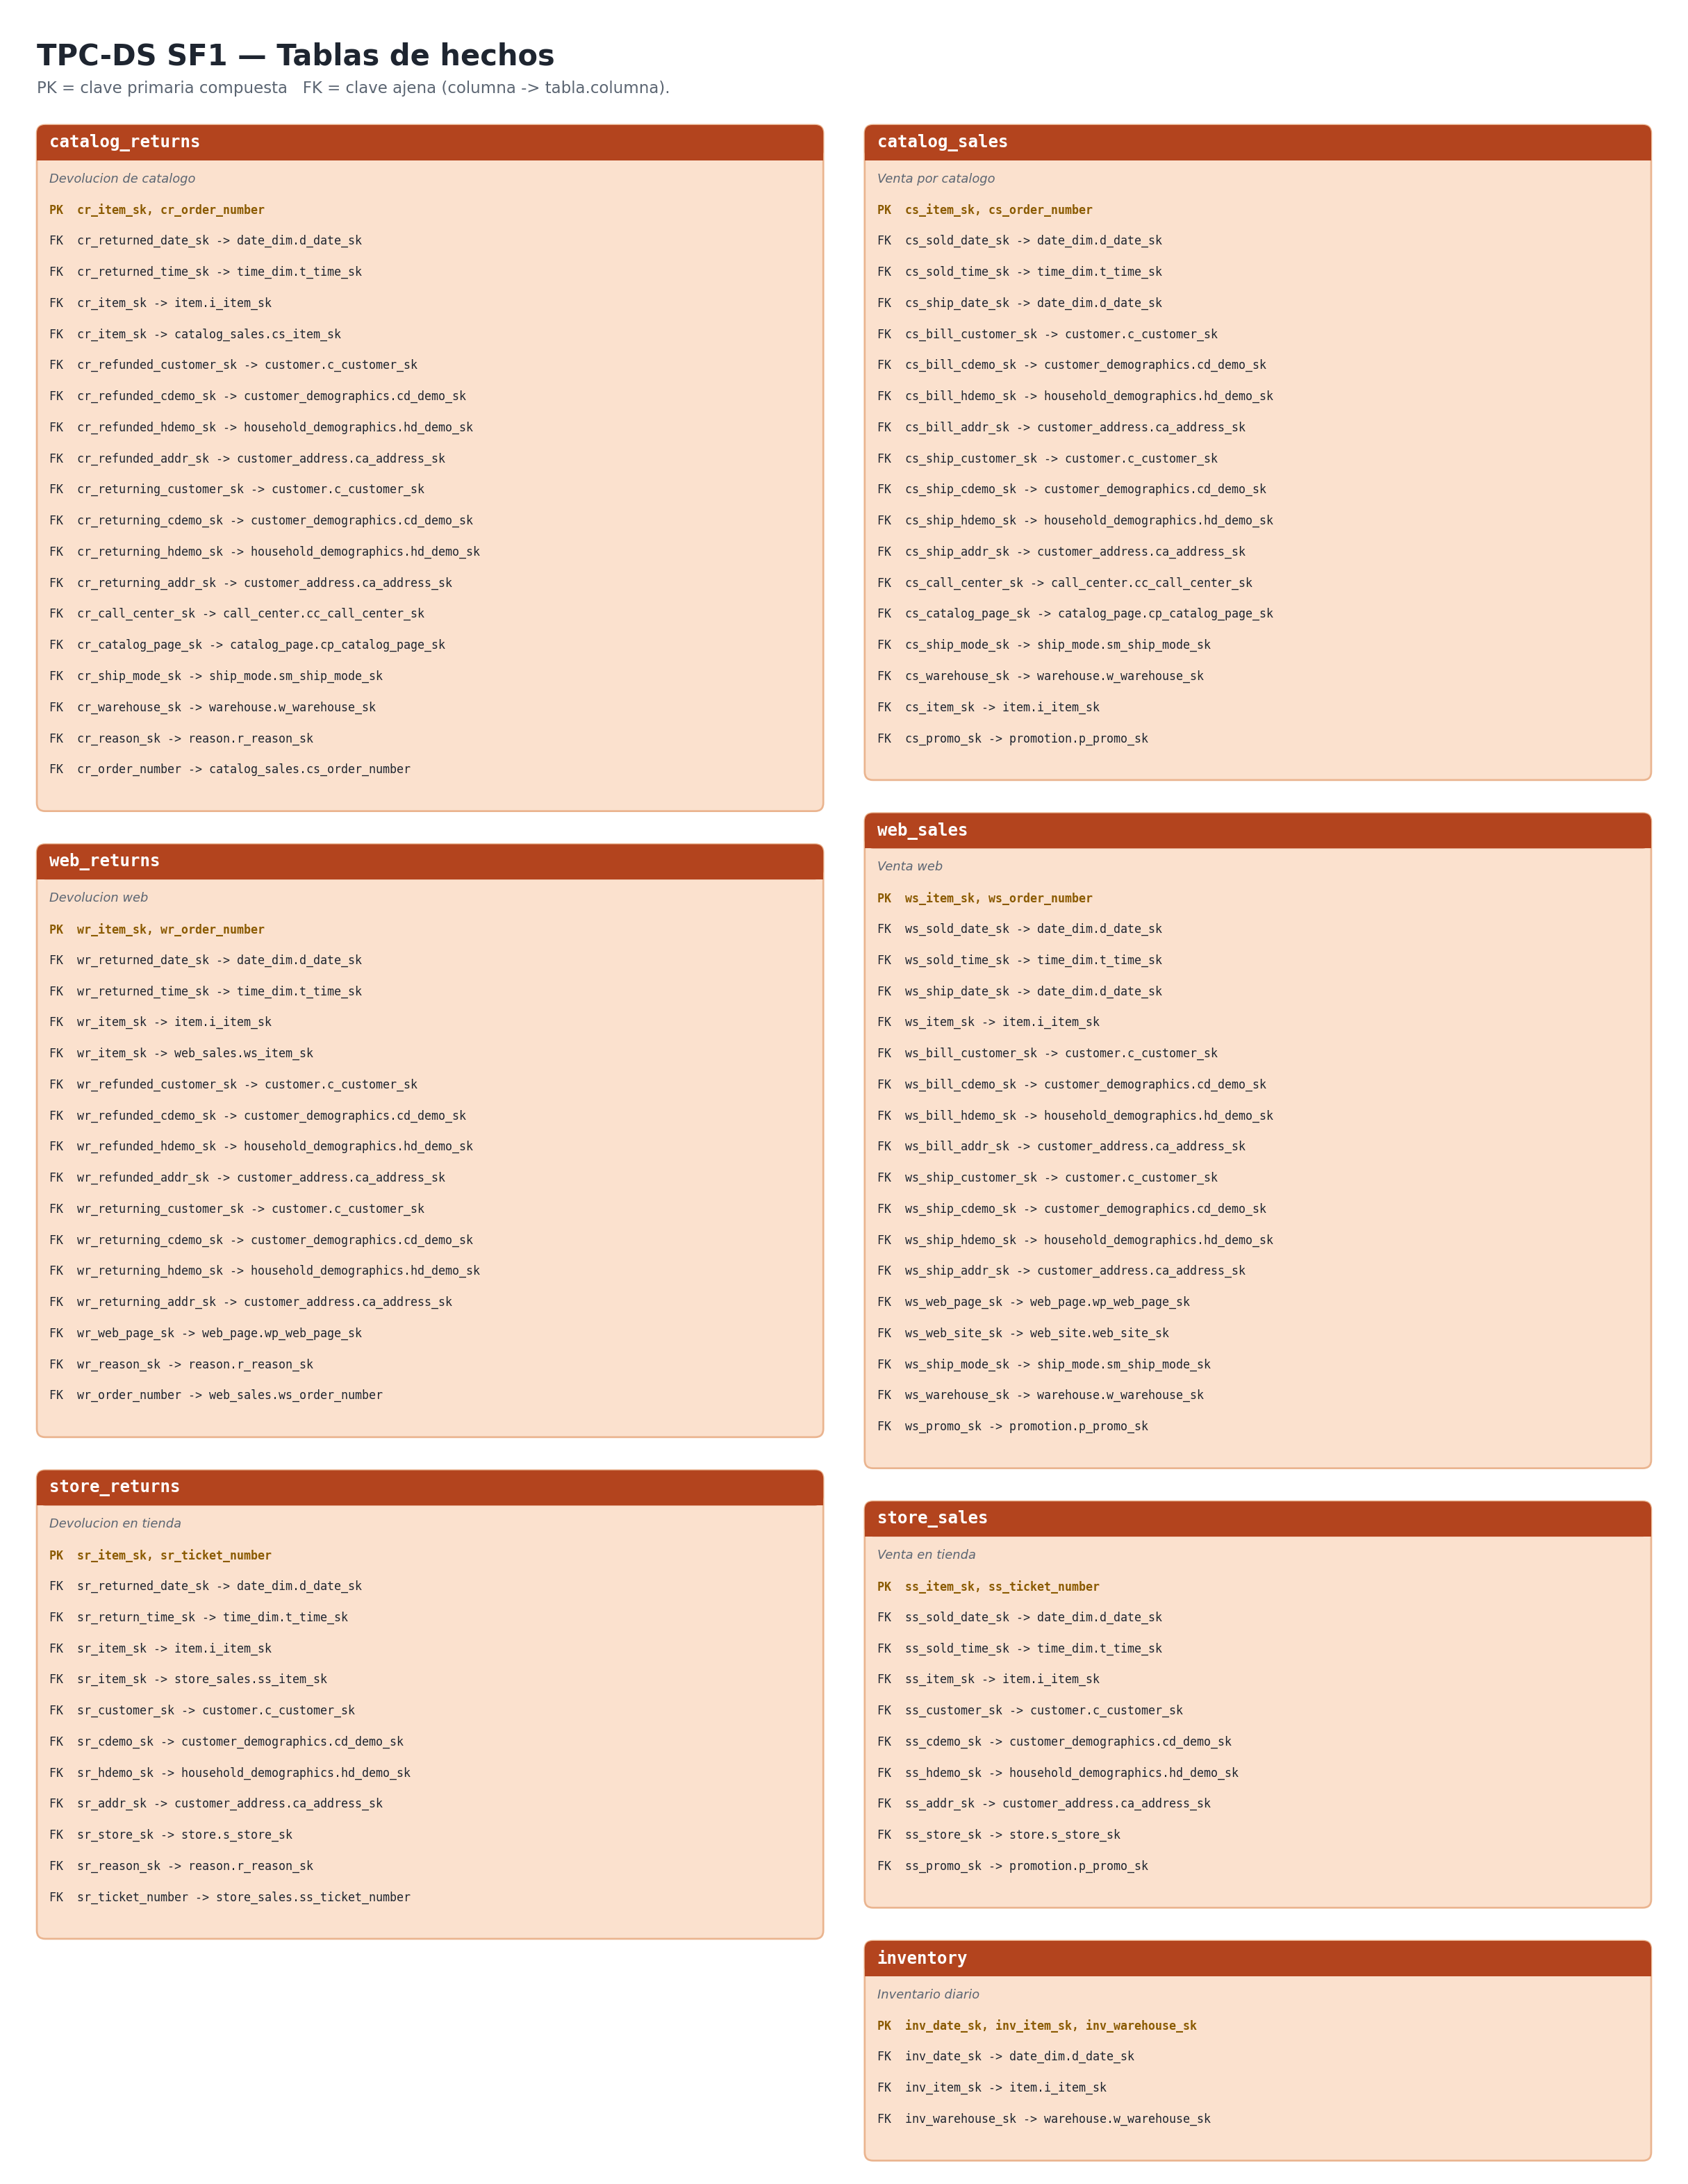
Dimensiones y tablas auxiliares
date_dim
Es el calendario analítico. Incluye la fecha, año, mes, trimestre, día de la semana, información fiscal y marcas como festivo, fin de semana o año actual.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
d_date_sk |
bigint |
Clave surrogate que identifica cada fecha del calendario. | PK |
d_date_id |
char(16) |
Identificador de negocio de la fecha. | BK |
d_date |
date |
Fecha del calendario. | — |
d_month_seq |
integer |
Secuencia del mes en el calendario. | — |
d_week_seq |
integer |
Secuencia de la semana en el calendario. | — |
d_quarter_seq |
integer |
Secuencia del trimestre en el calendario. | — |
d_year |
integer |
Año del calendario. | — |
d_dow |
integer |
Día de la semana, codificado como número. | — |
d_moy |
integer |
Mes del año, codificado como número. | — |
d_dom |
integer |
Día del mes, codificado como número. | — |
d_qoy |
integer |
Trimestre del año, codificado como número. | — |
d_fy_year |
integer |
Año fiscal del calendario. | — |
d_fy_quarter_seq |
integer |
Número secuencial del trimestre fiscal dentro del calendario. | — |
d_fy_week_seq |
integer |
Número secuencial de la semana fiscal dentro del calendario. | — |
d_day_name |
char(9) |
Nombre del día de la semana. | — |
d_quarter_name |
char(6) |
Nombre del trimestre. | — |
d_holiday |
char(1) |
Indicador de día festivo. | — |
d_weekend |
char(1) |
Indicador de fin de semana. | — |
d_following_holiday |
char(1) |
Indicador de día anterior a un festivo. | — |
d_first_dom |
integer |
Primer día del mes. | — |
d_last_dom |
integer |
Último día del mes. | — |
d_same_day_ly |
integer |
Clave del mismo día del año anterior. | — |
d_same_day_lq |
integer |
Clave del mismo día del trimestre anterior. | — |
d_current_day |
char(1) |
Indicador de que es el día actual. | — |
d_current_week |
char(1) |
Indicador de que pertenece a la semana actual. | — |
d_current_month |
char(1) |
Indicador de que pertenece al mes actual. | — |
d_current_quarter |
char(1) |
Indicador de que pertenece al trimestre actual. | — |
d_current_year |
char(1) |
Indicador de que pertenece al año actual. | — |
time_dim
Describe la hora del día, sus componentes y una clasificación de turno y
comida. Se utiliza junto con date_dim para analizar ventas por momento.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
t_time_sk |
bigint |
Clave surrogate que identifica cada segundo del día. | PK |
t_time_id |
char(16) |
Identificador de negocio de hora. | BK |
t_time |
integer |
Instante del día expresado como segundos desde medianoche. | — |
t_hour |
integer |
Hora del día. | — |
t_minute |
integer |
Minuto de la hora. | — |
t_second |
integer |
Segundo del minuto. | — |
t_am_pm |
char(2) |
Indicador de mañana o tarde. | — |
t_shift |
char(20) |
Turno del establecimiento. | — |
t_sub_shift |
char(20) |
Subturno dentro del turno. | — |
t_meal_time |
char(20) |
Franja asociada a una comida. | — |
item
Es la dimensión de productos: identificador, descripción, precios, marca, clase, categoría, fabricante, tamaño, color, unidades y nombre comercial.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
i_item_sk |
bigint |
Clave surrogate que identifica el producto. | PK |
i_item_id |
char(16) |
Identificador de negocio de producto. | BK |
i_rec_start_date |
date |
Fecha de inicio de vigencia de esta versión del registro. | — |
i_rec_end_date |
date |
Fecha de fin de vigencia de esta versión del registro; vacía en la versión vigente. | — |
i_item_desc |
varchar(200) |
Descripción textual del producto. | — |
i_current_price |
decimal(7,2) |
Precio minorista vigente del producto. | — |
i_wholesale_cost |
decimal(7,2) |
Coste mayorista del producto. | — |
i_brand_id |
integer |
Identificador numérico de la marca. | — |
i_brand |
char(50) |
Marca del producto. | — |
i_class_id |
integer |
Identificador numérico de la clase. | — |
i_class |
char(50) |
Clase del producto dentro de su categoría. | — |
i_category_id |
integer |
Identificador numérico de la categoría. | — |
i_category |
char(50) |
Categoría del producto. | — |
i_manufact_id |
integer |
Identificador numérico del fabricante. | — |
i_manufact |
char(50) |
Nombre del fabricante del producto. | — |
i_size |
char(20) |
Tamaño del producto. | — |
i_formulation |
char(20) |
Código de formulación del producto. | — |
i_color |
char(20) |
Color del producto. | — |
i_units |
char(10) |
Unidad de medida del producto. | — |
i_container |
char(10) |
Tipo de envase del producto. | — |
i_manager_id |
integer |
Identificador del responsable del producto. | — |
i_product_name |
char(50) |
Nombre comercial del producto. | — |
customer
Representa al cliente y enlaza con sus datos demográficos, domicilio y fechas de primera compra o envío. Los campos personales son valores sintéticos del benchmark.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
c_customer_sk |
bigint |
Clave surrogate que identifica el cliente. | PK |
c_customer_id |
char(16) |
Identificador de negocio de cliente. | BK |
c_current_cdemo_sk |
bigint |
Perfil demográfico actual del cliente. | FK → customer_demographics.cd_demo_sk |
c_current_hdemo_sk |
bigint |
Perfil actual del hogar del cliente. | FK → household_demographics.hd_demo_sk |
c_current_addr_sk |
bigint |
Dirección actual del cliente. | FK → customer_address.ca_address_sk |
c_first_shipto_date_sk |
bigint |
Fecha del primer envío al cliente. | FK → date_dim.d_date_sk |
c_first_sales_date_sk |
bigint |
Fecha de la primera compra del cliente. | FK → date_dim.d_date_sk |
c_salutation |
char(10) |
Tratamiento o saludo del cliente. | — |
c_first_name |
char(20) |
Nombre de pila del cliente. | — |
c_last_name |
char(30) |
Apellidos del cliente. | — |
c_preferred_cust_flag |
char(1) |
Indicador de cliente preferente. | — |
c_birth_day |
integer |
Día de nacimiento. | — |
c_birth_month |
integer |
Mes de nacimiento. | — |
c_birth_year |
integer |
Año de nacimiento. | — |
c_birth_country |
varchar(20) |
País de nacimiento. | — |
c_login |
char(13) |
Identificador de acceso del cliente. | — |
c_email_address |
char(50) |
Dirección de correo electrónico del cliente. | — |
c_last_review_date_sk |
bigint |
Fecha de la última revisión de los datos del cliente. | FK → date_dim.d_date_sk |
customer_address
Contiene domicilios sintéticos cuyas localidades se han enriquecido con el INE, e incluye también el desplazamiento horario y el tipo de ubicación.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
ca_address_sk |
bigint |
Clave surrogate que identifica la dirección del cliente. | PK |
ca_address_id |
char(16) |
Identificador de negocio de dirección. | BK |
ca_street_number |
char(10) |
Número de la vía. | — |
ca_street_name |
char(60) |
Nombre de la vía. | — |
ca_street_type |
char(15) |
Tipo de vía. | — |
ca_suite_number |
char(10) |
Número de apartamento o suite. | — |
ca_city |
char(60) |
Municipio asignado desde el INE. | — |
ca_county |
char(30) |
Provincia según el INE. | — |
ca_state |
char(2) |
Código INE de provincia. | — |
ca_zip |
char(10) |
Código postal. | — |
ca_country |
char(20) |
País fijado a España tras el cruce. |
— |
ca_gmt_offset |
decimal(5,2) |
Desplazamiento horario respecto de GMT. | — |
ca_location_type |
char(20) |
Tipo de ubicación. | — |
customer_demographics
Agrupa características demográficas utilizadas en consultas analíticas, como estado civil, educación, estimación de compra, crédito y personas dependientes.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
cd_demo_sk |
bigint |
Clave surrogate que identifica la demografía del cliente. | PK |
cd_gender |
char(1) |
Género. | — |
cd_marital_status |
char(1) |
Estado civil. | — |
cd_education_status |
char(20) |
Nivel educativo. | — |
cd_purchase_estimate |
integer |
Estimación del gasto en compras. | — |
cd_credit_rating |
char(10) |
Calificación crediticia. | — |
cd_dep_count |
integer |
Número de personas dependientes. | — |
cd_dep_employed_count |
integer |
Número de dependientes con empleo. | — |
cd_dep_college_count |
integer |
Número de dependientes que cursan estudios universitarios. | — |
household_demographics
Describe el hogar del cliente mediante el tramo de ingresos, potencial de compra, número de dependientes y vehículos.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
hd_demo_sk |
bigint |
Clave surrogate que identifica la demografía del hogar. | PK |
hd_income_band_sk |
bigint |
Tramo de ingresos del hogar. | FK → income_band.ib_income_band_sk |
hd_buy_potential |
char(15) |
Potencial estimado de compra del hogar. | — |
hd_dep_count |
integer |
Número de personas dependientes en el hogar. | — |
hd_vehicle_count |
integer |
Número de vehículos del hogar. | — |
income_band
Define los límites inferior y superior de cada tramo de ingresos.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
ib_income_band_sk |
bigint |
Clave surrogate que identifica el tramo de ingresos. | PK |
ib_lower_bound |
integer |
Límite inferior del tramo de ingresos. | — |
ib_upper_bound |
integer |
Límite superior del tramo de ingresos. | — |
store
Describe las tiendas físicas, su localización, superficie, empleados, horario, mercado y empresa.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
s_store_sk |
bigint |
Clave surrogate que identifica la tienda. | PK |
s_store_id |
char(16) |
Identificador de negocio de tienda. | BK |
s_rec_start_date |
date |
Fecha de inicio de vigencia de esta versión del registro. | — |
s_rec_end_date |
date |
Fecha de fin de vigencia de esta versión del registro; vacía en la versión vigente. | — |
s_closed_date_sk |
bigint |
Fecha de cierre de la tienda. | FK → date_dim.d_date_sk |
s_store_name |
varchar(50) |
Nombre de la tienda. | — |
s_number_employees |
integer |
Número de empleados de la tienda. | — |
s_floor_space |
integer |
Superficie de la tienda. | — |
s_hours |
char(20) |
Horario de apertura de la tienda. | — |
s_manager |
varchar(40) |
Nombre del responsable de la tienda. | — |
s_market_id |
integer |
Identificador del mercado al que pertenece la tienda. | — |
s_geography_class |
varchar(100) |
Clase geográfica de la zona de la tienda. | — |
s_market_desc |
varchar(100) |
Descripción del mercado. | — |
s_market_manager |
varchar(40) |
Nombre del responsable de mercado. | — |
s_division_id |
integer |
Identificador de la división. | — |
s_division_name |
varchar(50) |
Nombre de la división. | — |
s_company_id |
integer |
Identificador de la empresa. | — |
s_company_name |
varchar(50) |
Nombre de la empresa. | — |
s_street_number |
varchar(10) |
Número de la vía. | — |
s_street_name |
varchar(60) |
Nombre de la vía. | — |
s_street_type |
char(15) |
Tipo de vía. | — |
s_suite_number |
varchar(10) |
Número de local o suite. | — |
s_city |
varchar(60) |
Municipio asignado desde el INE. | — |
s_county |
varchar(30) |
Provincia según el INE. | — |
s_state |
char(2) |
Código INE de provincia. | — |
s_zip |
char(10) |
Código postal. | — |
s_country |
varchar(20) |
País fijado a España tras el cruce. |
— |
s_gmt_offset |
decimal(5,2) |
Desplazamiento horario respecto de GMT. | — |
s_tax_precentage |
decimal(5,2) |
Porcentaje de impuesto aplicado en la tienda. | — |
El nombre s_tax_precentage es una errata histórica del esquema TPC-DS y
debe escribirse así en las consultas, aunque semánticamente se refiera al
porcentaje de impuestos.
warehouse
Describe los almacenes de distribución y su ubicación.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
w_warehouse_sk |
bigint |
Clave surrogate que identifica el almacén. | PK |
w_warehouse_id |
char(16) |
Identificador de negocio de almacén. | BK |
w_warehouse_name |
varchar(20) |
Nombre del almacén. | — |
w_warehouse_sq_ft |
integer |
Superficie del almacén en pies cuadrados. | — |
w_street_number |
char(10) |
Número de la vía. | — |
w_street_name |
char(60) |
Nombre de la vía. | — |
w_street_type |
char(15) |
Tipo de vía de la dirección del almacén. | — |
w_suite_number |
char(10) |
Número de local o suite. | — |
w_city |
char(60) |
Municipio asignado desde el INE. | — |
w_county |
char(30) |
Provincia según el INE. | — |
w_state |
char(2) |
Código INE de provincia. | — |
w_zip |
char(10) |
Código postal del almacén. | — |
w_country |
char(20) |
País fijado a España tras el cruce. |
— |
w_gmt_offset |
decimal(5,2) |
Desplazamiento horario del almacén respecto de GMT. | — |
call_center
Describe los centros de atención telefónica: fechas de vigencia, empleados, superficie, dirección, mercado, división y empresa.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
cc_call_center_sk |
bigint |
Clave surrogate que identifica el centro de llamadas. | PK |
cc_call_center_id |
char(16) |
Identificador de negocio de centro de llamadas. | BK |
cc_rec_start_date |
date |
Fecha de inicio de vigencia de esta versión del registro. | — |
cc_rec_end_date |
date |
Fecha de fin de vigencia de esta versión del registro; vacía en la versión vigente. | — |
cc_closed_date_sk |
integer |
Fecha de cierre del centro. | FK → date_dim.d_date_sk |
cc_open_date_sk |
integer |
Fecha de apertura del centro. | FK → date_dim.d_date_sk |
cc_name |
varchar(50) |
Nombre del centro de llamadas. | — |
cc_class |
varchar(50) |
Clase del centro de atención telefónica. | — |
cc_employees |
integer |
Número de empleados del centro. | — |
cc_sq_ft |
integer |
Superficie del centro en pies cuadrados. | — |
cc_hours |
char(20) |
Horario de apertura del centro. | — |
cc_manager |
varchar(40) |
Nombre del responsable del centro. | — |
cc_mkt_id |
integer |
Identificador del mercado. | — |
cc_mkt_class |
char(50) |
Descripción de la clase de mercado del centro. | — |
cc_mkt_desc |
varchar(100) |
Descripción del mercado. | — |
cc_market_manager |
varchar(40) |
Nombre del responsable de mercado del centro. | — |
cc_division |
integer |
División de la empresa a la que pertenece el centro. | — |
cc_division_name |
varchar(50) |
Nombre de la división. | — |
cc_company |
integer |
Identificador de la empresa que opera el centro. | — |
cc_company_name |
char(50) |
Nombre de la empresa. | — |
cc_street_number |
char(10) |
Número de la vía. | — |
cc_street_name |
varchar(60) |
Nombre de la vía. | — |
cc_street_type |
char(15) |
Tipo de vía de la dirección del centro. | — |
cc_suite_number |
char(10) |
Número de local o suite. | — |
cc_city |
varchar(60) |
Municipio asignado desde el INE. | — |
cc_county |
varchar(30) |
Provincia según el INE. | — |
cc_state |
char(2) |
Código INE de provincia. | — |
cc_zip |
char(10) |
Código postal del centro. | — |
cc_country |
varchar(20) |
País fijado a España tras el cruce. |
— |
cc_gmt_offset |
decimal(5,2) |
Desplazamiento horario del centro respecto de GMT. | — |
cc_tax_percentage |
decimal(5,2) |
Porcentaje de impuesto aplicado por el centro. | — |
catalog_page
Representa las páginas de los catálogos comerciales y su departamento, número de catálogo, página, descripción y tipo.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
cp_catalog_page_sk |
bigint |
Clave surrogate que identifica la página del catálogo. | PK |
cp_catalog_page_id |
char(16) |
Identificador de negocio de página de catálogo. | BK |
cp_start_date_sk |
integer |
Fecha de inicio de vigencia de la página. | FK → date_dim.d_date_sk |
cp_end_date_sk |
integer |
Fecha de fin de vigencia de la página. | FK → date_dim.d_date_sk |
cp_department |
varchar(50) |
Departamento al que pertenece la página. | — |
cp_catalog_number |
integer |
Número del catálogo. | — |
cp_catalog_page_number |
integer |
Número de la página dentro del catálogo. | — |
cp_description |
varchar(100) |
Descripción de la página. | — |
cp_type |
varchar(100) |
Tipo de página. | — |
promotion
Describe promociones, periodo de aplicación, producto, coste, canales publicitarios, propósito y si el descuento está activo.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
p_promo_sk |
bigint |
Clave surrogate que identifica la promoción. | PK |
p_promo_id |
char(16) |
Identificador de negocio de promoción. | BK |
p_start_date_sk |
bigint |
Fecha de inicio de la promoción. | FK → date_dim.d_date_sk |
p_end_date_sk |
bigint |
Fecha de fin de la promoción. | FK → date_dim.d_date_sk |
p_item_sk |
bigint |
Producto promocionado. | FK → item.i_item_sk |
p_cost |
decimal(15,2) |
Coste de la promoción. | — |
p_response_targe |
integer |
Objetivo de respuesta de la promoción. | — |
p_promo_name |
char(50) |
Nombre de la promoción. | — |
p_channel_dmail |
char(1) |
Indicador de uso del canal de correo postal. | — |
p_channel_email |
char(1) |
Indicador de uso del canal de correo electrónico. | — |
p_channel_catalog |
char(1) |
Indicador de uso del canal de catálogo. | — |
p_channel_tv |
char(1) |
Indicador de uso del canal de televisión. | — |
p_channel_radio |
char(1) |
Indicador de uso del canal de radio. | — |
p_channel_press |
char(1) |
Indicador de uso del canal de prensa. | — |
p_channel_event |
char(1) |
Indicador de uso del canal de eventos. | — |
p_channel_demo |
char(1) |
Indicador de uso del canal de demostraciones. | — |
p_channel_details |
varchar(100) |
Detalles de los canales utilizados. | — |
p_purpose |
char(15) |
Finalidad de la promoción. | — |
p_discount_active |
char(1) |
Indicador de descuento activo. | — |
El nombre p_response_targe también forma parte del esquema generado y debe
conservarse al escribir SQL contra esta tabla.
reason
Es un diccionario pequeño de motivos, utilizado sobre todo por las tablas de devoluciones.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
r_reason_sk |
bigint |
Clave surrogate que identifica el motivo. | PK |
r_reason_id |
char(16) |
Identificador de negocio del motivo. | BK |
r_reason_desc |
char(100) |
Descripción del motivo. | — |
ship_mode
Describe los modos de transporte, su código, transportista y contrato.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
sm_ship_mode_sk |
bigint |
Clave surrogate que identifica el modo de envío. | PK |
sm_ship_mode_id |
char(16) |
Identificador de negocio del modo de envío. | BK |
sm_type |
char(30) |
Tipo de modo de envío. | — |
sm_code |
char(10) |
Código del modo de envío. | — |
sm_carrier |
char(20) |
Transportista responsable del modo de envío. | — |
sm_contract |
char(20) |
Contrato asociado al modo de envío. | — |
web_page
Describe páginas de la web, sus fechas, URL, tipo y características de contenido y publicidad.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
wp_web_page_sk |
bigint |
Clave surrogate que identifica la página web. | PK |
wp_web_page_id |
char(16) |
Identificador de negocio de la página web. | BK |
wp_rec_start_date |
date |
Fecha de inicio de vigencia de esta versión del registro. | — |
wp_rec_end_date |
date |
Fecha de fin de vigencia de esta versión del registro; vacía en la versión vigente. | — |
wp_creation_date_sk |
integer |
Fecha de creación de la página. | FK → date_dim.d_date_sk |
wp_access_date_sk |
integer |
Fecha del último acceso a la página. | FK → date_dim.d_date_sk |
wp_autogen_flag |
char(1) |
Indicador de página generada automáticamente. | — |
wp_customer_sk |
bigint |
Cliente al que está asociada la página. | FK → customer.c_customer_sk |
wp_url |
varchar(100) |
URL de la página. | — |
wp_type |
char(50) |
Tipo de página. | — |
wp_char_count |
integer |
Número de caracteres de la página. | — |
wp_link_count |
integer |
Número de enlaces de la página. | — |
wp_image_count |
integer |
Número de imágenes de la página. | — |
wp_max_ad_count |
integer |
Número máximo de anuncios de la página. | — |
web_site
Describe los sitios web y su empresa, dirección, mercado y fechas de apertura y cierre.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
web_site_sk |
bigint |
Clave surrogate que identifica el sitio web. | PK |
web_site_id |
char(16) |
Identificador de negocio del sitio web. | BK |
web_rec_start_date |
date |
Fecha de inicio de vigencia de esta versión del registro. | — |
web_rec_end_date |
date |
Fecha de fin de vigencia de esta versión del registro; vacía en la versión vigente. | — |
web_name |
char(50) |
Nombre del sitio web. | — |
web_open_date_sk |
bigint |
Fecha de apertura del sitio web. | FK → date_dim.d_date_sk |
web_close_date_sk |
bigint |
Fecha de cierre del sitio web. | FK → date_dim.d_date_sk |
web_class |
varchar(50) |
Clase del sitio web. | — |
web_manager |
varchar(40) |
Nombre del responsable del sitio web. | — |
web_mkt_id |
integer |
Identificador del mercado. | — |
web_mkt_class |
varchar(50) |
Descripción de la clase de mercado del sitio web. | — |
web_mkt_desc |
varchar(100) |
Descripción del mercado. | — |
web_market_manager |
varchar(40) |
Nombre del responsable de mercado del sitio web. | — |
web_company_id |
integer |
Identificador de la empresa. | — |
web_company_name |
varchar(50) |
Nombre de la empresa. | — |
web_street_number |
varchar(10) |
Número de la vía. | — |
web_street_name |
varchar(60) |
Nombre de la vía. | — |
web_street_type |
char(15) |
Tipo de vía de la dirección del sitio web. | — |
web_suite_number |
char(10) |
Número de local o suite. | — |
web_city |
varchar(60) |
Municipio asignado desde el INE. | — |
web_county |
varchar(30) |
Provincia según el INE. | — |
web_state |
char(2) |
Código INE de provincia. | — |
web_zip |
char(10) |
Código postal del sitio web. | — |
web_country |
varchar(20) |
País fijado a España tras el cruce. |
— |
web_gmt_offset |
decimal(5,2) |
Desplazamiento horario del sitio respecto de GMT. | — |
web_tax_percentage |
decimal(5,2) |
Porcentaje de impuesto aplicado por el sitio web. | — |
Tablas de hechos
Las tablas de hechos representan acontecimientos o estados medibles. Suelen
tener muchas filas y muchas claves hacia dimensiones. Las columnas
_quantity, _price, _amount, _cost y _profit son buenos candidatos
para agregaciones.
store_sales
Contiene ventas realizadas en tiendas. Enlaza la fecha, hora, producto, cliente, domicilio, tienda y promoción con cantidades, precios, impuestos y beneficio.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
ss_sold_date_sk |
bigint |
Fecha de la venta. | FK → date_dim.d_date_sk |
ss_sold_time_sk |
bigint |
Hora de la venta. | FK → time_dim.t_time_sk |
ss_item_sk |
bigint |
Producto vendido; con ss_ticket_number forma la clave primaria. |
PK (1/2); FK → item.i_item_sk |
ss_customer_sk |
bigint |
Cliente que hace la compra. | FK → customer.c_customer_sk |
ss_cdemo_sk |
bigint |
Perfil demográfico del cliente. | FK → customer_demographics.cd_demo_sk |
ss_hdemo_sk |
bigint |
Perfil del hogar del cliente. | FK → household_demographics.hd_demo_sk |
ss_addr_sk |
bigint |
Dirección del cliente. | FK → customer_address.ca_address_sk |
ss_store_sk |
bigint |
Tienda en la que se hace la venta. | FK → store.s_store_sk |
ss_promo_sk |
bigint |
Promoción aplicada a la venta. | FK → promotion.p_promo_sk |
ss_ticket_number |
bigint |
Número de ticket; con ss_item_sk forma la clave primaria. |
PK (2/2) |
ss_quantity |
integer |
Cantidad de unidades vendidas. | — |
ss_wholesale_cost |
decimal(7,2) |
Coste mayorista por unidad. | — |
ss_list_price |
decimal(7,2) |
Precio de catálogo por unidad. | — |
ss_sales_price |
decimal(7,2) |
Precio de venta por unidad. | — |
ss_ext_discount_amt |
decimal(7,2) |
Importe extendido del descuento aplicado. | — |
ss_ext_sales_price |
decimal(7,2) |
Importe extendido de la venta antes de descuentos e impuestos. | — |
ss_ext_wholesale_cost |
decimal(7,2) |
Coste mayorista extendido de los productos vendidos. | — |
ss_ext_list_price |
decimal(7,2) |
Precio de lista extendido de los productos vendidos. | — |
ss_ext_tax |
decimal(7,2) |
Impuesto extendido de la venta. | — |
ss_coupon_amt |
decimal(7,2) |
Importe total de los cupones aplicados. | — |
ss_net_paid |
decimal(7,2) |
Importe neto pagado por la venta. | — |
ss_net_paid_inc_tax |
decimal(7,2) |
Importe neto pagado incluyendo impuestos. | — |
ss_net_profit |
decimal(7,2) |
Beneficio neto de la venta. | — |
catalog_sales
Contiene ventas realizadas mediante catálogo. Tiene relaciones con cliente, domicilios de facturación y envío, centro de llamadas, página del catálogo, modo de envío, almacén, producto y promoción.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
cs_sold_date_sk |
bigint |
Fecha de la venta. | FK → date_dim.d_date_sk |
cs_sold_time_sk |
bigint |
Hora de la venta. | FK → time_dim.t_time_sk |
cs_ship_date_sk |
bigint |
Fecha de envío del pedido. | FK → date_dim.d_date_sk |
cs_bill_customer_sk |
bigint |
Cliente al que se factura el pedido. | FK → customer.c_customer_sk |
cs_bill_cdemo_sk |
bigint |
Perfil demográfico del cliente al que se factura. | FK → customer_demographics.cd_demo_sk |
cs_bill_hdemo_sk |
bigint |
Perfil del hogar del cliente al que se factura. | FK → household_demographics.hd_demo_sk |
cs_bill_addr_sk |
bigint |
Dirección de facturación. | FK → customer_address.ca_address_sk |
cs_ship_customer_sk |
bigint |
Cliente que recibe el envío. | FK → customer.c_customer_sk |
cs_ship_cdemo_sk |
bigint |
Perfil demográfico del cliente que recibe el envío. | FK → customer_demographics.cd_demo_sk |
cs_ship_hdemo_sk |
bigint |
Perfil del hogar del cliente que recibe el envío. | FK → household_demographics.hd_demo_sk |
cs_ship_addr_sk |
bigint |
Dirección de envío. | FK → customer_address.ca_address_sk |
cs_call_center_sk |
bigint |
Centro de llamadas que tramitó el pedido. | FK → call_center.cc_call_center_sk |
cs_catalog_page_sk |
bigint |
Página del catálogo desde la que se hizo el pedido. | FK → catalog_page.cp_catalog_page_sk |
cs_ship_mode_sk |
bigint |
Modo de envío del pedido. | FK → ship_mode.sm_ship_mode_sk |
cs_warehouse_sk |
bigint |
Almacén desde el que se sirve el pedido. | FK → warehouse.w_warehouse_sk |
cs_item_sk |
bigint |
Producto vendido; con cs_order_number forma la clave primaria. |
PK (1/2); FK → item.i_item_sk |
cs_promo_sk |
bigint |
Promoción aplicada a la venta. | FK → promotion.p_promo_sk |
cs_order_number |
bigint |
Número de pedido; con cs_item_sk forma la clave primaria. |
PK (2/2) |
cs_quantity |
integer |
Cantidad de unidades vendidas. | — |
cs_wholesale_cost |
decimal(7,2) |
Coste mayorista por unidad. | — |
cs_list_price |
decimal(7,2) |
Precio de catálogo por unidad. | — |
cs_sales_price |
decimal(7,2) |
Precio de venta por unidad. | — |
cs_ext_discount_amt |
decimal(7,2) |
Importe extendido del descuento aplicado. | — |
cs_ext_sales_price |
decimal(7,2) |
Importe extendido de la venta antes de descuentos e impuestos. | — |
cs_ext_wholesale_cost |
decimal(7,2) |
Coste mayorista extendido de los productos vendidos. | — |
cs_ext_list_price |
decimal(7,2) |
Precio de lista extendido de los productos vendidos. | — |
cs_ext_tax |
decimal(7,2) |
Impuesto extendido de la venta. | — |
cs_coupon_amt |
decimal(7,2) |
Importe total de los cupones aplicados. | — |
cs_ext_ship_cost |
decimal(7,2) |
Coste extendido del envío del pedido. | — |
cs_net_paid |
decimal(7,2) |
Importe neto pagado por la venta. | — |
cs_net_paid_inc_tax |
decimal(7,2) |
Importe neto pagado incluyendo impuestos. | — |
cs_net_paid_inc_ship |
decimal(7,2) |
Importe neto pagado incluyendo el envío. | — |
cs_net_paid_inc_ship_tax |
decimal(7,2) |
Importe neto pagado incluyendo envío e impuestos. | — |
cs_net_profit |
decimal(7,2) |
Beneficio neto de la venta. | — |
web_sales
Contiene ventas web y conecta cada pedido con cliente, domicilio, página, sitio, modo de envío, almacén, producto y promoción.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
ws_sold_date_sk |
bigint |
Fecha de la venta. | FK → date_dim.d_date_sk |
ws_sold_time_sk |
bigint |
Hora de la venta. | FK → time_dim.t_time_sk |
ws_ship_date_sk |
bigint |
Fecha de envío del pedido. | FK → date_dim.d_date_sk |
ws_item_sk |
bigint |
Producto vendido; con ws_order_number forma la clave primaria. |
PK (1/2); FK → item.i_item_sk |
ws_bill_customer_sk |
bigint |
Cliente al que se factura el pedido. | FK → customer.c_customer_sk |
ws_bill_cdemo_sk |
bigint |
Perfil demográfico del cliente al que se factura. | FK → customer_demographics.cd_demo_sk |
ws_bill_hdemo_sk |
bigint |
Perfil del hogar del cliente al que se factura. | FK → household_demographics.hd_demo_sk |
ws_bill_addr_sk |
bigint |
Dirección de facturación. | FK → customer_address.ca_address_sk |
ws_ship_customer_sk |
bigint |
Cliente que recibe el envío. | FK → customer.c_customer_sk |
ws_ship_cdemo_sk |
bigint |
Perfil demográfico del cliente que recibe el envío. | FK → customer_demographics.cd_demo_sk |
ws_ship_hdemo_sk |
bigint |
Perfil del hogar del cliente que recibe el envío. | FK → household_demographics.hd_demo_sk |
ws_ship_addr_sk |
bigint |
Dirección de envío. | FK → customer_address.ca_address_sk |
ws_web_page_sk |
bigint |
Página web desde la que se hizo el pedido. | FK → web_page.wp_web_page_sk |
ws_web_site_sk |
bigint |
Sitio web en el que se hizo el pedido. | FK → web_site.web_site_sk |
ws_ship_mode_sk |
bigint |
Modo de envío del pedido. | FK → ship_mode.sm_ship_mode_sk |
ws_warehouse_sk |
bigint |
Almacén desde el que se sirve el pedido. | FK → warehouse.w_warehouse_sk |
ws_promo_sk |
bigint |
Promoción aplicada a la venta. | FK → promotion.p_promo_sk |
ws_order_number |
bigint |
Número de pedido; con ws_item_sk forma la clave primaria. |
PK (2/2) |
ws_quantity |
integer |
Cantidad de unidades vendidas. | — |
ws_wholesale_cost |
decimal(7,2) |
Coste mayorista por unidad. | — |
ws_list_price |
decimal(7,2) |
Precio de catálogo por unidad. | — |
ws_sales_price |
decimal(7,2) |
Precio de venta por unidad. | — |
ws_ext_discount_amt |
decimal(7,2) |
Importe extendido del descuento aplicado. | — |
ws_ext_sales_price |
decimal(7,2) |
Importe extendido de la venta antes de descuentos e impuestos. | — |
ws_ext_wholesale_cost |
decimal(7,2) |
Coste mayorista extendido de los productos vendidos. | — |
ws_ext_list_price |
decimal(7,2) |
Precio de lista extendido de los productos vendidos. | — |
ws_ext_tax |
decimal(7,2) |
Impuesto extendido de la venta. | — |
ws_coupon_amt |
decimal(7,2) |
Importe total de los cupones aplicados. | — |
ws_ext_ship_cost |
decimal(7,2) |
Coste extendido del envío del pedido. | — |
ws_net_paid |
decimal(7,2) |
Importe neto pagado por la venta. | — |
ws_net_paid_inc_tax |
decimal(7,2) |
Importe neto pagado incluyendo impuestos. | — |
ws_net_paid_inc_ship |
decimal(7,2) |
Importe neto pagado incluyendo el envío. | — |
ws_net_paid_inc_ship_tax |
decimal(7,2) |
Importe neto pagado incluyendo envío e impuestos. | — |
ws_net_profit |
decimal(7,2) |
Beneficio neto de la venta. | — |
store_returns
Registra devoluciones realizadas en tiendas, con cantidades, importes, impuestos, comisiones, gastos de envío y pérdida neta.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
sr_returned_date_sk |
bigint |
Fecha de la devolución. | FK → date_dim.d_date_sk |
sr_return_time_sk |
bigint |
Hora de la devolución. | FK → time_dim.t_time_sk |
sr_item_sk |
bigint |
Producto devuelto; con sr_ticket_number forma la clave primaria. |
PK (1/2); FK → item.i_item_sk; FK → store_sales.ss_item_sk |
sr_customer_sk |
bigint |
Cliente que hace la devolución. | FK → customer.c_customer_sk |
sr_cdemo_sk |
bigint |
Perfil demográfico del cliente. | FK → customer_demographics.cd_demo_sk |
sr_hdemo_sk |
bigint |
Perfil del hogar del cliente. | FK → household_demographics.hd_demo_sk |
sr_addr_sk |
bigint |
Dirección del cliente. | FK → customer_address.ca_address_sk |
sr_store_sk |
bigint |
Tienda en la que se hace la devolución. | FK → store.s_store_sk |
sr_reason_sk |
bigint |
Motivo de la devolución. | FK → reason.r_reason_sk |
sr_ticket_number |
bigint |
Número del ticket devuelto; con sr_item_sk forma la clave primaria. |
PK (2/2); FK → store_sales.ss_ticket_number |
sr_return_quantity |
integer |
Número de unidades devueltas. | — |
sr_return_amt |
decimal(7,2) |
Importe de la devolución. | — |
sr_return_tax |
decimal(7,2) |
Impuestos asociados a la devolución. | — |
sr_return_amt_inc_tax |
decimal(7,2) |
Importe de la devolución incluyendo impuestos. | — |
sr_fee |
decimal(7,2) |
Comisión cobrada por la devolución. | — |
sr_return_ship_cost |
decimal(7,2) |
Coste del envío de la devolución. | — |
sr_refunded_cash |
decimal(7,2) |
Importe devuelto en efectivo. | — |
sr_reversed_charge |
decimal(7,2) |
Importe de cargos revertidos. | — |
sr_store_credit |
decimal(7,2) |
Importe compensado mediante crédito de tienda. | — |
sr_net_loss |
decimal(7,2) |
Pérdida neta causada por la devolución. | — |
catalog_returns
Registra devoluciones de compras de catálogo y enlaza tanto al cliente que devuelve como al centro de llamadas, página, transporte, almacén y motivo.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
cr_returned_date_sk |
bigint |
Fecha de la devolución. | FK → date_dim.d_date_sk |
cr_returned_time_sk |
bigint |
Hora de la devolución. | FK → time_dim.t_time_sk |
cr_item_sk |
bigint |
Producto devuelto; con cr_order_number forma la clave primaria. |
PK (1/2); FK → item.i_item_sk; FK → catalog_sales.cs_item_sk |
cr_refunded_customer_sk |
bigint |
Cliente al que se reembolsa. | FK → customer.c_customer_sk |
cr_refunded_cdemo_sk |
bigint |
Perfil demográfico del cliente al que se reembolsa. | FK → customer_demographics.cd_demo_sk |
cr_refunded_hdemo_sk |
bigint |
Perfil del hogar del cliente al que se reembolsa. | FK → household_demographics.hd_demo_sk |
cr_refunded_addr_sk |
bigint |
Dirección del cliente al que se reembolsa. | FK → customer_address.ca_address_sk |
cr_returning_customer_sk |
bigint |
Cliente que devuelve el producto. | FK → customer.c_customer_sk |
cr_returning_cdemo_sk |
bigint |
Perfil demográfico del cliente que devuelve el producto. | FK → customer_demographics.cd_demo_sk |
cr_returning_hdemo_sk |
bigint |
Perfil del hogar del cliente que devuelve el producto. | FK → household_demographics.hd_demo_sk |
cr_returning_addr_sk |
bigint |
Dirección del cliente que devuelve el producto. | FK → customer_address.ca_address_sk |
cr_call_center_sk |
bigint |
Centro de llamadas que tramitó la devolución. | FK → call_center.cc_call_center_sk |
cr_catalog_page_sk |
bigint |
Página del catálogo del pedido devuelto. | FK → catalog_page.cp_catalog_page_sk |
cr_ship_mode_sk |
bigint |
Modo de envío de la devolución. | FK → ship_mode.sm_ship_mode_sk |
cr_warehouse_sk |
bigint |
Almacén que recibe la devolución. | FK → warehouse.w_warehouse_sk |
cr_reason_sk |
bigint |
Motivo de la devolución. | FK → reason.r_reason_sk |
cr_order_number |
bigint |
Número del pedido devuelto; con cr_item_sk forma la clave primaria. |
PK (2/2); FK → catalog_sales.cs_order_number |
cr_return_quantity |
integer |
Número de unidades devueltas. | — |
cr_return_amount |
decimal(7,2) |
Importe de la devolución. | — |
cr_return_tax |
decimal(7,2) |
Impuestos asociados a la devolución. | — |
cr_return_amt_inc_tax |
decimal(7,2) |
Importe de la devolución incluyendo impuestos. | — |
cr_fee |
decimal(7,2) |
Comisión cobrada por la devolución. | — |
cr_return_ship_cost |
decimal(7,2) |
Coste del envío de la devolución. | — |
cr_refunded_cash |
decimal(7,2) |
Importe devuelto en efectivo. | — |
cr_reversed_charge |
decimal(7,2) |
Importe de cargos revertidos. | — |
cr_store_credit |
decimal(7,2) |
Importe compensado mediante crédito de tienda. | — |
cr_net_loss |
decimal(7,2) |
Pérdida neta causada por la devolución. | — |
web_returns
Registra devoluciones de compras web y añade la página web y el motivo a las relaciones de cliente, domicilio, producto y pedido.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
wr_returned_date_sk |
bigint |
Fecha de la devolución. | FK → date_dim.d_date_sk |
wr_returned_time_sk |
bigint |
Hora de la devolución. | FK → time_dim.t_time_sk |
wr_item_sk |
bigint |
Producto devuelto; con wr_order_number forma la clave primaria. |
PK (1/2); FK → item.i_item_sk; FK → web_sales.ws_item_sk |
wr_refunded_customer_sk |
bigint |
Cliente al que se reembolsa. | FK → customer.c_customer_sk |
wr_refunded_cdemo_sk |
bigint |
Perfil demográfico del cliente al que se reembolsa. | FK → customer_demographics.cd_demo_sk |
wr_refunded_hdemo_sk |
bigint |
Perfil del hogar del cliente al que se reembolsa. | FK → household_demographics.hd_demo_sk |
wr_refunded_addr_sk |
bigint |
Dirección del cliente al que se reembolsa. | FK → customer_address.ca_address_sk |
wr_returning_customer_sk |
bigint |
Cliente que devuelve el producto. | FK → customer.c_customer_sk |
wr_returning_cdemo_sk |
bigint |
Perfil demográfico del cliente que devuelve el producto. | FK → customer_demographics.cd_demo_sk |
wr_returning_hdemo_sk |
bigint |
Perfil del hogar del cliente que devuelve el producto. | FK → household_demographics.hd_demo_sk |
wr_returning_addr_sk |
bigint |
Dirección del cliente que devuelve el producto. | FK → customer_address.ca_address_sk |
wr_web_page_sk |
bigint |
Página web desde la que se tramitó la devolución. | FK → web_page.wp_web_page_sk |
wr_reason_sk |
bigint |
Motivo de la devolución. | FK → reason.r_reason_sk |
wr_order_number |
bigint |
Número del pedido devuelto; con wr_item_sk forma la clave primaria. |
PK (2/2); FK → web_sales.ws_order_number |
wr_return_quantity |
integer |
Número de unidades devueltas. | — |
wr_return_amt |
decimal(7,2) |
Importe de la devolución. | — |
wr_return_tax |
decimal(7,2) |
Impuestos asociados a la devolución. | — |
wr_return_amt_inc_tax |
decimal(7,2) |
Importe de la devolución incluyendo impuestos. | — |
wr_fee |
decimal(7,2) |
Comisión cobrada por la devolución. | — |
wr_return_ship_cost |
decimal(7,2) |
Coste del envío de la devolución. | — |
wr_refunded_cash |
decimal(7,2) |
Importe devuelto en efectivo. | — |
wr_reversed_charge |
decimal(7,2) |
Importe de cargos revertidos. | — |
wr_account_credit |
decimal(7,2) |
Importe compensado mediante crédito en cuenta. | — |
wr_net_loss |
decimal(7,2) |
Pérdida neta causada por la devolución. | — |
inventory
Representa el inventario diario de cada producto en cada almacén. Es una tabla especialmente útil para observar el tamaño de SF1: combina fechas, productos y almacenes con la cantidad disponible.
| Columna | Tipo | Descripción | Clave / relación |
|---|---|---|---|
inv_date_sk |
bigint |
Fecha del recuento; con el producto y el almacén forma la clave primaria. | PK (1/3); FK → date_dim.d_date_sk |
inv_item_sk |
bigint |
Producto inventariado; con la fecha y el almacén forma la clave primaria. | PK (2/3); FK → item.i_item_sk |
inv_warehouse_sk |
bigint |
Almacén inventariado; con la fecha y el producto forma la clave primaria. | PK (3/3); FK → warehouse.w_warehouse_sk |
inv_quantity_on_hand |
integer |
Unidades disponibles en inventario. | — |