Bases de Datos a Gran Escala

Sesión 3 · Introducción a los sistemas NoSQL

Diego Sevilla Ruiz
Departamento de Ingeniería y Tecnología de Computadores
Facultad de Informática · Universidad de Murcia

dsevilla@um.es

Introducción a los sistemas NoSQL

Por qué surgieron, qué tienen en común y cuánto se usan

BDGE · Sesión 3 · Curso 2026/2027

Introducción a NoSQL. ¿Cómo surgió el nombre?

  • NoSQL → hashtag llamativo elegido para una conferencia en 2009 (Johan Oskarsson, de Last.fm)
  • Agrupa modelos diferentes del relacional, tradicionalmente con lenguajes de consulta propios
  • Más recientemente, NoSQL → Not Only SQL (no sólo SQL) → persistencia políglota (polyglot persistence)

BDGE · Sesión 3 · Curso 2026/2027

NoSQL

BDGE · Sesión 3 · Curso 2026/2027

NoSQL: ¿por qué se plantearon?

  1. Mayor escalabilidad horizontal
    • Datos y peticiones que desbordan un único servidor
    • Sistemas de alto volumen de escrituras (streaming de eventos, aplicaciones sociales)
  2. Demanda de productos de software libre (crecimiento de las start-ups)
  3. Patrones de acceso especializados: recuperar unidades completas sin recomponerlas con múltiples JOINs
  4. Expresividad, flexibilidad, dinamismo: frustración con las rigidez de las tablas normalizadas para ciertas aplicaciones
BDGE · Sesión 3 · Curso 2026/2027

El volumen de datos sigue creciendo

Datos estructurados y no estructurados generados al año, 2018–2028, en exabytes; IDC incluye los semiestructurados entre los no estructurados

Predominan los no estructurados; los estructurados crecen más en porcentaje

Fuente: IDC, septiembre de 2024 · figura 2
Volumen generado al año · Incluye semiestructurados · 2024–2028: previsión

BDGE · Sesión 3 · Curso 2026/2027

NoSQL: características

Diferencias tradicionales y generales respecto de los SGBDR:

  • Otros modelos y lenguajes de consulta, además del relacional y SQL
  • Diseño orientado a repartir los datos y crecer horizontalmente
  • En muchos sistemas, estructura flexible sin declarar todas las columnas
  • Operaciones atómicas sobre una clave o agregado, evitando coordinar muchas entidades
  • Accesos previstos influyen más en la forma de organizar los datos

Son tendencias de diseño: veremos excepciones y la convergencia posterior con SQL

BDGE · Sesión 3 · Curso 2026/2027

Categorías de NoSQL

  • Bases de datos key-value
  • Bases de datos documentales
  • Bases de datos columnares (wide column)
  • Bases de datos de grafos
  • Bases de datos de arrays
BDGE · Sesión 3 · Curso 2026/2027

Evolución desde el modelo relacional

  • El modelo relacional ⇒ predominante desde hace décadas
  • Tiene sus raíces en el denominado business data processing, procesamiento de transacciones y batch
  • Propuesto por Codd en los 70, de alto nivel
  • Actualmente los sistemas SQL están muy optimizados:
    • El grado de implantación es mayoritario
    • Para la gran mayoría de los problemas (que caben en un ordenador) es eficiente y adecuado
BDGE · Sesión 3 · Curso 2026/2027

Adopción de NoSQL

Twitter adopta Cassandra hacia 2010. Cassandra, publicada por Facebook en 2008

BDGE · Sesión 3 · Curso 2026/2027

Adopción NoSQL (septiembre 2020)

https://db-engines.com/en/ranking/

BDGE · Sesión 3 · Curso 2026/2027

Adopción NoSQL: cómo leer estas imágenes

  • La captura anterior corresponde a septiembre de 2020: es contexto histórico
  • DB-Engines combina indicadores de popularidad, no mide cuota de instalaciones ni rendimiento
  • Conviven grandes SGBDR y productos documentales, de clave-valor y de grafos
  • La posición en un ranking no decide qué sistema resuelve mejor una aplicación

Fuente: metodología de DB-Engines

BDGE · Sesión 3 · Curso 2026/2027

La importancia de la escalabilidad

Del servidor único a un gran array repartido y replicado entre nodos

BDGE · Sesión 3 · Curso 2026/2027

Cambio de perspectiva: red

BDGE · Sesión 3 · Curso 2026/2027

Cambio de perspectiva: red

Almacenamiento distribuido

  • Desde los años 90: clústers/NOC/COW — procesamiento masivamente paralelo
  • Sin embargo... ese procesamiento asumía almacenamiento no distribuido
  • Ahora los nodos ⇒ también almacenamiento
  • Reducir un coste importante: el trasiego de información por la red
BDGE · Sesión 3 · Curso 2026/2027

Cambio de perspectiva: red

Procesamiento distribuido

  • Necesidad de paralelización máxima
  • Escalabilidad
  • Explotar la localidad de los datos:
    • Los datos producidos se utilizan localmente en las siguientes iteraciones
    • Los datos recibidos llegan directamente a los hosts (clientes simultáneos)
BDGE · Sesión 3 · Curso 2026/2027

Cambio de perspectiva: red

Procesamiento distribuido (ii)

  • Procesar partes independientes en paralelo (p. ej. Map-Reduce)
  • Almacenamiento distribuido: cada nodo guarda parte de los datos
  • Coordinación: localizar los datos y gestionar fallos de nodos
BDGE · Sesión 3 · Curso 2026/2027

Cambio de perspectiva: red

Modelo de datos

  • El modelo relacional clásico descompone los datos en tablas y referencias primary key/foreign key
  • En programación se utilizan listas, arrays, tipos de datos compuestos (gap semántico)
  • Una transacción entre nodos exige coordinación; algunas aplicaciones pueden limitar lo que cambia junto
BDGE · Sesión 3 · Curso 2026/2027

Cambio de perspectiva: red

Modelo de datos (ii)

¿Y si se pudiera ver como un gran array asociativo: clave → información?

  • La clave decide qué nodo almacena cada elemento
  • Acceso directo por clave, con índices locales según el motor
  • Se pueden descartar lecturas innecesarias (p. ej. filtros de Bloom)
  • Uso de objetos complejos (p. ej. documentos JSON), para mantener la localidad espacial de datos relacionados (más adelante)
  • Idea inicial: la transacción se limita al objeto complejo
BDGE · Sesión 3 · Curso 2026/2027

El gran array se reparte y se replica

BDGE · Sesión 3 · Curso 2026/2027

Particionado y replicación: dos decisiones

  • Particionar reparte elementos distintos entre grupos de nodos: aumenta la capacidad
  • Replicar mantiene varias copias de cada partición: ayuda a soportar fallos
  • Una búsqueda por clave puede dirigirse a su grupo; una consulta global puede necesitar varios
  • Añadir nodos no evita una clave muy solicitada ni una distribución desigual
  • Mantener copias añade otra decisión: cuándo una escritura se considera confirmada

En la sesión 4 veremos el reparto y la replicación en MongoDB; en la 5, el reparto de Cassandra

BDGE · Sesión 3 · Curso 2026/2027

El agregado: una unidad de información

  • El valor del gran array puede ser un objeto complejo: un perfil, una pregunta con comentarios o un CV
  • Un agregado reúne los datos que suelen leerse y cambiar juntos
  • Una clave permite recuperar el conjunto sin recomponerlo con varias tablas
  • El agregado es la unidad natural de acceso, distribución y atomicidad en muchos diseños NoSQL

Elegir qué se guarda junto es elegir el alcance de la operación local

BDGE · Sesión 3 · Curso 2026/2027

El CV como unidad de información

El CV de Bill Gates y su representación en varias tablas relacionadas

Kleppmann, 2017. Designing Data-Intensive Applications

BDGE · Sesión 3 · Curso 2026/2027

Referencias entre los grandes arrays

usuarios[1] → { nombre: "Ana", reputación: 250 }
preguntas[10] → { título: "...", usuario: 1 }
preguntas[11] → { título: "...", usuario: 1 }
  • usuario: 1 apunta a otra clave, como la clave ajena que conocemos de SQL
  • Referenciar no implica que el servidor compruebe la existencia del usuario ni aplique un borrado en cascada
  • La aplicación puede seguir la referencia; un producto también puede ofrecer una unión
  • Incrustar el perfil evita esa búsqueda, pero duplica datos si el usuario tiene varias preguntas
BDGE · Sesión 3 · Curso 2026/2027

Schemaless

Insertar sin declarar antes el esquema: quién lo comprueba y cuándo

BDGE · Sesión 3 · Curso 2026/2027

Schemaless

  • Muchos sistemas NoSQL no exigen declarar un esquema completo antes de insertar
  • Flexibilidad: posibilidad de almacenar entidades con una estructura diferente
    • Tratar información incompleta
    • Evolucionar la base de datos/esquema
    • Añadir nuevas características a las aplicaciones

El código sigue esperando campos y tipos: flexibilidad no significa ausencia de modelo

BDGE · Sesión 3 · Curso 2026/2027

Schema-on-write frente a schema-on-read

Comparación tradicional y general, por analogía con los lenguajes estáticos y dinámicos:

Schema-on-write (SQL) Schema-on-read (NoSQL)
Cuándo Los datos conforman al esquema al escribir Los datos leídos conforman a un esquema implícito
Tipado (analogía) Estricto (estático) Duck typing (dinámico)
Datos Homogéneos Heterogéneos
Proceso Analítico, a través de consultas Use as read: usar los datos conforme se leen

Duck typing: el lector utiliza los campos que necesita, si están presentes y tienen tipos compatibles

BDGE · Sesión 3 · Curso 2026/2027

Schemaless: convivir con dos versiones

// Documento anterior: el campo no existe
{ _id: 1, nombre: "Ana" }
// Documento nuevo: el usuario ha indicado una preferencia
{ _id: 2, nombre: "Luis", idioma: "es" }
idioma: str | None = user.get("idioma", "es")
  • Los documentos nuevos incorporan el campo sin reescribir los anteriores
  • Hay que distinguir campo ausente, null (None en Python) y valor no válido
  • get devuelve "es" si falta la clave; si existe con valor None, conserva None
BDGE · Sesión 3 · Curso 2026/2027

Schemaless: el mismo cambio en SQL

ALTER TABLE users ADD COLUMN idioma VARCHAR(10) NULL;
UPDATE users SET idioma = 'es' WHERE idioma IS NULL;
  • En tablas grandes, añadir la columna y rellenar los valores puede ser muy costoso
  • La migración modifica muchas filas y puede mantener la tabla bloqueada
BDGE · Sesión 3 · Curso 2026/2027

¿Cuándo es apropiado schemaless?

  • Objetos heterogéneos
  • Estructura de los datos impuesta externamente
  • Si intuimos que los datos cambiarán en el futuro
BDGE · Sesión 3 · Curso 2026/2027

¿Dónde se comprueba el esquema?

  • En SQL, columnas, tipos y restricciones forman parte del esquema del servidor
  • En un almacén clave-valor, el servidor puede tratar el valor como opaco: lo interpreta la aplicación
  • En MongoDB, el uso habitual permite insertar documentos sin declarar toda su estructura
  • Si se necesita, un ODM como Mongoose o el propio servidor pueden validar campos
  • En Cassandra CQL se declaran columnas y tipos, aunque una fila pueda no guardar todas las celdas

Al flexibilizar el esquema, parte de la responsabilidad pasa a quien escribe y lee los datos

BDGE · Sesión 3 · Curso 2026/2027

Modelado: qué se agrega y qué se referencia

Relaciones entre agregados: incrustar o apuntar a otra clave

BDGE · Sesión 3 · Curso 2026/2027

Modelado de datos en NoSQL

El modelado de datos debe ser:

  • Realizado al mayor nivel de abstracción posible
  • Independiente de la tecnología subyacente

Sin embargo, en NoSQL:

  • Siempre se tiene que tener en cuenta el diseño distribuido
  • Optimización y organización guiada por las consultas
BDGE · Sesión 3 · Curso 2026/2027

Modelado de datos en NoSQL (ii)

Con respecto al modelo de datos:

  • Se mantienen los conceptos de entidad, relación, cardinalidades, etc.
  • El modelado relacional se centra en especificar qué datos tenemos y podemos ofrecer
  • El modelo NoSQL se centra en optimizar qué consultas vamos a servir
  • Puede compensar duplicar (desnormalizar) datos para optimizar accesos, a cambio de mantener coherentes las copias
  • Agregar o referenciar —la decisión que planteamos en la sesión 1— según qué consultas queramos tener optimizadas
BDGE · Sesión 3 · Curso 2026/2027

Representación de relaciones: modelo de documentos

  • Modelo de documentos → analogía del array/mapa gigante
  • Conjunto de documentos (objetos complejos):
    • Un identificador único, campo id
    • Búsqueda aleatoria eficiente por clave (referencia)
    • Estructura jerárquica de subdocumentos contenidos → agregación

Frente a las tablas normalizadas, el documento permite elegir qué relaciones se agregan y cuáles se referencian

BDGE · Sesión 3 · Curso 2026/2027

Uno a muchos: agregar o referenciar

Una pregunta tiene varios comentarios:

  • Agregar: guardar los comentarios dentro de la pregunta
  • Referenciar: guardar cada comentario con la clave de su pregunta

Si se leen juntos, un agregado evita recomponer el hilo

Si crecen sin límite, se actualizan de forma independiente o se consultan por separado, las referencias pueden encajar mejor

Son los conceptos de entidad y cardinalidad de SQL, pero con otras restricciones de diseño

BDGE · Sesión 3 · Curso 2026/2027

Una pregunta y sus comentarios

La misma pregunta de Stack Overflow y sus comentarios, separados en tablas con PostId o incrustados en un documento

BDGE · Sesión 3 · Curso 2026/2027

Uno a muchos: leer y modificar

Operación Separar y referenciar Agregar en el documento
Mostrar la pregunta y sus comentarios Recuperar la pregunta y sus comentarios por PostId Recuperar un documento con el conjunto
Añadir un comentario Insertar otra fila o documento con PostId: 10 Añadir un elemento al array de comentarios de la pregunta 10
Consultar comentarios de muchas preguntas Consultar la tabla o colección de comentarios Buscar dentro de los arrays de las preguntas

La relación sigue siendo uno a muchos; cambia dónde se guarda y qué unidad se lee o modifica

BDGE · Sesión 3 · Curso 2026/2027

Muchos a uno y muchos a muchos

  • Muchos a uno: varios perfiles pueden apuntar a una misma región
  • Muchos a muchos: un post puede tener varios tags y un tag aparecer en varios posts
  • Si una entidad compartida tiene identidad propia, referenciar su id evita duplicarla y facilita sus cambios
  • Seguir la referencia puede exigir otra petición; algunos productos ofrecen uniones, como $lookup en MongoDB
BDGE · Sesión 3 · Curso 2026/2027

Posts y tags: ¿desde qué clave buscamos?

Dos colecciones alternativas para las mismas asociaciones: cada post con su ID, título y tags; cada tag con su ID y lista de IDs de posts

BDGE · Sesión 3 · Curso 2026/2027

Posts y tags: elegir qué guardar

Si necesitamos... Podemos guardar... Consecuencia
Tags de un post Documento en posts con _id: 10 y tags: [...] Para hallar posts con sql hace falta otro acceso o índice
Posts de un tag Documento en tags con _id: "sql" y posts: [...] La lista puede crecer mucho; sólo contiene IDs
Consultar en ambos sentidos Ambas colecciones Cada asociación se escribe dos veces y hay que mantenerlas coherentes

Son dos construcciones para las mismas asociaciones; las consultas determinan si conviene mantener una o ambas

BDGE · Sesión 3 · Curso 2026/2027

Agregar también tiene límites

  • Si el agregado crece sin límite, leerlo o actualizarlo puede resultar costoso
  • Incrustar datos compartidos evita búsquedas, pero obliga a actualizar varias copias
  • Referenciar mantiene una identidad común; seguir la referencia puede requerir otra petición
  • Si dos agregados deben cambiar juntos, hace falta coordinación adicional (transacciones multidocumento)

La decisión se toma con las cardinalidades y los accesos que conocemos, no sólo con el formato JSON

BDGE · Sesión 3 · Curso 2026/2027

Map-Reduce

De las funciones map y reduce a las consultas sobre datos repartidos

BDGE · Sesión 3 · Curso 2026/2027

Map-Reduce

Origen en lenguajes funcionales:

  • map(): ejecuta una misma función sobre todos los elementos de un conjunto
  • reduce(): sumariza un conjunto de valores para producir un valor de salida
BDGE · Sesión 3 · Curso 2026/2027

Map-Reduce: combinando ambas operaciones

  • Una misma operación map() sobre cada dato residente en un nodo se realiza en paralelo en todos los nodos simultáneamente
  • Con los resultados parciales, una función reduce() genera el resultado final
  • Proceso intermedio de shuffle, para agrupar valores con la misma clave antes del reduce()
  • Resultados parciales en el mismo nodo (localidad) ⇒ procesamientos en cadena
BDGE · Sesión 3 · Curso 2026/2027

Map-Reduce — Word Count

http://www.milanor.net/blog/an-example-of-mapreduce-with-rmr2/

BDGE · Sesión 3 · Curso 2026/2027

Map-Reduce: particularidades

  • Se supone que los datos de entrada son siempre pares ⟨key,value⟩
  • La función map() produce otro conjunto de valores {⟨key1,value1⟩, ⟨key2,value2⟩, ...}
  • El shuffle agrupa los valores con la misma clave: {⟨key1,{val1,val3,...}⟩, ⟨key2,{val2,val4,...}⟩, ...}
  • reduce() procesa cada lista de valores con la misma clave, y produce otros elementos ⟨key',value'⟩
  • Hay procesamientos difíciles de expresar en Map-Reduce ⇒ operaciones M/R en cadena
  • El procesamiento distribuido se desarrolla en Tecnologías de Computación de Datos Masivos
BDGE · Sesión 3 · Curso 2026/2027

Map-Reduce y consultas

Map-Reduce puede usarse no sólo para computación distribuida, sino también como una generalización de consultas. Ejemplo: un biólogo marino anota cada animal que ve en el océano y quiere saber cuántos tiburones ha visto por mes:

SELECT YEAR(observation_timestamp) AS observation_year,
       MONTH(observation_timestamp) AS observation_month,
       sum(num_animals) AS total_animals
FROM observations
WHERE family = 'Sharks'
GROUP BY observation_year, observation_month;
BDGE · Sesión 3 · Curso 2026/2027

Map-Reduce y consultas (ii)

El mismo agrupamiento con el API histórico de MongoDB, deprecado desde 5.0:

db.observations.mapReduce(
  function map() {
    var year = this.observationTimestamp.getUTCFullYear();
    var month = this.observationTimestamp.getUTCMonth() + 1;
    emit(year + "-" + month, this.numAnimals);
  },
  function reduce(key, values) {
    return values.reduce((total, value) => total + value, 0);
  },
  {
    query: { family: "Sharks" },
    out: "monthlySharkReport"
  }
);
BDGE · Sesión 3 · Curso 2026/2027

Map-Reduce y consultas (iii)

Hoy se usa aggregate: $match filtra, $group elige la misma clave y $sum reduce los valores

db.observations.aggregate([
  { $match: { family: "Sharks" } },
  { $group: {
    _id: {
       year: { $year: "$observationTimestamp" },
       month: { $month: "$observationTimestamp" }
    },
    totalAnimals: { $sum: "$numAnimals" }
  }
  }
]);

La misma entrada debe producir los mismos totales por año y mes; en la sesión 4 seguiremos este pipeline etapa a etapa

BDGE · Sesión 3 · Curso 2026/2027

BDGE · Sesión 3 · Curso 2026/2027

Eficiencia raw

MongoDB frente a MySQL con los mismos datos y las mismas operaciones

BDGE · Sesión 3 · Curso 2026/2027

¿Es viable? La primera pregunta es la eficiencia

  • Hasta aquí hemos visto una forma distinta de guardar los datos: claves, agregados y estructura flexible
  • SQL ya existe y está muy optimizado: si el modelo nuevo fuese mucho más lento con los mismos datos, no sería viable, por mucha flexibilidad o distribución que ofreciera
  • Es una condición necesaria, no suficiente: no demuestra que sea mejor, sólo que no tiene un precio de entrada en rendimiento
  • Lo comprobamos con la misma carga en MySQL y en MongoDB

Primero, ¿pierde frente a SQL? Después, ¿qué ventajas compensan sus compromisos?

BDGE · Sesión 3 · Curso 2026/2027

Rendimiento: comparar operaciones completas

  • Comparamos MySQL y MongoDB sobre el mismo millón de medidas de sensores
  • Un solo cliente genera los mismos datos y mide operaciones completas en segundos
  • Se comprueban filas iniciales, cambios, borrados, suma de lecturas y los cinco resultados del intervalo
  • Un calentamiento y tres repeticiones: se muestran mediana y rango
  • Dos servidores locales de un nodo: no es una prueba de escalabilidad distribuida

Código y resultados: bdge/addendum/mysql_vs_mongo/

BDGE · Sesión 3 · Curso 2026/2027

Rendimiento: qué se está midiendo

  • MySQL 8 y MongoDB 8.3, con el mismo límite por servidor: 2 CPU y 2 GiB
  • Carga por lotes de 5.000, sin incluir la generación de datos en el cronómetro
  • Índice en la fecha; mismos rangos y orden de operaciones en ambos productos
  • COUNT(*) y count_documents: recuentos exactos, no estimaciones de metadatos
  • La consulta de intervalo recibe los cinco resultados antes de detener el tiempo
  • Escrituras confirmadas con persistencia de diario; la atomicidad sigue siendo distinta en ambos modelos
BDGE · Sesión 3 · Curso 2026/2027

Eficiencia raw: las seis pruebas

  1. Insertar un millón de elementos deterministas, con fechas que permitan la búsqueda por rango (Fill)
  2. Crear un índice en la tabla para la fecha de la lectura (Index)
  3. Actualizar los valores de un conjunto de entradas seleccionadas por rango de fechas (Update)
  4. Eliminar un conjunto de filas seleccionadas por rango de fechas (Delete)
  5. Obtener el número de filas restantes (Count)
  6. Obtener cinco registros ordenados por fecha, tras saltar veinte, con el mismo filtro (Interval)
BDGE · Sesión 3 · Curso 2026/2027

BDGE · Sesión 3 · Curso 2026/2027

Rendimiento: interpretar el gráfico

  • El eje Y es logarítmico: distancias iguales representan factores iguales
  • Las barras son medianas; los segmentos muestran el mínimo y máximo observados
  • Se comparan operaciones concretas, con estas versiones y esta configuración
  • La carga incluye cliente, envío, almacenamiento y confirmación; no mide sólo el motor
  • El resultado puede cambiar al variar índices, lotes, concurrencia y garantías

Antes de explicar una diferencia, comprobar que ambas operaciones hacen el mismo trabajo

BDGE · Sesión 3 · Curso 2026/2027

Rendimiento: ¿es viable?

  • Con la misma carga, ninguna operación queda órdenes de magnitud por detrás en MongoDB; la actualización es la única que favorece a MySQL
  • Respuesta a la pregunta de partida: el rendimiento no impide adoptar el modelo
  • Pero no lo justifica: es un solo nodo, así que la distribución, la otra mitad del argumento, sigue sin probarse
  • Para decidir hay que preguntar:
    • ¿Qué operaciones predominan: carga, actualización o lectura?
    • ¿Necesitamos una consulta global o recuperar un agregado por clave?
    • ¿Qué garantías necesitamos cuando fallan un nodo o la red?
    • ¿Cuánto cuesta mantener los índices y las copias de datos?

Superado el listón de la eficiencia, la elección depende del patrón de acceso: no hay un ganador universal

BDGE · Sesión 3 · Curso 2026/2027

Tipos de sistemas NoSQL

Clave-valor, documentos, familias de columnas, grafos y arrays

BDGE · Sesión 3 · Curso 2026/2027

Tipos de sistemas NoSQL

  • Las familias se distinguen por la estructura del valor y las operaciones que ofrece el servidor
  • Clave-valor: acceso por clave, con un valor generalmente opaco
  • Documentos: el servidor puede consultar campos y subdocumentos
  • Familias de columnas: acceso a filas o particiones y a sus celdas
  • Grafos: entidades y relaciones que se recorren
  • Arrays: operaciones sobre datos multidimensionales

Vamos a compararlas con las tablas y operaciones SQL que ya conocemos

BDGE · Sesión 3 · Curso 2026/2027

Key-Value Stores y documentales

  • Cada pieza de datos tiene asignado un identificador
  • La diferencia entre ambas es que:
    • En key-value, el valor es opaco: no se conoce nada de su interior (a todos los efectos es un blob de datos)
    • En las basadas en documentos, la base de datos puede ver el contenido del agregado, y utilizar su información como parte de las búsquedas y actualizaciones
  • Documentos ⇒ formatos jerárquicos tipo JSON o XML
BDGE · Sesión 3 · Curso 2026/2027

Clave-valor y documentos frente a SQL

Clave-valor Documentos
Unidad de acceso Valor completo por clave Documento; también filtros por campos
Estructura La interpreta principalmente el cliente La conoce y consulta el servidor
Referencias Otra clave, seguida por el cliente Otro documento; algunas BD permiten uniones
Frente a SQL Menos operaciones generales, acceso directo Agregados jerárquicos frente a tablas normalizadas

Ejemplos: Redis o LevelDB para clave-valor; MongoDB o Couchbase para documentos

BDGE · Sesión 3 · Curso 2026/2027

Key-value: a cada valor se llega por su clave

BDGE · Sesión 3 · Curso 2026/2027

Documentos: la base de datos ve el valor

BDGE · Sesión 3 · Curso 2026/2027

Almacenar por filas o por columnas

Los valores de cada fila aparecen unidos horizontalmente; a la derecha, cada columna ocupa una franja separada de valores consecutivos que continúa más allá del ejemplo

BDGE · Sesión 3 · Curso 2026/2027

Dos sentidos distintos de «columnar»

  • Columnar analítico: agrupa los valores de una misma columna de muchas filas
    • Permite leer sólo las columnas de un análisis y comprimir valores parecidos
    • No cambia necesariamente el modelo relacional ni el uso de SQL
  • Familias de columnas / wide-column: organiza celdas dentro de filas o particiones identificadas por clave
    • Agrupa datos relacionados, admite datos dispersos y favorece accesos por clave
    • HBase y Cassandra pertenecen a esta segunda familia

Comparten el interés por organizar celdas; no tienen la misma disposición física

BDGE · Sesión 3 · Curso 2026/2027

Familias de columnas: del gran array a las celdas

  • Influencia de Bigtable, Google, 2006
  • Cada clave identifica una fila o partición; dentro se accede a celdas por sus nombres
  • HBase: se declaran familias; cada fila puede tener columnas diferentes
  • Cassandra CQL: se declaran columnas y tipos; no todas las filas guardan todas las celdas
  • A diferencia de una tabla SQL normalizada, la clave se diseña para localizar y reunir lo que se consulta junto
  • El almacenamiento de Cassandra organiza filas por partición, no una columna completa de todas las filas
BDGE · Sesión 3 · Curso 2026/2027

Familias de columnas: el modelo de HBase

BDGE · Sesión 3 · Curso 2026/2027

Familias de columnas: las filas de Cassandra

BDGE · Sesión 3 · Curso 2026/2027

Bases de datos de grafos

  • Las bases de datos de grafos llevan el mecanismo muchos a muchos al extremo
  • Datos en los que existen muchas relaciones entre sí, con un significado primordial
  • Se basan en la construcción y consulta de grafos que constan de:
    • Vértices, también llamados nodos o entidades
    • Aristas (edges), también llamadas relaciones
  • Pueden capturar relaciones complejas entre entidades y ofrecen lenguajes de búsqueda, actualización y creación que permiten trabajar con subconjuntos del grafo
  • Ejemplos: Neo4j; OrientDB combina documentos y grafos
BDGE · Sesión 3 · Curso 2026/2027

BDGE · Sesión 3 · Curso 2026/2027

Grafos representados en SQL

Nota: usa la sintaxis PostgreSQL para json

CREATE TABLE vertices (
  vertex_id integer PRIMARY KEY,
  properties json
);

CREATE TABLE edges (
  edge_id integer PRIMARY KEY,
  tail_vertex integer REFERENCES vertices (vertex_id),
  head_vertex integer REFERENCES vertices (vertex_id),
  label text,
  properties json
);

CREATE INDEX edges_tails ON edges (tail_vertex);
CREATE INDEX edges_heads ON edges (head_vertex);
BDGE · Sesión 3 · Curso 2026/2027

Grafo y consulta en Neo4j

CREATE
  (NAmerica:Location {name:'North America', type:'continent'}),
  (USA:Location {name:'United States', type:'country' }),
  (Idaho:Location {name:'Idaho', type:'state' }),
  (Lucy:Person {name:'Lucy' }),
  (Europe:Location {name:'Europe', type:'continent'}),
  (Idaho)-[:WITHIN]->(USA)-[:WITHIN]-> (NAmerica),
  (Lucy)-[:BORN_IN]->(Idaho),
  (Lucy)-[:LIVES_IN]->(Europe)

Consulta:

MATCH
(person) -[:BORN_IN]-> () -[:WITHIN*0..]-> (us:Location {name:'United States'}),
(person) -[:LIVES_IN]-> () -[:WITHIN*0..]-> (eu:Location {name:'Europe'})
RETURN person.name
BDGE · Sesión 3 · Curso 2026/2027

Bases de datos basadas en arrays

  • Suelen presentarse como bases de datos que soportan SQL y añaden operaciones para trabajar con conjuntos de datos especiales (arrays)
  • Utilizadas para tratamiento de grandes cantidades de datos de forma estadística, de modelado y OLAP
  • Soportan también datos geográficos, ya que pueden definir rangos numéricos de una o varias dimensiones (2D para cálculos geográficos)
  • Ejemplos: SciDB, rasdaman
BDGE · Sesión 3 · Curso 2026/2027

Comparar y elegir

Qué queda de las diferencias y cómo combinar varios modelos

BDGE · Sesión 3 · Curso 2026/2027

SQL y NoSQL: ideas que convergen

Diferencia tradicional Hoy Dónde lo veremos
Tablas frente a objetos complejos Columnas JSON con consultas e índices en SQL Sesión 2
Esquema obligatorio frente a flexible Validación opcional en MongoDB; esquema declarado en CQL Sesiones 4 y 5
Transacción entre entidades frente a agregado Transacciones multidocumento en MongoDB Sesión 4
Un servidor frente a datos distribuidos Particionado de tablas en SQL; replicación y reparto en NoSQL Sesiones 2, 4 y 5
Lenguajes y accesos diferentes $lookup y planes de consulta en MongoDB; índices secundarios en Cassandra Sesiones 4 y 5

El modelo sigue importando: las capacidades se acercan, pero sus unidades naturales de acceso son distintas

BDGE · Sesión 3 · Curso 2026/2027

Elegir y combinar

  • Tres preguntas deciden: ¿qué consultas hay que optimizar?, ¿qué debe cambiar junto?, ¿cuánto cuesta operar el sistema?
  • En el foro: SQL para usuarios y votos, documentos para el hilo, clave-valor para sesiones y contadores, grafo para «quién responde a quién»
  • Persistencia políglota: cada parte con el modelo que le encaja
  • Combinar añade trabajo: sincronización, fallos parciales y mantenimiento

Seguimos con los documentos: es el modelo más cercano al hilo que acabamos de ver, y MongoDB lo lleva a un producto

Indiana Jones ante la elección del Grial, «Choose wisely»

BDGE · Sesión 3 · Curso 2026/2027

Figura 2 de IDC #US52554824e, septiembre de 2024, página 4 https://techcontentwave.com/files/1763389937_64b594fd4f7f5607256a.pdf Extracción del gráfico original, sin modificar sus valores ni su leyenda: pdftoppm -f 4 -l 4 -r 300 -x 225 -y 1810 -W 1530 -H 780 -singlefile -png informe.pdf teoria/img/data-growth-idc-2024 IDC agrupa los datos semiestructurados con los no estructurados Las empresas generan ambos tipos; "de empresa" no equivale a "estructurado"

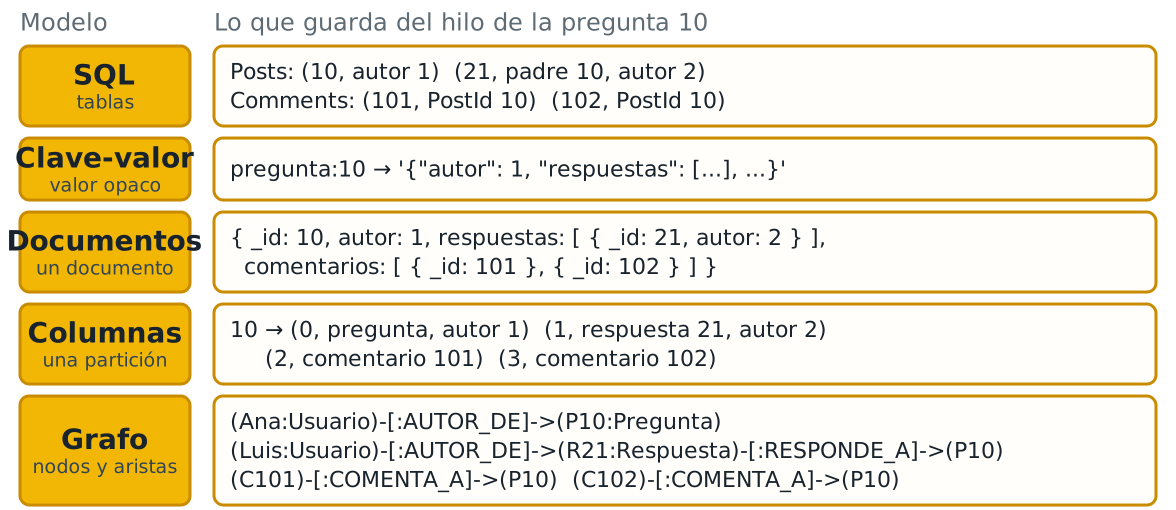
--- <!-- _class: compact -- > # El mismo problema, cinco modelos Ana (usuario 1) publica la pregunta 10; Luis (usuario 2) la responde con la respuesta 21; la pregunta recibe dos comentarios, el 101 y el 102 **Problema**: mostrar la pregunta con sus respuestas y comentarios Lo recorremos en cuatro pasos, con los cinco modelos delante: 1. **Qué guarda** cada uno del hilo 2. **Cómo se lee** el hilo completo 3. **Qué ocurre con una consulta nueva**: las respuestas de Luis 4. **Qué cuesta modificarlo**: Ana cambia su nombre y Luis añade otra respuesta Son diseños ilustrativos para comparar decisiones, no el esquema de los boletines --- <!-- _class: figure-only -- > # El mismo hilo en cinco representaciones ![Lo que guardan SQL, clave-valor, documentos, familia de columnas y grafo del hilo de la pregunta 10: la pregunta de Ana, la respuesta 21 de Luis y los comentarios 101 y 102 height:510px](img/fig-hilo.svg) --- <!-- _class: compact small-table -- > # Leer el hilo: una operación por modelo | Modelo | Operación | Trabajo | |---|---|---| | SQL | `SELECT * FROM Posts WHERE Id = 10 OR ParentId = 10`<br>`SELECT * FROM Comments WHERE PostId = 10` | Dos consultas, o una unión, apoyadas en índices por `ParentId` y `PostId` | | Clave-valor | `GET pregunta:10` | Un acceso: el cliente decodifica el valor | | Documentos | `db.preguntas.findOne({ _id: 10 })` | Un acceso: un documento con todo el hilo | | Columnas | `SELECT * FROM hilo WHERE pregunta_id = 10` | Una partición, leída en orden | | Grafo | `MATCH (x)-[:RESPONDE_A\|COMENTA_A]->(:Pregunta {id: 10}) RETURN x` | Un recorrido desde el nodo de la pregunta | > Todos leen el hilo; cambia cuántos accesos hacen y qué unidad devuelven --- <!-- _class: compact small-table -- > # Una consulta nueva: las respuestas de Luis | Modelo | Cómo se resuelve | Qué cuesta | |---|---|---| | SQL | `SELECT * FROM Posts WHERE OwnerUserId = 2 AND PostTypeId = 2` | Un índice por autor (sesión 2) | | Clave-valor | No hay acceso por contenido: recorrer todos los valores o mantener otra clave, `respuestas:2` | Una segunda estructura que mantiene la aplicación | | Documentos | `db.preguntas.find({ "respuestas.autor": 2 })` | Un índice sobre el *array* (sesión 4); devuelve preguntas completas | | Columnas | Otra tabla con otra clave de partición: `respuestas_por_autor` | Duplicar los datos y escribir en las dos tablas | | Grafo | `MATCH (:Usuario {nombre: 'Luis'})-[:AUTOR_DE]->(r:Respuesta) RETURN r` | Localizar el nodo de Luis; desde él se recorre | > Cada modelo deja **optimizado** un acceso; los demás se pagan con índices, copias o recorridos --- <!-- _class: compact -- > # Para discutir: modificar el mismo hilo Con las representaciones a la vista: 1. **Ana cambia su nombre.** El hilo sólo guarda `autor: 1`: ¿dónde vive el nombre en cada modelo? ¿Qué cambia si cada copia llevase el nombre? 2. **Luis añade una respuesta.** ¿Qué se escribe, y en cuántos sitios, en cada modelo? 3. **¿Qué parte de cada cambio es una sola operación atómica?** La contestaremos en la sesión 4 Razonamos sobre las consecuencias de unas representaciones ya dadas, sin inventar antes un esquema --- <!-- _class: compact small-table -- > # Qué cuesta modificar el hilo | Modelo | Ana cambia su nombre | Luis añade una respuesta | |---|---|---| | SQL | Una fila de `Users`; el hilo sólo guarda `OwnerUserId` | Un `INSERT` en `Posts` | | Clave-valor | Si el nombre está dentro del valor, la aplicación reescribe cada valor que lo contiene | La aplicación lee y reescribe el valor completo; con una lista de Redis, añade un elemento | | Documentos | Un documento si se referencia; tantos como copias si se incrusta | Un `$push` en `respuestas`: una sola operación atómica | | Columnas | Cada fila donde se copió; si no, una fila de la tabla de usuarios | Un `INSERT` en la partición 10, y otro en `respuestas_por_autor` si existe | | Grafo | Una propiedad del nodo de Ana | Un nodo y dos aristas, autoría y respuesta, en una transacción | > El coste de un cambio lo deciden las copias que hay y la unidad que es atómica; la sesión 4 lo concreta en MongoDB